
游戏 AI / 系统课时
记录一次生成为什么得到这个结果
记录一次生成为什么得到这个结果
生成式内容出问题时,单看最终文本往往找不到原因。要解释一次结果,至少要知道当时使用的提示词版本、模型版本、输入状态、耗时和输出摘要,并把这些信息绑定到同一个生成记录中,才能复现、调试和审计。
学习目标
- 能设计一次生成的最小可追踪记录
- 能用唯一请求 ID 关联输入、模型调用和结果
- 能区分可复现数据、审计数据与不应长期保存的敏感内容
一次生成需要记录什么
最小记录应回答五个问题:用的是什么提示词、什么模型、当时游戏处于什么状态、花了多久、最后产生了什么结果。因此可以记录 promptVersion、modelVersion、inputState、latencyMs 和 outputSummary,再补充 requestId、时间戳和执行状态。
inputState 不必无差别保存整个游戏存档。更实用的做法是记录真正参与生成决策的字段,例如区域 ID、任务 ID、战斗阶段、角色关系值和候选上下文版本。这样既能解释结果,也能控制日志体积。
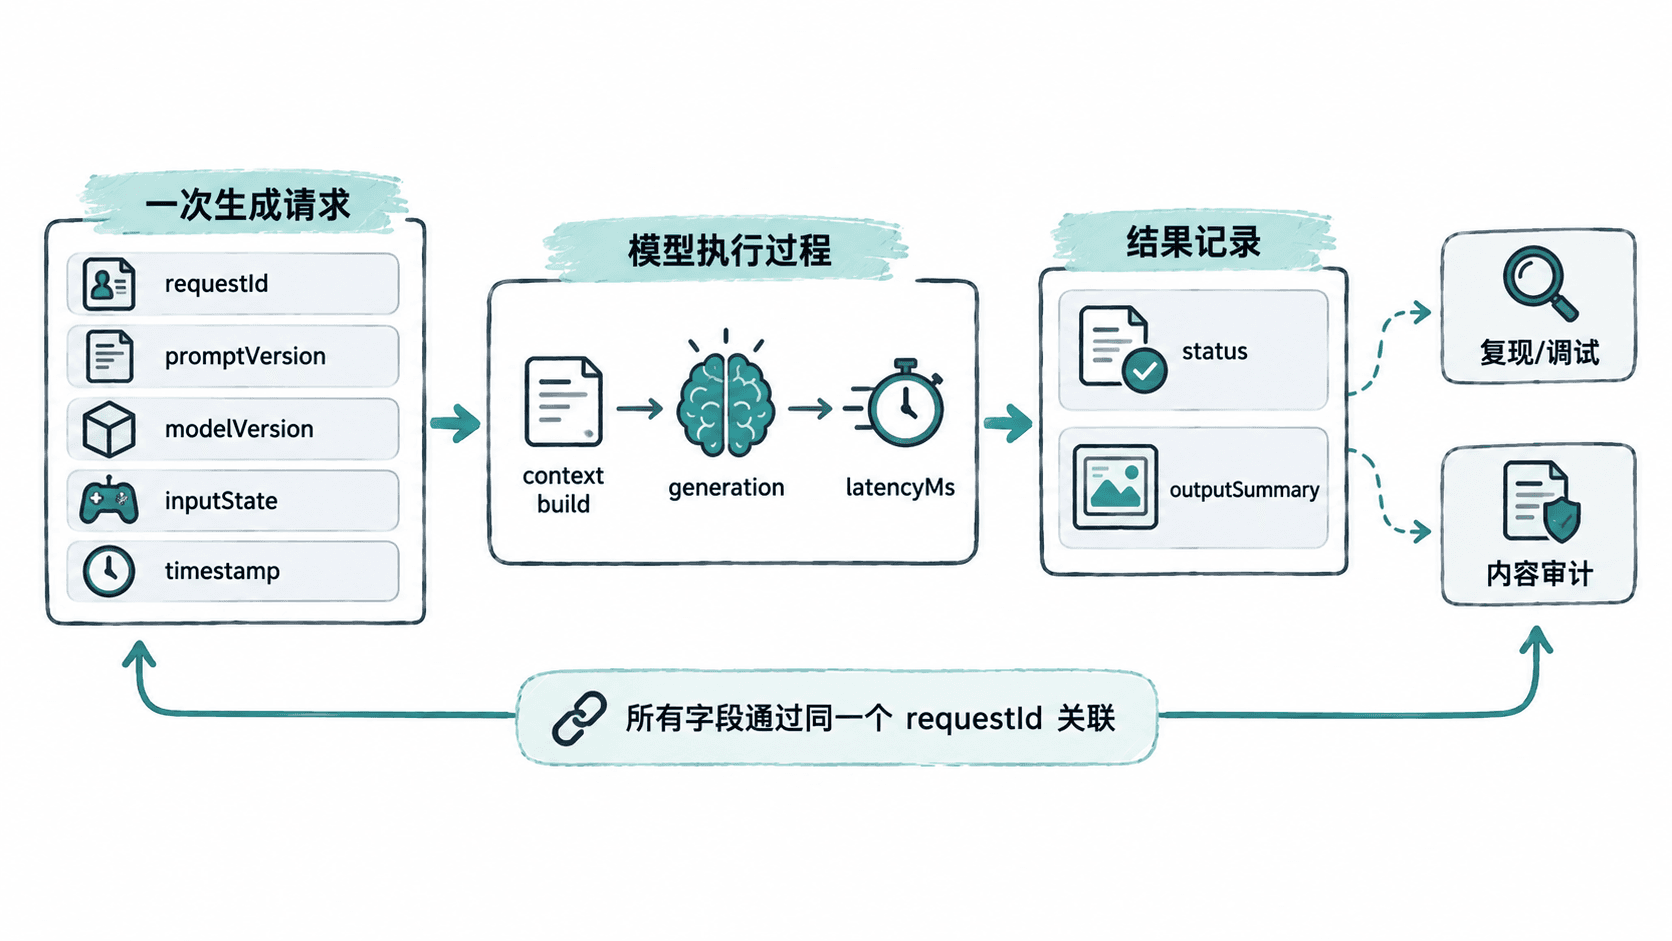
用结构化记录关联一次调用
与其把生成过程写成几行散乱日志,不如固定成一个事件对象。下面的示例使用 Python 标准库创建一条结构化记录,并输出摘要。代码中的模型调用被简化成普通函数返回值,因此可以直接运行验证记录格式。
from dataclasses import asdict, dataclass
from time import perf_counter
from uuid import uuid4

@dataclass
class GenerationRecord:
    requestId: str
    promptVersion: str
    modelVersion: str
    inputState: dict
    latencyMs: int
    status: str
    outputSummary: str


def generate_content(input_state: dict) -> str:
    phase = input_state["battlePhase"]
    return f"enemy tactic for phase={phase}"


def main() -> None:
    request_id = str(uuid4())
    input_state = {
        "regionId": "arena-01",
        "questId": "quest-17",
        "battlePhase": "final",
    }

    started = perf_counter()
    output = generate_content(input_state)
    latency_ms = int((perf_counter() - started) * 1000)

    record = GenerationRecord(
        requestId=request_id,
        promptVersion="combat-tactic-v3",
        modelVersion="game-content-model-v2",
        inputState=input_state,
        latencyMs=latency_ms,
        status="success",
        outputSummary=output,
    )

    print(record.requestId)
    print(asdict(record)["status"])
    print(asdict(record)["outputSummary"])
预期输出
<TIME-BASED-UUID>
success
enemy tactic for phase=final
第一行的 UUID 每次运行都会不同,实际耗时也可能因机器而变化。这里最重要的不是固定输出值,而是同一个 requestId 能把输入、版本、耗时和结果摘要关联起来。
用版本信息保证可复现
提示词文本会变,模型版本会变,上下文选择规则也会变。因此不要只记录“使用了战斗提示词”,而应记录稳定的版本标识。版本可以来自应用配置或内容仓库,例如 combat-tactic-v3,并与实际发布版本保持一致。
如果生成结果需要进一步审计,还应保存结构化输入快照或其内容哈希,以确认当时参与生成的状态没有被后续修改。调试时先按 requestId 找到原始记录,再核对提示词版本、模型版本和输入状态,最后比较输出,而不是直接凭最终文本猜原因。
日志里不要什么都存
可追踪不等于完整复制。账号凭据、访问令牌、密钥以及不必要的玩家隐私信息不应进入普通生成日志。输出摘要也可以只保留用于定位问题的字段,例如内容 ID、类型、长度、校验结果和少量安全摘要。
让记录真正服务排障
一次生成记录至少应能支持三类操作:根据 requestId 找到完整链路,根据 promptVersion 和 modelVersion 比较不同版本行为,根据 inputState 重放相同条件。生产环境还可以增加 environment、durationBucket 或 errorCode 等字段,用于聚合分析,但不要破坏核心记录的稳定结构。
当某个 NPC 突然生成了不合理内容时,理想的排查顺序是先定位请求,再核对版本和输入状态,然后检查耗时与状态,最后对比输出摘要。这样问题会从“模型为什么这么回答”变成一条有证据的执行记录,复现和审计才真正可行。