
游戏 AI / 系统课时
怎么给生成内容设质量门槛
怎么给生成内容设质量门槛
生成式 AI 输出不能因为“看起来不错”就直接进入游戏。更稳妥的做法是把格式、事实、长度、重复率和游戏规则拆成可自动检查的门槛,并规定失败后是重试、修正、降级还是丢弃,让生成结果从“模型回答”变成“可交付内容”。
学习目标
- 能把生成内容拆成可执行的质量指标
- 能实现一条基础的自动校验链,并处理失败分支
- 能根据失败类型选择重试、修正或降级策略
先把质量要求变成机器能判断的规则
质量门槛的关键不是检查项越多越好,而是每一项都能回答“通过还是失败”。例如 JSON 是否可解析、必填字段是否存在、长度是否在范围内、事实字段是否来自允许的数据源、重复率是否超过阈值,以及生成结果是否违反当前游戏规则。
这些检查最好分成两层。第一层检查格式与结构,速度快、结果确定;第二层检查内容与业务约束,例如事实白名单、角色设定和数值边界。这样可以尽早拒绝明显错误,避免把计算资源花在已经不合格的结果上。
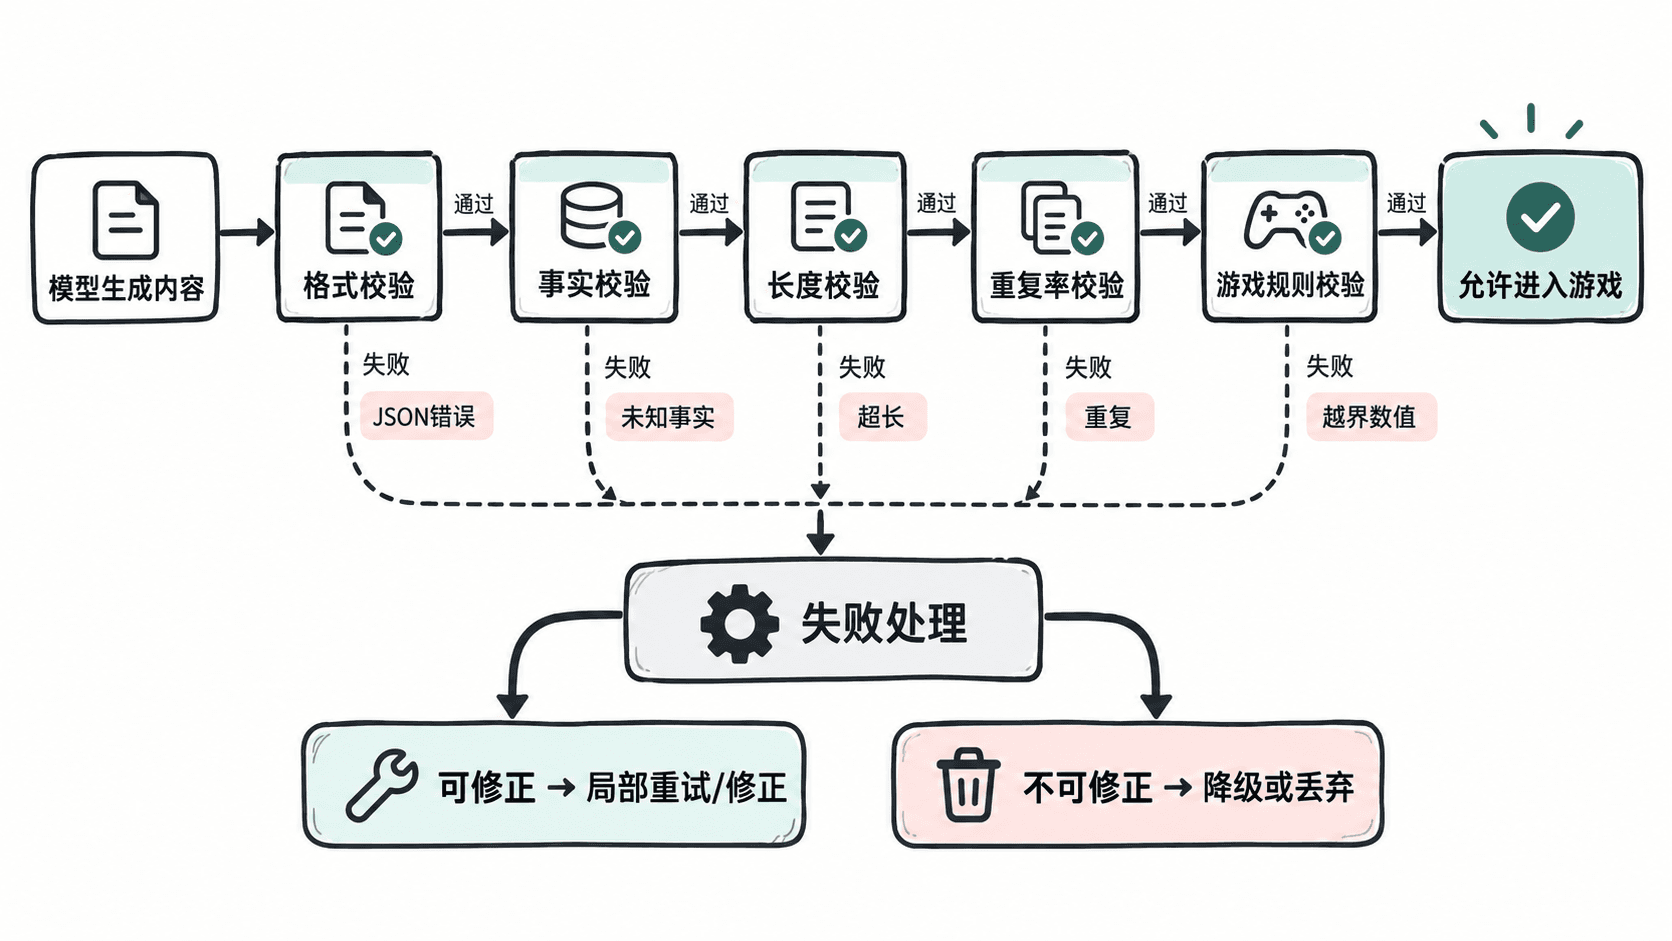
门槛还需要明确“谁负责判断”。例如事实校验应尽量依赖游戏自己的配置、数据库或检索结果,而不是让另一个模型凭印象判断。重复率可以使用文本相似度阈值;游戏规则则直接检查枚举值、数值范围、前置条件等确定性约束。
用一个统一结果承载所有检查
实际工程中,可以让每个校验器都返回统一结构。下面的示例使用 Python 演示一个最小实现:格式、长度和规则检查都输出同一种结果,最后统一决定是否放行。
from dataclasses import dataclass
import json

@dataclass
class CheckResult:
    name: str
    passed: bool
    reason: str


def validate_content(raw: str) -> list[CheckResult]:
    results = []

    try:
        data = json.loads(raw)
        results.append(CheckResult("format", True, "JSON valid"))
    except json.JSONDecodeError as exc:
        return [CheckResult("format", False, f"invalid JSON: {exc.msg}")]

    text = data.get("text", "")
    allowed_types = {"dialogue", "quest"}
    content_type = data.get("type")

    results.append(CheckResult(
        "length",
        20 <= len(text) <= 240,
        "length within range" if 20 <= len(text) <= 240 else "text length out of range"
    ))
    results.append(CheckResult(
        "rule",
        content_type in allowed_types,
        "type allowed" if content_type in allowed_types else "type not allowed"
    ))

    return results


def main() -> None:
    raw = '{"type":"dialogue","text":"Guard: The north gate is closed until sunset."}'
    results = validate_content(raw)

    for result in results:
        print(f"{result.name}: {'PASS' if result.passed else 'FAIL'} - {result.reason}")

    accepted = all(result.passed for result in results)
    print(f"accepted: {accepted}")


if __name__ == "__main__":
    main()
预期输出
format: PASS - JSON valid
length: PASS - length within range
rule: PASS - type allowed
accepted: True
这个结构有一个重要好处:后续增加事实检查、重复率检查时,不需要改写整条业务流程,只需增加新的校验器并继续汇总 CheckResult。生产环境还应记录失败原因,便于统计究竟是模型质量差,还是规则本身过严。
失败后不要默认无限重试
失败处理应该按原因分类。格式错误通常适合带约束重新生成;长度超限可以先尝试压缩;违反游戏规则时,优先修正参数或切换到安全模板;事实不可信时,不应靠重复采样“碰运气”,而应回到可信数据源;重复率过高则可以增加变化约束,仍失败时直接使用已有候选内容。
可以给每类错误设置有限次数,例如格式错误最多重试 2 次,规则错误最多修正 1 次,事实校验失败则直接降级。这样系统行为是可预测的,也容易做成本预算。
阈值应该通过数据持续校准
第一次上线时,阈值往往只是工程假设。例如长度上限、相似度阈值和允许的数值范围,都应结合真实样本观察误杀率和漏放率。最有价值的监控不是单纯记录“通过率”,而是记录每个门槛的失败占比,以及失败后最终是否被人工接受。
当某个规则频繁挡住最终质量良好的内容时,说明阈值可能过严;当通过的内容经常在人工验收时被拒绝,则说明规则覆盖不足。质量门槛最终应形成“规则→结果→人工反馈→阈值调整”的闭环,而不是一套永远不变的常量。