
游戏 AI / 系统课时
给动态剧情加自动回归测试
给动态剧情加自动回归测试
这篇解决 AI 剧情最难回归的问题:同一个事件输入后,状态、记忆和结构化输出是否仍按规则变化。你将用确定性测试样例固定关键行为,让模型变化不会掩盖业务回归。
学习目标
- 能为状态转换、记忆检索和结构化剧情输出设计稳定测试样例
- 能区分随机生成内容与必须保持不变的业务断言
- 能运行一组自动化测试并定位失败发生在哪一层
先固定可回归的边界
AI 剧情测试不能把整段自然语言逐字写死,否则模型版本或措辞变化就会制造大量无意义失败。更适合固定的是业务结果,例如 questStatus 是否从 in_progress 变成 completed、关键记忆是否进入候选集、结构化结果是否通过约束。
建议把一次测试输入固定为事件、当前状态和有限记忆,并把模型输出转换成可断言的数据。这样测试关注的是“系统做了什么”,而不是“模型用了哪句话表达”。
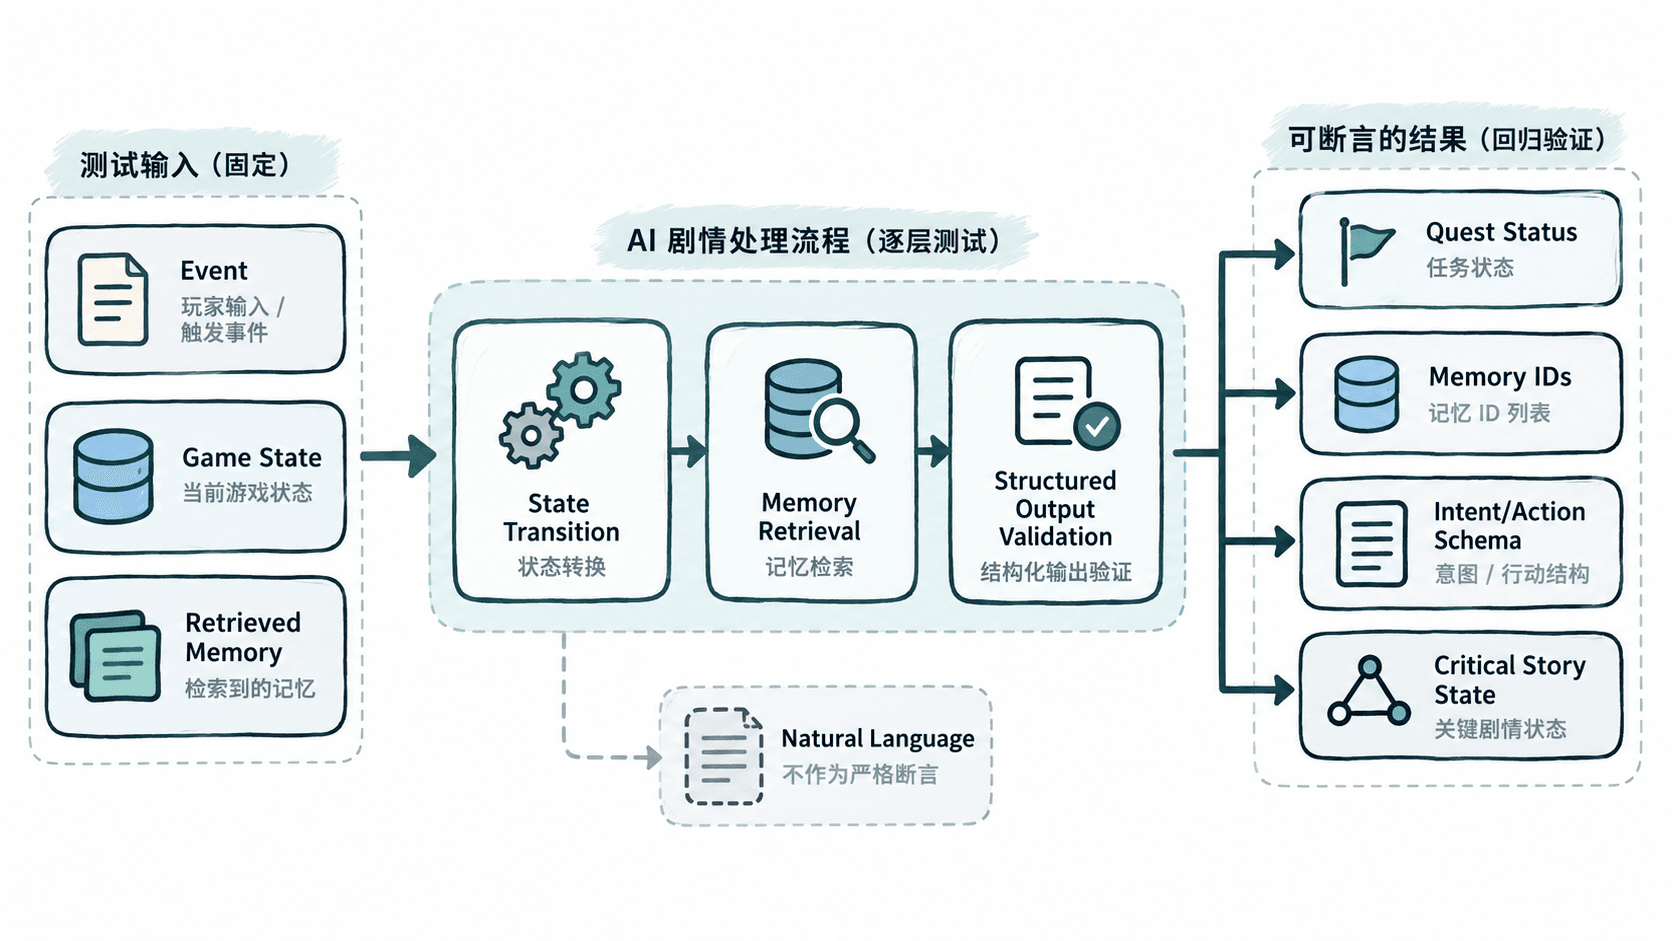
用状态转换测试关键剧情结果
状态转换通常是最值得优先覆盖的部分,因为它直接决定剧情是否还能继续。下面示例把“完成护送任务”定义为确定性业务规则,并检查同一事件重放、另一个完成事件冲突以及写回执前失败的恢复。示例使用 SQLite 内存库、单连接和一个已认证任务实例。
import sqlite3
import unittest

def finish(db, event_id, *, fail=False):
    # 教学样例只有一个已认证的任务实例。
    with db:
        prior = db.execute("SELECT outcome FROM receipts WHERE id=?", (event_id,)).fetchone()
        if prior:
            return prior[0]
        changed = db.execute("UPDATE quest SET status='completed' WHERE status='in_progress'").rowcount
        outcome = "completed" if changed else "rejected"
        if changed:
            db.execute("UPDATE reward SET count=count+1")
        if fail:
            raise RuntimeError("inject failure before receipt")
        db.execute("INSERT INTO receipts VALUES (?, ?)", (event_id, outcome))
        return outcome

class StoryStateTests(unittest.TestCase):
    def setUp(self):
        self.db = sqlite3.connect(":memory:")
        self.addCleanup(self.db.close)
        self.db.executescript("""
            CREATE TABLE quest(status TEXT);
            INSERT INTO quest VALUES ('in_progress');
            CREATE TABLE reward(count INTEGER);
            INSERT INTO reward VALUES (0);
            CREATE TABLE receipts(id TEXT PRIMARY KEY, outcome TEXT);
        """)

    def test_same_event_replays_receipt_and_grants_once(self):
        self.assertEqual(finish(self.db, "evt-1"), "completed")
        self.assertEqual(finish(self.db, "evt-1"), "completed")
        self.assertEqual(finish(self.db, "evt-2"), "rejected")
        self.assertEqual(self.db.execute("SELECT count FROM reward").fetchone(), (1,))

    def test_failure_rolls_back_state_reward_and_receipt(self):
        with self.assertRaises(RuntimeError):
            finish(self.db, "evt-1", fail=True)
        self.assertEqual(self.db.execute("SELECT status FROM quest").fetchone(), ("in_progress",))
        self.assertEqual(self.db.execute("SELECT count FROM reward").fetchone(), (0,))
        self.assertEqual(self.db.execute("SELECT count(*) FROM receipts").fetchone(), (0,))
        self.assertEqual(finish(self.db, "evt-1"), "completed")

if __name__ == "__main__":
    unittest.main()
预期结果
..
----------------------------------------------------------------------
Ran 2 tests in <TIME>s

OK
这里的 <TIME> 是实际运行时间,会因环境不同而变化。测试重点不是耗时,而是两个核心不变量:合法事件只发一次奖,同一事件重放返回原回执,回执写入失败时任务状态与奖励一起回滚。线上还需测独立连接并发,并以完整任务作用域和事件 ID 作为唯一键。
测试记忆检索而不是模型措辞
记忆回归更适合测试“应该召回哪条事实”。例如玩家曾帮助守城,那么以“守城援助”为查询时,包含该事实的记忆 ID 应出现在结果中。测试可以固定输入记忆库与排序规则,不要求生成的对白完全一致。
from dataclasses import dataclass


@dataclass(frozen=True)
class Memory:
    memory_id: str
    text: str
    active: bool = True


def retrieve_memories(query: str, memories: list[Memory], limit: int = 2) -> list[Memory]:
    terms = {word.lower() for word in query.split()}
    scored = []
    for memory in memories:
        if not memory.active:
            continue
        score = sum(term in memory.text.lower() for term in terms)
        if score > 0:
            scored.append((score, memory))
    scored.sort(key=lambda item: (-item[0], item[1].memory_id))
    return [memory for _, memory in scored[:limit]]


memories = [
    Memory("m-101", "玩家帮助城镇守军守住北门"),
    Memory("m-000", "守军 北门", active=False),
    Memory("m-102", "玩家购买了一瓶治疗药水"),
]

result = retrieve_memories("守军 北门", memories)
assert result[0].memory_id == "m-101"
print([memory.memory_id for memory in result])
预期结果
['m-101']真实项目中检索可能使用向量数据库、重排器或模型,因此排序实现会变化,但测试契约仍可保持:关键事实必须召回、失效记忆不能进入结果、结果数量不能超过上下文预算。
给结构化输出加硬断言
剧情模型输出如果包含 dialogue、intent 和 action,应优先验证结构与业务合法性。例如 intent=complete_quest 的建议须含 questId。通过 Schema 只是格式合格,服务端还要拒绝越权、旧版本和不满足完成条件的请求。可用同样形状的对象替换成另一个玩家的任务 ID,断言零写入。这样模型“说得像真的”也不能绕过游戏规则。
测试用例最好覆盖三类输入:正常结果、缺字段结果、非法动作结果。正常结果验证可以执行,异常结果验证必须确认系统拒绝,二者共同构成稳定的回归门禁。
让回归测试真正可长期运行
固定输入、固定测试数据和明确断言后,再把这组测试放进每次提交或发布流水线。对于依赖外部模型的测试,可把在线调用拆成少量集成测试,同时保存经过脱敏的真实响应作为回归样例;核心业务层仍使用确定性测试。
当测试失败时,先按“状态转换 → 记忆检索 → Schema 校验 → 关键剧情结果”的顺序定位。只要业务断言保持稳定,模型版本、提示词版本或语言措辞发生变化,就不会被误判为整套系统回归失败。