
游戏 AI / 系统课时
语义检索怎么找到相关回忆
语义检索怎么找到相关回忆
当 NPC 面对一句新对话或一个新场景时,关键词匹配很容易漏掉“同义但措辞不同”的旧事件。本篇用 Embedding 把回忆与当前需求映射到向量空间,再按语义相似度召回最相关的内容。
学习目标
- 理解 Embedding 为什么能支持按含义检索回忆
- 用 Python 生成记忆向量并完成相似度召回
- 学会限制候选数量,并把检索结果交给后续上下文组装
先把“找回忆”变成向量问题
假设玩家说“我之前替你找回了那枚护符”,NPC 不应该只搜索“护符”三个字,还要找到“玩家在遗迹里取回失物并交还给我”这类表达不同、含义相近的事件。
做法是先把每条记忆编码成向量,再把当前场景或角色需求编码成查询向量。相似度高的记忆排在前面,低相似度的候选则被淘汰。
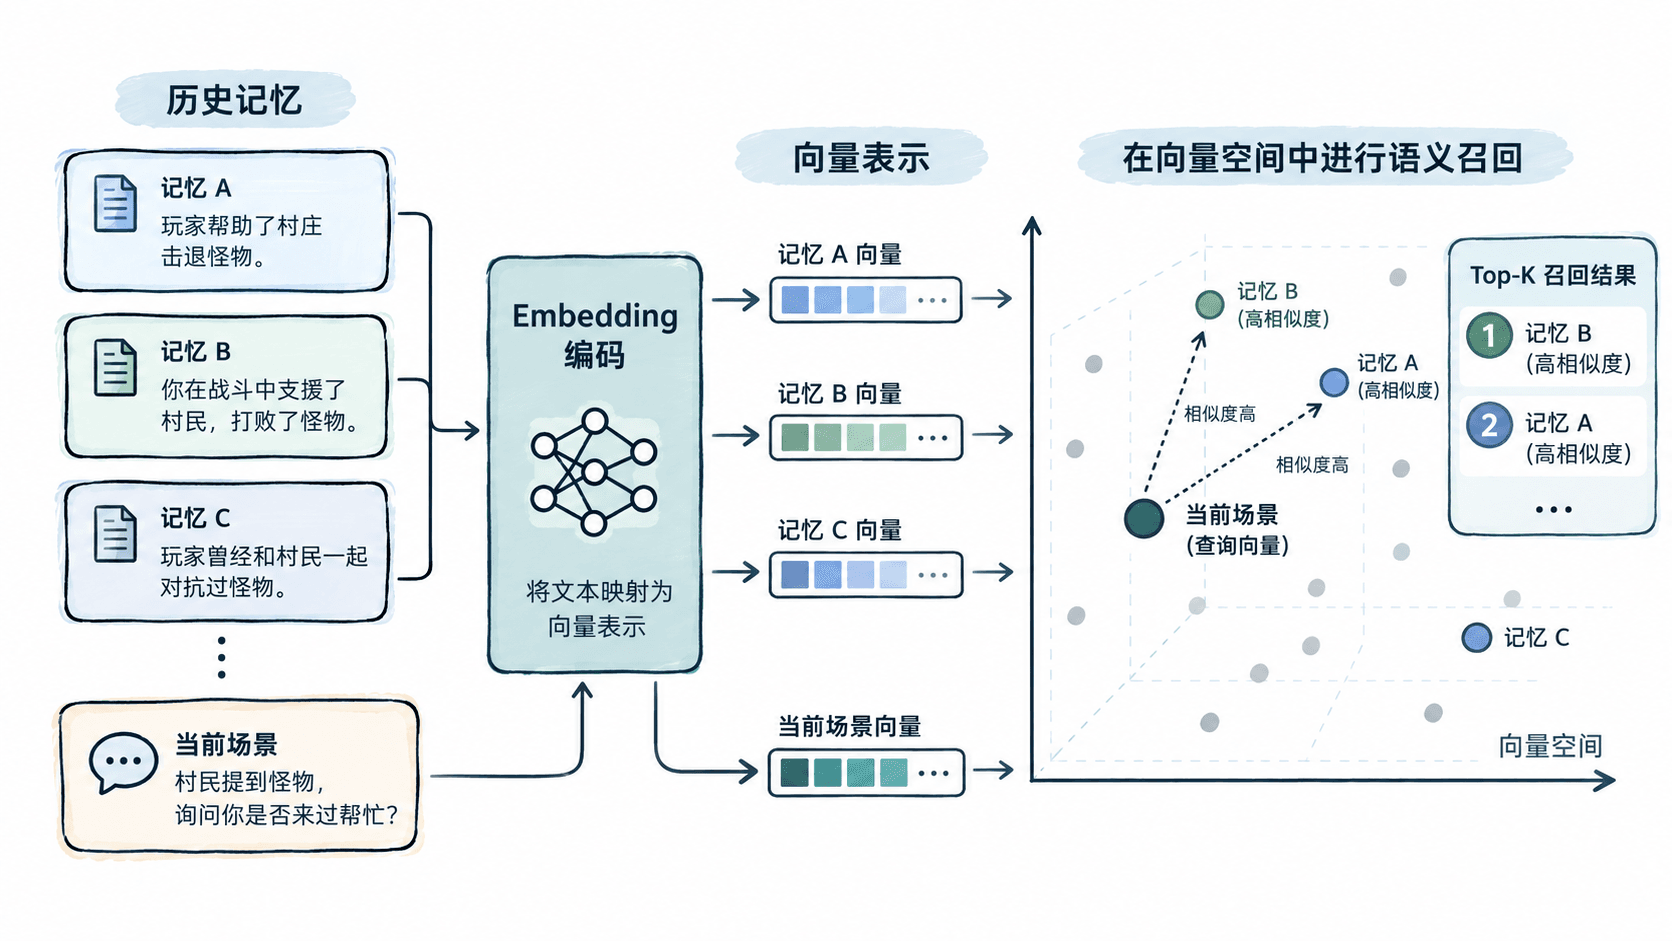
用相似度完成一次召回
默认运行使用预置向量,验证余弦、候选边界和范围过滤。若已安装 sentence-transformers 并准备本地模型,可传 --model-dir 让同一检索器使用真实句向量。查询与记忆必须用兼容的同一版本编码。
from math import isfinite, sqrt
import argparse

def unit(vector):
    values = [float(value) for value in vector]
    if not values or any(not isfinite(value) for value in values):
        raise ValueError("向量必须非空且有限")
    norm = sqrt(sum(value * value for value in values))
    if not isfinite(norm) or norm == 0:
        raise ValueError("不能归一化零向量或溢出向量")
    return [value / norm for value in values]

def recall(query, memories, scope, encode, *, limit=2, min_score=0.25):
    if type(limit) is not int or limit < 1 or not -1 <= min_score <= 1:
        raise ValueError("无效的候选数量或分数门槛")
    rows = [row for row in memories if row["scope"] == scope and row["status"] == "active"]
    if not rows:
        return []
    vectors = list(encode([query] + [row["text"] for row in rows]))
    if len(vectors) != len(rows) + 1:
        raise ValueError("编码器返回数量不符")
    query_vector = unit(vectors[0])
    ranked = []
    for row, vector in zip(rows, vectors[1:]):
        vector = unit(vector)
        if len(vector) != len(query_vector):
            raise ValueError("查询与候选向量维度不符")
        score = sum(a * b for a, b in zip(query_vector, vector))
        if score >= min_score:
            ranked.append((row["id"], score))
    return sorted(ranked, key=lambda item: (-item[1], item[0]))[:limit]

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--model-dir", help="已下载的 Sentence Transformers 模型目录")
    args = parser.parse_args()
    scope = ("save-7", "main", "gatekeeper", "player-a")
    memories = [
        {"id": "amulet", "text": "玩家在遗迹中找回护符,并亲手交还给守门人。", "scope": scope, "status": "active"},
        {"id": "watermill", "text": "玩家曾经帮助村民修复水车。", "scope": scope, "status": "active"},
        {"id": "hidden", "text": "玩家之前帮我找回了遗失的护符。", "scope": ("save-7", "branch-b", "gatekeeper", "player-a"), "status": "active"},
    ]
    query = "玩家之前帮我找回了遗失的护符。"
    if args.model_dir:
        from sentence_transformers import SentenceTransformer
        model = SentenceTransformer(args.model_dir, local_files_only=True)
        encode = model.encode
    else:
        # 预置向量只测试检索逻辑,不测自然语言编码效果。
        fixture = {query: [1, 0], memories[0]["text"]: [4, 3], memories[1]["text"]: [0, 1]}
        encode = lambda texts: [fixture[text] for text in texts]
    for identifier, score in recall(query, memories, scope, encode):
        print(f"{identifier}: {score:.3f}")

if __name__ == "__main__":
    main()
保存为 memory_recall.py,运行 python memory_recall.py。预置向量的输出如下。
amulet: 0.800归一化后点积等于余弦相似度,范围为 −1 到 1;门槛 0.25 仅用于教学。使用真实模型时按模型卡准备本地目录,并用自己的正例和难负例校准阈值。分数高表示向量接近,证据仍需核实。
查询内容决定召回质量
查询不要只塞入玩家当前的一句台词。NPC 真正需要的是“当前场景 + 角色需求 + 可检索条件”,例如“守门人现在判断玩家是否履行过承诺”。这样得到的查询语义更接近记忆真正要解决的问题。
记忆本身也应写成完整事件,而不是只有标签。护符、遗迹、玩家 这样的词很容易产生大量无关结果;“玩家在遗迹找回护符并交还守门人”则同时保留了动作、对象和关系。
从召回结果进入上下文
向量检索通常只负责产生候选,不负责决定 NPC 最终一定会说什么。先过滤存档、分支、角色、玩家与失效状态,再在允许的集合内取前 条记忆,再把记忆内容、发生时间和重要性等字段交给后续排序或上下文组装。
当候选数量已经很多时,不要直接把全部结果拼进提示词。先做一次 top-k 召回,通常比把整个记忆库交给模型更稳定,也能控制上下文长度和推理成本。