
游戏 AI / 系统课时
高峰期同时说话怎么办
高峰期同时说话怎么办
当多个 NPC 在同一时刻触发模型调用时,问题不再只是单个请求慢,而是瞬间并发会把网络、模型服务和本地资源一起推高。本篇用队列、并发限制和请求合并把突发流量变成可控的处理节奏。
学习目标
- 理解为什么 NPC 数量增加后不能直接一请求一并发
- 用队列和并发上限控制同时执行的模型请求数
- 识别可以合并的重复上下文与相同请求
把突发请求先放进队列
游戏中的触发事件可能集中发生,例如一批 NPC 同时进入警戒状态。如果每个事件都立即创建一个模型任务,请求数量会在一个时间片内突然增长。
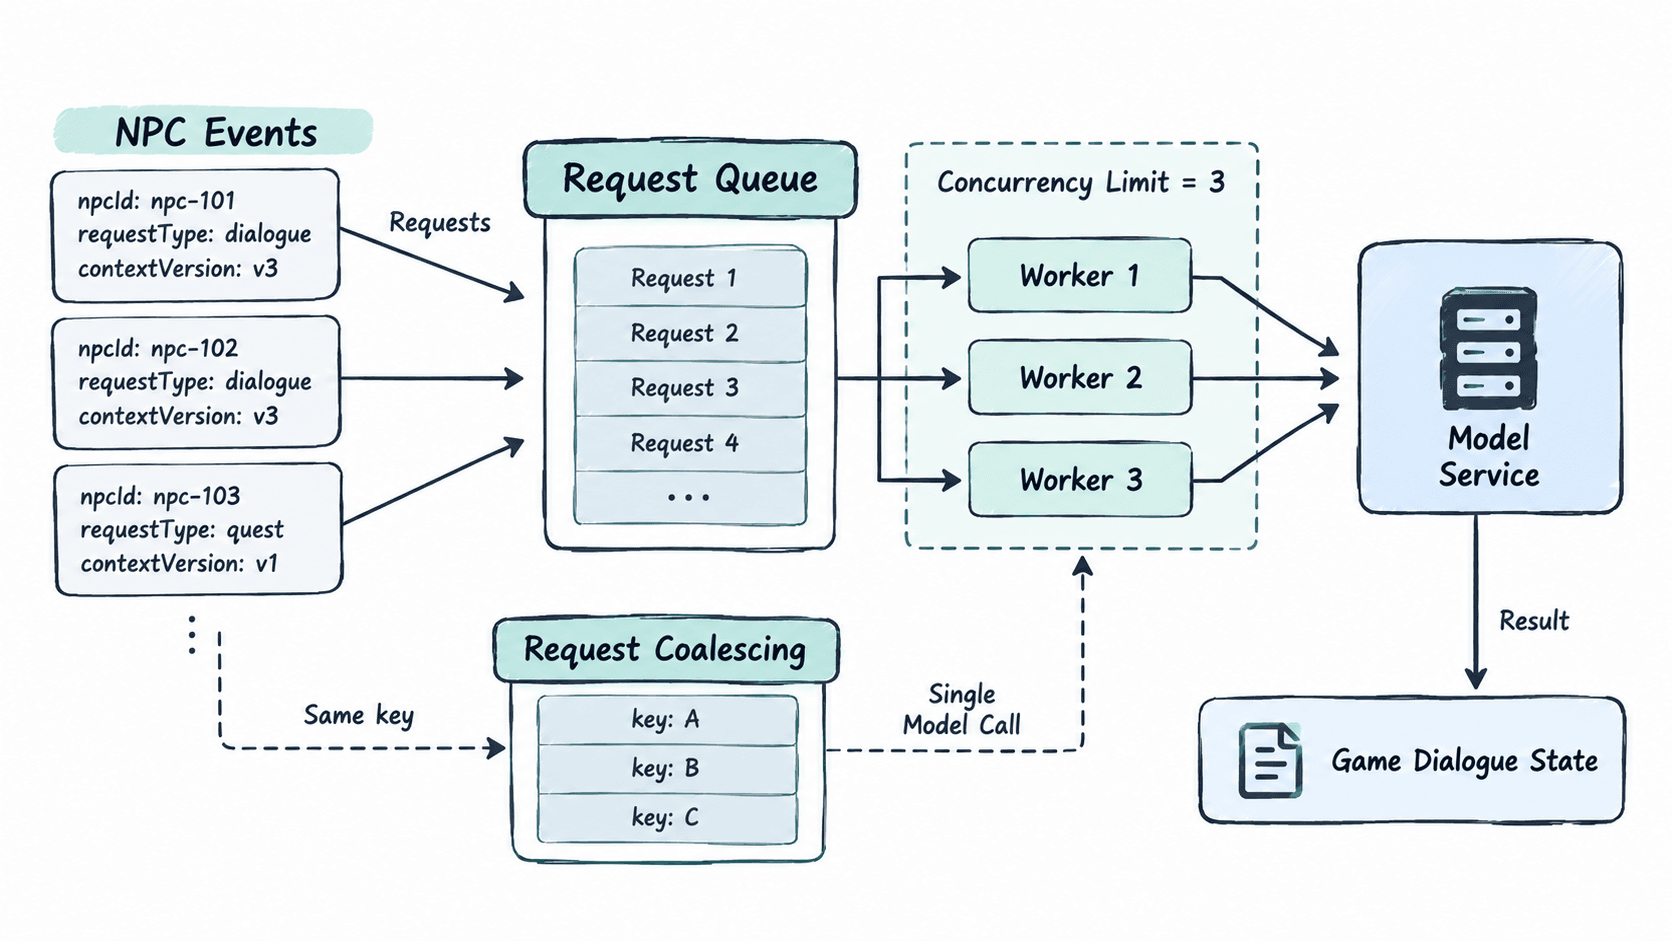
队列的作用是把“什么时候触发”与“什么时候真正调用模型”分离。事件先进入队列,再由固定数量的 worker 消费。这样即使短时间积累很多任务,也不会让执行并发无限增长。
用并发限制保护模型调用
并发限制不是简单降低速度,而是在服务能力与游戏响应之间建立稳定边界。假设同时有 50 个 NPC 触发事件,不应该让 50 个请求都进入模型服务,而应让有限数量的 worker 同时执行,其余任务等待。
Python 的 asyncio.Semaphore 可以直接限制并发执行数。下面示例把 6 个 NPC 请求限制为同时最多 2 个。
import asyncio

async def call_model(npc_id: str) -> str:
    await asyncio.sleep(1)
    return f"{npc_id}: reply ready"

async def run_request(npc_id: str, limit: asyncio.Semaphore) -> str:
    async with limit:
        print(f"{npc_id}: started")
        reply = await call_model(npc_id)
        print(f"{npc_id}: finished")
        return reply

async def main() -> None:
    limit = asyncio.Semaphore(2)
    tasks = [
        asyncio.create_task(run_request(f"npc-{i}", limit))
        for i in range(1, 7)
    ]
    results = await asyncio.gather(*tasks)
    print("results:", len(results))

if __name__ == "__main__":
    asyncio.run(main())
预期输出
npc-1: started
npc-2: started
npc-1: finished
npc-2: finished
npc-3: started
npc-4: started
npc-3: finished
npc-4: finished
npc-5: started
npc-6: started
npc-5: finished
npc-6: finished
results: 6
输出展示一种可能的调度顺序。信号量只保证最多两个调用在执行。示例预先创建了六个任务,若任务源持续增长,还要在提交端设置有界队列,例如使用 asyncio.Queue(maxsize=64) 配合 put_nowait 和 QueueFull 降级。实际项目中并发上限应根据模型服务配额、平均响应时间、网络资源和目标延迟压测得到,不能把一个固定数字直接照搬到所有环境。
队列还能处理优先级和过载
并发限制解决“同时执行多少个”,队列解决“先处理谁”。对话请求通常可以按业务价值分类,例如玩家当前正在面对的 NPC 属于高优先级,而离屏 NPC 的背景对白可以延后甚至丢弃。
高峰期还要设置队列上限。队列无限增长只会把瞬时过载变成长时间延迟。达到容量后,可以拒绝低优先级任务、合并重复任务,或直接返回固定降级结果。
一种简单判断是:能否接受等待超过一个对话窗口。如果答案是否定的,就不应该继续把它无条件塞进队列。
合并重复请求减少模型调用
多个 NPC 不一定对应多个真正不同的模型问题。例如同一事件触发后,多个系统可能重复请求相同的世界事实。先确定输出可共享的权限边界,再把存档、分支、玩家、角色实例、剧情和策略版本、请求目的及规范化输入纳入稳定请求键。仅当调用权限和可能得到的回复都一致时,才合并在途请求。
这种做法称为请求合并。它与缓存不同:缓存通常复用已经完成的结果,请求合并则是在多个调用同时进行时,让多个等待者共享同一个正在执行的请求,从源头减少重复模型调用。
import asyncio

inflight: dict[tuple, asyncio.Task[str]] = {}

async def call_model(key: tuple) -> str:
    await asyncio.sleep(0.03)
    return f"generated:{key[-1]}"

async def shared_call(key: tuple) -> str:
    try:
        async with asyncio.timeout(0.5):
            return await call_model(key)
    finally:
        if inflight.get(key) is asyncio.current_task():
            inflight.pop(key)

def observe_result(task):
    # 所有等待者都取消时,也要取出任务异常。监控可在此记录异常。
    if not task.cancelled():
        task.exception()

async def get_or_create(key: tuple) -> str:
    task = inflight.get(key)
    if task is None:
        task = asyncio.create_task(shared_call(key))
        inflight[key] = task
        task.add_done_callback(observe_result)
    return await asyncio.shield(task)

async def main() -> None:
    # 真实系统还应包含人格、策略、模型及规范化请求版本。
    key = ("save-1", "main", "player-1", "guard-a", 12, "town-gate-evt-204")
    results = await asyncio.gather(*(get_or_create(key) for _ in range(3)))
    print(results)

if __name__ == "__main__":
    asyncio.run(main())
预期输出
['generated:town-gate-evt-204', 'generated:town-gate-evt-204', 'generated:town-gate-evt-204']三个调用者共享一个模型任务。shield 使单个调用者取消时其他等待者仍可得到结果。共享任务自己负责超时、清理和错误观测。若所有调用者离开,本例仍让共享任务运行至完成或超时。进程内合并不跨实例,生产中应监控排队长度、等待时间、执行并发与共享命中。
什么时候该丢弃请求
并不是每个排队任务都值得等待。离开场景的 NPC、已经结束的任务、上下文版本过旧的请求,都可能在轮到它执行时失去意义。
执行 worker 取出任务后,应再次检查 contextVersion、NPC 当前状态和取消标记。发现任务已经过期,就直接丢弃,而不是为了“完成队列”继续消耗一次模型调用。
最终可以把高峰控制拆成三层:队列负责吸收突发,限并发负责保护执行资源,请求合并负责消灭重复工作。再加上过期检查与降级策略,即使几十个 NPC 同时触发事件,也能把模型调用保持在可观测、可限制和可恢复的范围内。