
游戏 AI / 系统课时
Token 成本从哪里不断上涨
Token 成本从哪里不断上涨
当 NPC 对话越来越自然,Token 消耗也常常一起失控。本篇从 Prompt、记忆检索、输出长度和调用频率四个入口拆开成本,并用一套可观测指标判断究竟是哪一项在增长。
学习目标
- 能把一次 AI 请求拆成输入 Token、输出 Token、调用次数和缓存命中等可观测指标
- 能区分单次请求变贵与单位时间请求变多这两类成本问题
- 能用简单统计定位主要增长来源,并确定下一步优化方向
先把总成本拆开
游戏里看到“今天 AI 花费变高”并不等于单次请求一定更贵。最实用的拆分方式是把成本看成请求次数与单次请求成本的乘积,而单次请求又主要受到输入 Token 和输出 Token 影响。Prompt 变长、检索记忆变多、回复变长,都会直接推高单次消耗;NPC 数量增加、触发条件过于频繁,则会推高请求次数。
一次 NPC 对话通常可以沿着这条链路观察:基础 Prompt → 角色与剧情上下文 → 检索记忆 → 模型生成 → 返回输出。真正排查成本时,不要只记录最终 Token 总数,还要记录各阶段的大小,否则很难判断增长发生在哪里。
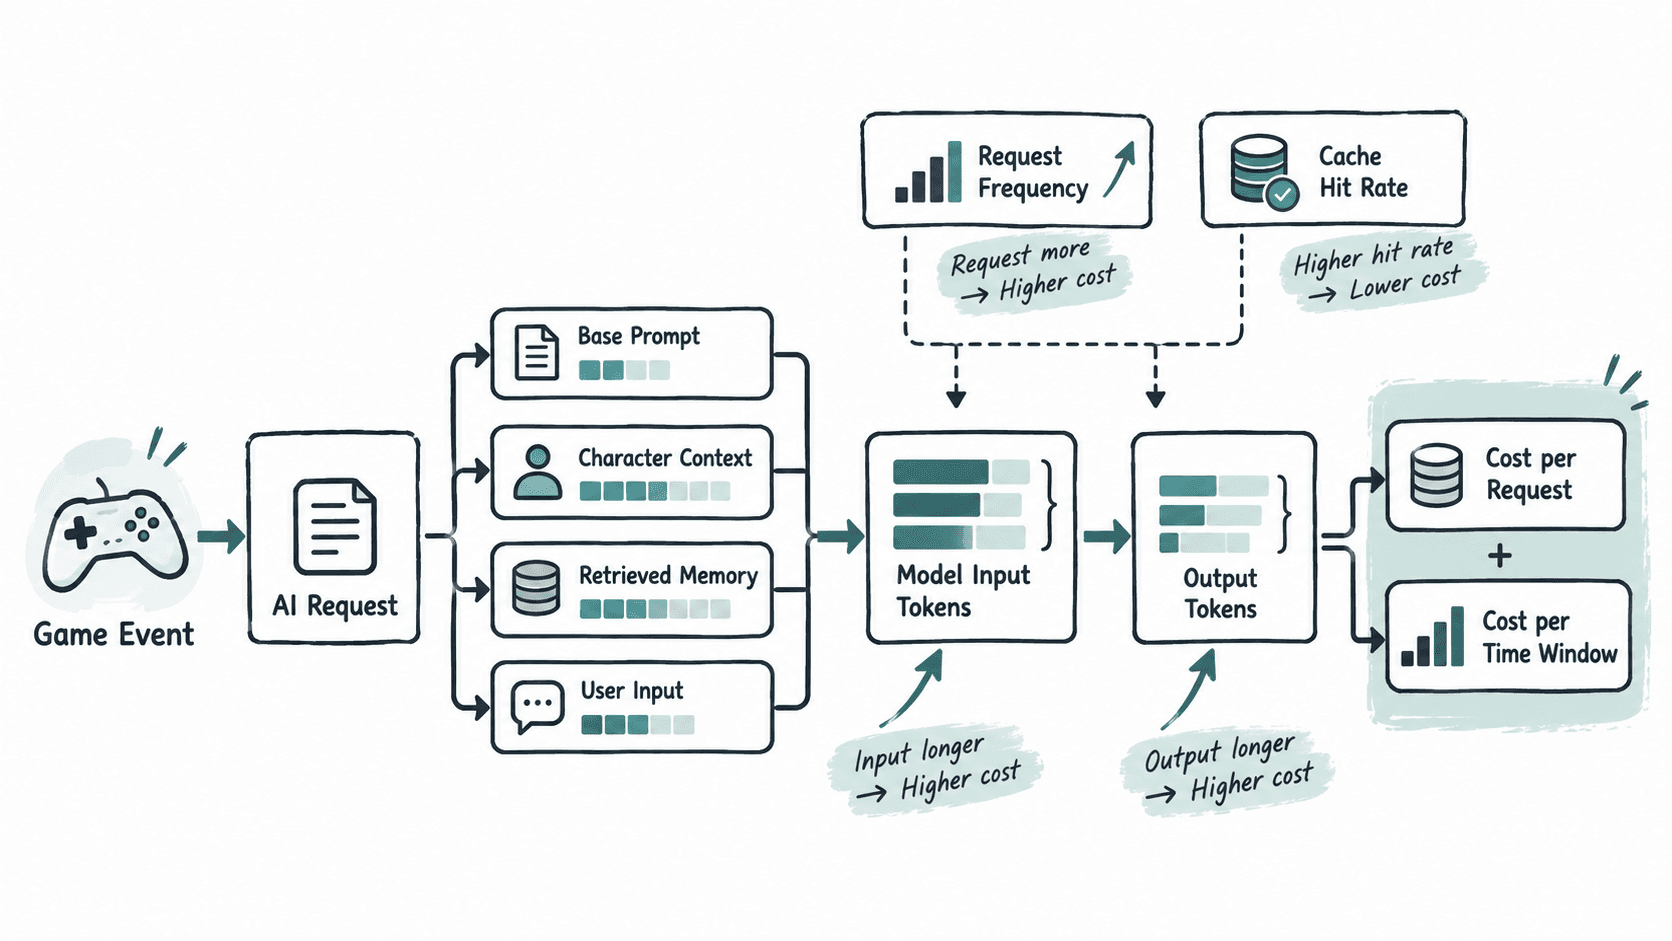
先建立四个核心指标最容易发现异常。input_tokens 反映 Prompt、上下文和记忆检索带来的输入负担;output_tokens 反映模型回复长度;分开记录玩家对话回合数和实际供应商调用数。应用缓存命中可以省掉调用,供应商提示缓存通常仍有调用,可能采用不同的输入费率。再加上 latency_ms,还能识别“成本上涨”和“上下文过长导致变慢”是否同时发生。
看懂一次请求为什么变贵
最常见的第一类问题是输入持续膨胀。开发者为了让 NPC “记得更多”,把历史对话、全部任务状态、所有关系事实都塞进 Prompt。这样即使玩家只问一句话,输入 Token 也可能远高于实际需要。
第二类问题是检索返回过多候选。向量检索本身不一定昂贵,但如果每次把十几甚至几十条记忆全部放进上下文,就会把检索结果的数量直接转化为输入 Token。更合理的做法是先召回,再按相关性、新鲜度和重要性筛选,只保留能够影响当前回复的少量记录。
第三类问题是输出失控。NPC 回复从两三句话变成大段独白,或者要求模型一次同时生成对白、旁白、动作和多个候选剧情,output_tokens 会快速上涨。对于游戏运行时请求,应尽量让输出目标明确,并设置与业务场景匹配的长度上限。
第四类问题是调用频率。相同 NPC 在同一事件里被多个系统重复触发,或者 UI 每次刷新都重新请求模型,都会让单次成本正常但总成本异常。此时继续压缩 Prompt 往往收益有限,应该先减少无意义调用。
用指标找到主要增长项
可以先用一组请求记录做最小化统计。下面的示例只依赖 Python 标准库,适合直接放入本地调试脚本。本例用假设价格,每百万普通输入、供应商缓存输入、输出分别按 1、0.25、4 个计费单位估算。生产应按供应商用量、模型和时段价格对账。
from dataclasses import dataclass
from decimal import Decimal

@dataclass(frozen=True)
class Turn:
    application_cache_hit: bool
    # 每次实际供应商调用分别记录,包括确实产生用量的重试。
    attempts: tuple[tuple[int, int, int], ...]  # 普通输入、供应商缓存输入、输出

RATES_PER_MILLION = tuple(map(Decimal, ("1", "0.25", "4")))

def summarize(turns: list[Turn]) -> dict:
    attempts = [usage for turn in turns for usage in turn.attempts]
    totals = tuple(sum(usage[i] for usage in attempts) for i in range(3))
    cost = sum(amount * rate for amount, rate in zip(totals, RATES_PER_MILLION)) / Decimal(1_000_000)
    return {
        "turns": len(turns),
        "provider_calls": len(attempts),
        "app_cache_hits": sum(turn.application_cache_hit for turn in turns),
        "estimated_cost": str(cost.quantize(Decimal("0.000001"))),
    }

turns = [
    Turn(False, ((900, 0, 120),)),
    Turn(False, ((950, 0, 130),)),
    Turn(False, ((1800, 0, 0), (0, 1800, 125))),
    Turn(True, ()),
]
print(summarize(turns))
预期输出如下,具体浮点显示形式可能因环境而略有不同。
{'turns': 4, 'provider_calls': 4, 'app_cache_hits': 1, 'estimated_cost': '0.005600'}这里四个玩家回合中一个命中应用缓存,另一个回合发起两次供应商调用,所以供应商调用仍有四次。普通输入共 3650、供应商缓存输入 1800、输出 375,估算为 (3650 + 1800 × 0.25 + 375 × 4) ÷ 1,000,000 = 0.005600。诊断上涨时应比较相同口径的两个时间窗,而非由本窗的 Token 比例推断根因。实际分析时可以继续按 npcId、requestType、sceneId 或 promptVersion 分组,找到具体是哪类请求在上涨。
从单次成本转向时间窗口
单次请求指标适合解释“为什么这一条请求变贵”,但线上成本更需要看固定时间窗口。例如统计每小时的 request_count、总输入 Token、总输出 Token 和缓存命中率,就能区分两种完全不同的问题。
当每次请求的 Token 基本稳定,但每小时请求数从 1000 增长到 5000,根因通常是触发频率、重复请求或并发行为;当请求数稳定而平均输入 Token 从 800 增长到 1600,则应该检查 Prompt 模板和记忆召回数量。两者同时增长时,要先处理增长最快、最容易被放大的那一项。
成本优化不应该从“把 Prompt 随便删短”开始,而应从可观测性开始。先知道输入、输出、频率和缓存分别占了多少,再针对最大项减少无效上下文、限制输出、合并重复请求或提高缓存命中率,才能让优化结果可验证、可回归。