
游戏 AI / 系统课时
检索太多记忆怎么办
检索太多记忆怎么办
语义检索能找回相关内容,但“相关”不等于“现在都该告诉 NPC”。当候选回忆越来越多,需要同时考虑相似度、时间新鲜度和事件重要性,把真正有用的少量记忆排到前面并限制上下文规模。
学习目标
- 理解为什么不能只按向量相似度直接取前几条
- 设计时间、新鲜度、重要性与相似度的联合重排
- 用固定预算控制最终送入模型的记忆数量
先区分召回和重排
第一阶段可以用向量检索快速召回几十条候选,第二阶段再结合业务信号进行重排。例如“玩家昨天刚背叛 NPC”与“玩家一年前帮 NPC 找过一本书”都可能语义相关,但前者对当前对话通常更重要。
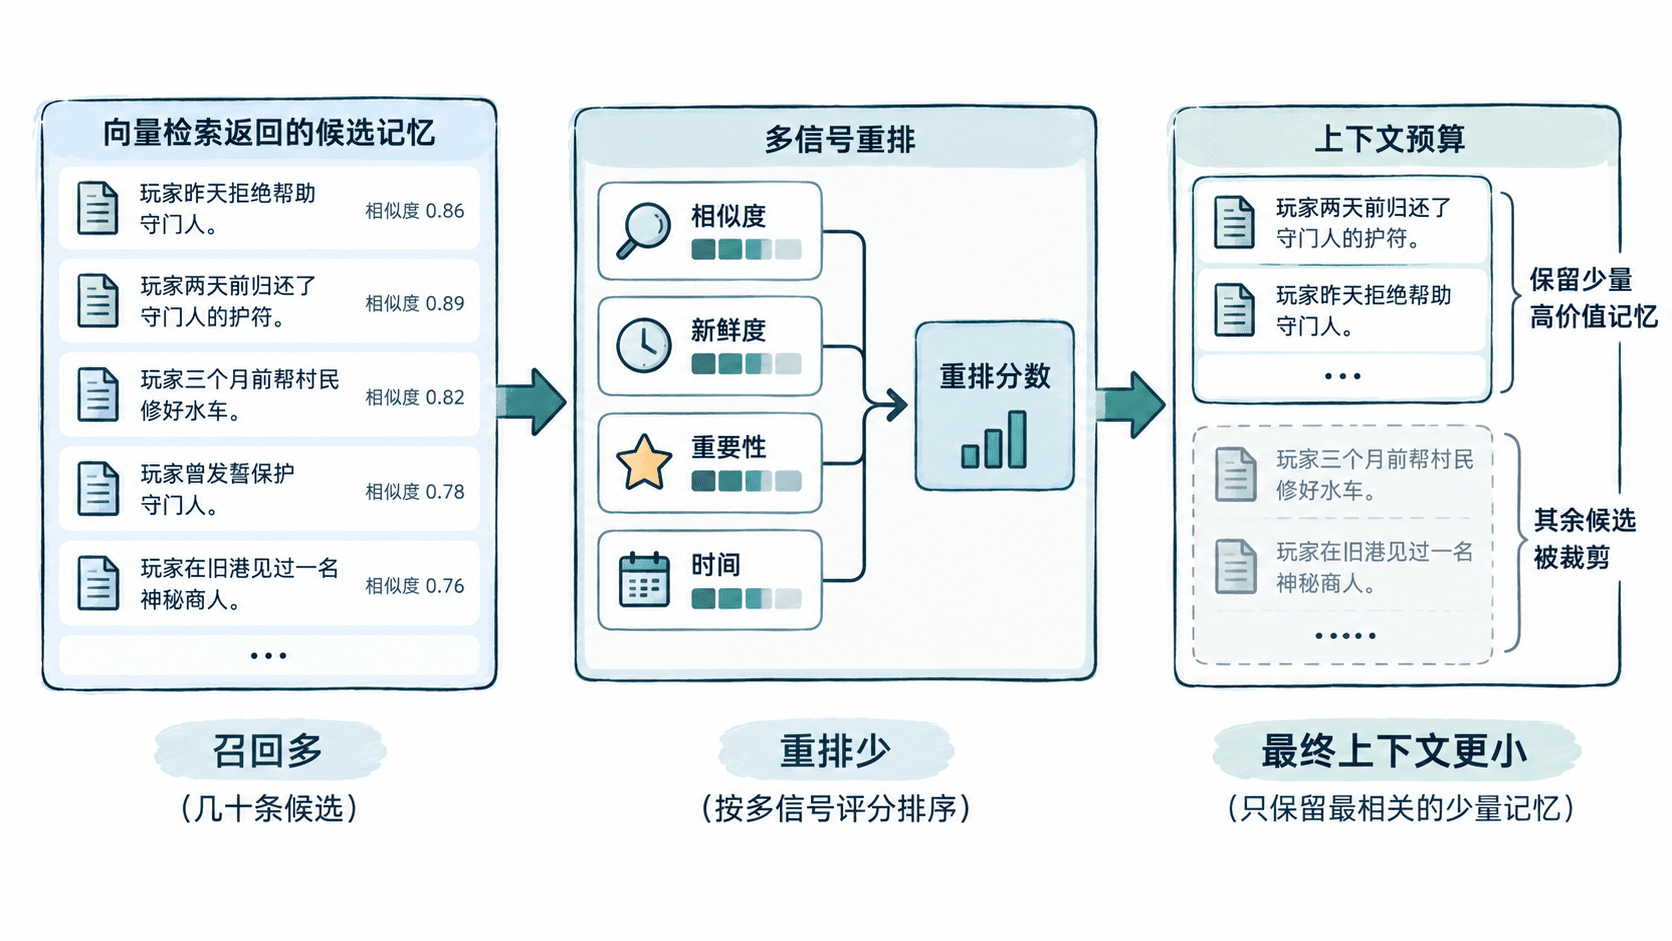
给候选记忆一个统一分数
可以把信号映射到同一范围后加权。本示例输入的 similarity 已在 0~1;原始余弦可能为负,采用何种映射应与校准样本一致。一个简单的工程模型是:
其中三个权重之和为 1。相似度负责回答“像不像当前需求”,新鲜度负责回答“是不是最近发生”,重要性负责回答“这件事值不值得记住”。权重不必一次定死,应通过实际对话样本调整。
时间新鲜度可以使用随年龄衰减的函数,例如让刚发生的事件接近 1,长期未出现的事件逐渐降低。重要性则更适合来自明确的业务事件,如背叛、承诺、关键任务完成,而不是完全交给模型自由判断。
用代码做一次重排和截断
下面是一个可独立运行的片段示例。输入是已经通过范围、权限和有效性筛选的候选,年龄来自游戏时钟。按综合分数排序,合并同事件后同时限制条数和字符数。
from math import exp

def select(candidates, *, context_budget=2, char_budget=32):
    if type(context_budget) is not int or type(char_budget) is not int or min(context_budget, char_budget) < 0:
        raise ValueError("预算必须为非负整数")
    if context_budget == 0 or char_budget == 0:
        return []
    ranked = []
    for item in candidates:
        similarity, importance, age = (item[key] for key in ("similarity", "importance", "age_hours"))
        if not 0 <= similarity <= 1 or not 0 <= importance <= 1 or not 0 <= age < float("inf"):
            raise ValueError("分数和游戏时间必须有效")
        freshness = exp(-age / 720.0)
        score = 0.5 * similarity + 0.2 * freshness + 0.3 * importance
        ranked.append((item, score))
    ranked.sort(key=lambda row: (-row[1], row[0]["event_id"]))
    selected, seen, used_chars = [], set(), 0
    for item, score in ranked:
        event_id = item["event_id"]
        cost = len(item["text"]) + (1 if selected else 0)  # 多条间用一个换行符分隔
        if event_id in seen or used_chars + cost > char_budget:
            continue
        seen.add(event_id)
        selected.append((item["text"], score))
        used_chars += cost
        if len(selected) == context_budget:
            break
    return selected

candidates = [
    {"event_id": "refusal", "text": "玩家昨天拒绝帮助守门人。", "similarity": 0.86, "importance": 0.95, "age_hours": 24},
    {"event_id": "watermill", "text": "玩家三个月前帮村民修好水车。", "similarity": 0.82, "importance": 0.70, "age_hours": 2160},
    {"event_id": "amulet", "text": "玩家两天前归还了守门人的护符。", "similarity": 0.89, "importance": 0.90, "age_hours": 48},
]
selected = select(candidates)
for text, score in selected:
    print(f"{text} | score={score:.3f}")
print(f"selected={len(selected)}")
预期输出
玩家昨天拒绝帮助守门人。 | score=0.908
玩家两天前归还了守门人的护符。 | score=0.902
selected=2
两个上限都要满足,去重或候选过长时可以少于两条。这里字符预算仅演示裁剪,还需在真实模型上以实际 tokenizer 计算序列化后的 token 数,为系统说明、当前输入和输出预留空间。
不要让新鲜度压过关键事实
新鲜度适合处理“最近发生什么”,却不应该让长期事实全部消失。例如“玩家曾发誓保护 NPC”可能几个月没更新,但它仍然是角色关系的重要背景。因此可以把高重要性事件设置最低保留条件,或者单独维护长期稳定记忆区。
还要防止重复事件占满上下文。多条记忆可能只是同一事件的不同表述,可以在重排后做去重或按事件 ID 合并,再把空间留给不同类型的关键信息。
最终送给模型的记忆应该是一个小而有解释力的集合:既能回答当前场景,又不会因为大量次要回忆稀释角色真正重要的历史。