
游戏 AI / 系统课时
目标如何影响 NPC 决策
目标如何影响 NPC 决策
本课解决 NPC 只对玩家最后一句话作出反应的问题。通过把长期目标、当前目标和环境约束放进同一个决策上下文,角色才能在不同场景下保持一致的动机,并根据目标优先级选择行动。
学习目标
- 区分长期目标、当前目标与环境约束在决策中的职责
- 学会用目标优先级解释 NPC 为什么选择某个行动
- 能识别“有上下文但没有目标”导致的随机化决策
把三类信息放进同一个决策上下文
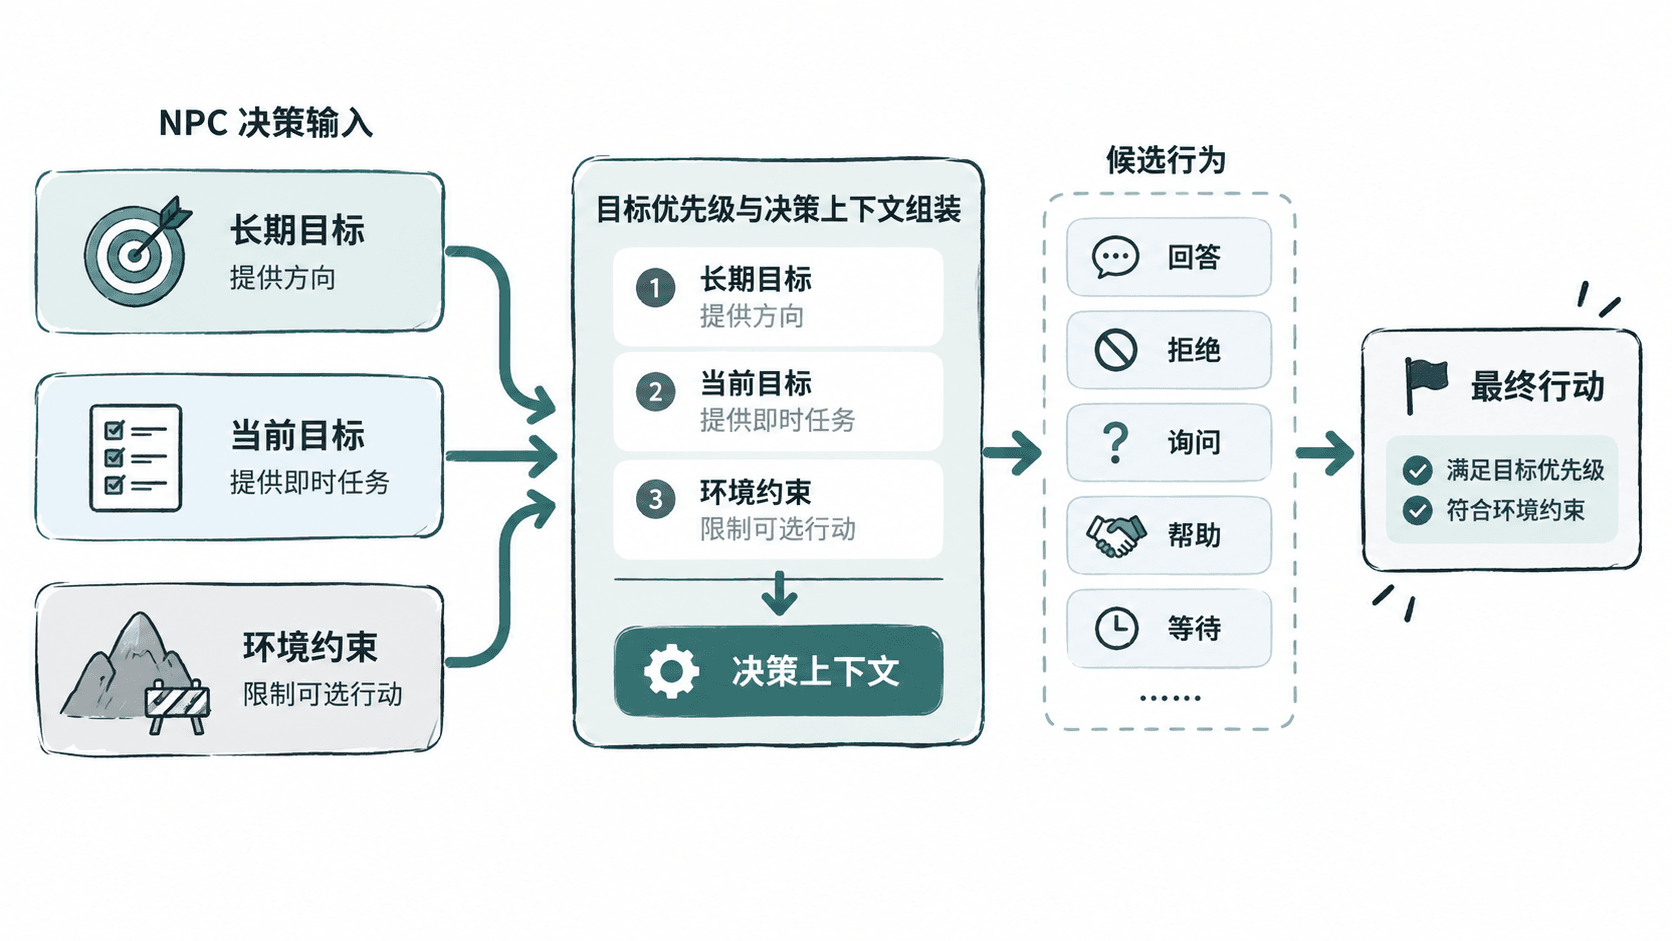
NPC 的一句回答通常不是由玩家当前输入单独决定的。更稳定的做法,是同时提供角色想长期达成什么、眼下最急着完成什么,以及当前环境允许或禁止什么。
长期目标决定角色总体方向,例如守卫希望保护城门、商人希望维持店铺信誉。当前目标决定此刻要推进的事情,例如确认玩家身份、追回欠款或赶在夜禁前离开。环境约束则限定行动边界,例如城门已关闭、玩家没有通行证或附近存在敌对势力。
三类信息同时存在时,NPC 的反应可以保持连续性:玩家提出交换时,商人不会因为一句话突然放弃维持信誉;守卫面对熟人时,也不会因为关系较好就无视仍然有效的安全规则。
目标优先级决定冲突时怎么选
真正需要设计的是目标之间发生冲突时的裁决规则。一个 NPC 可以同时想完成任务、保护某个人、遵守制度,但这些目标不一定总能同时满足,因此不能让模型自行猜测哪一个更重要。
可以把目标写成带优先级的决策条件。长期目标通常提供稳定方向,当前目标负责推动情节,环境约束和硬规则则优先于普通偏好。比如守卫的长期目标是“保护城门”,当前目标是“核验夜间访客”,而“没有合法通行证不得放行”属于硬约束。即使玩家不断解释,NPC 也可能继续拒绝开门,但可以提出补办证明、联系上级等替代方案。
一个实用原则是:目标负责回答“想达成什么”,规则负责回答“哪些手段不能用”。这样生成结果不会因为语言流畅而突破角色边界。
先筛选允许的动作,再按目标选择
def decide(*, valid_pass: bool, alarm: bool, rescue_clearance: bool, trusted: bool) -> str:
    # 本函数接收服务器核验后的事实,不直接解析玩家对白。
    allowed = {"deny_entry"}
    if valid_pass:
        allowed.add("admit")
    if alarm and rescue_clearance:
        allowed.add("escort_rescue_team")
    if trusted:
        allowed.add("explain_requirements")
    # 列表顺序同时定义目标优先级和同一输入的稳定结果。
    priority = ("escort_rescue_team", "admit", "explain_requirements", "deny_entry")
    return next(action for action in priority if action in allowed)

state = dict(valid_pass=False, alarm=True, rescue_clearance=False, trusted=True)
assert decide(**state) == "explain_requirements"
assert decide(**{**state, "trusted": False}) == "deny_entry"
assert decide(**{**state, "valid_pass": True}) == "admit"
assert decide(**{**state, "rescue_clearance": True}) == "escort_rescue_team"
assert decide(**{**state, "alarm": False, "rescue_clearance": True}) == "explain_requirements"
print(decide(**state))
本例输出 explain_requirements。警报与救援授权都经服务端确认才开放护送动作。信任只增加解释选项。模型可以把结果写成对白,真正执行开门或护送前应在写入事务中重查凭证、授权和场景版本。旧快照失效时重新决策或回退到等待核验。
让决策连续,而不是被最后一句话牵着走
只把最近一轮玩家输入送入模型时,NPC 很容易出现行为漂移。玩家上一句要求帮助,NPC 就立即答应;下一句威胁,NPC 又突然敌对,前面的目标与立场仿佛从未存在。
改进方式不是无限堆历史对话,而是把与决策直接相关的状态整理成短上下文。例如保留“当前任务为核验身份”“玩家尚未提供通行证”“守卫必须保护城门”这几个事实,再加入最新输入。模型面对的就不再是孤立的一句话,而是一个受约束的决策问题。
可以把一次决策理解为:先读取稳定目标,再检查当前目标进度,随后应用环境约束,最后从允许的行为中选择最符合目标的行动。对话只是触发因素,而不是唯一依据。
什么时候应该改变目标
稳定人格并不意味着目标永远不变。角色目标可以在明确事件发生后迁移,例如任务完成、阵营关系改变、城门失守或角色收到新的命令。
关键是区分“目标变化”和“对白变化”。玩家说了一句挑衅的话,通常只会改变当前交互策略,不应该直接改写长期目标;任务完成这一类权威事件,才适合推动目标状态迁移。
因此,在动态剧情系统中,NPC 的行为最好由可追踪的状态变化驱动,而不是由模型自行宣布“从此我改变立场”。当目标变化有明确事件证据时,后续对白才能稳定地反映新状态。