
游戏 AI / 系统课时
哪些 AI 请求应该放服务端
哪些 AI 请求应该放服务端
这一课要解决的核心问题是:哪些信息可以留在客户端,哪些 AI 请求必须经过服务端。最终形成客户端负责表现、服务端负责权威状态、AI 服务负责生成的边界,并让密钥和关键规则始终留在受控环境中。
学习目标
- 区分客户端、游戏服务端和 AI 服务的职责边界
- 设计不会暴露模型密钥的 AI 请求链路
- 判断哪些上下文和输出必须经过服务端校验
先把三类职责分开
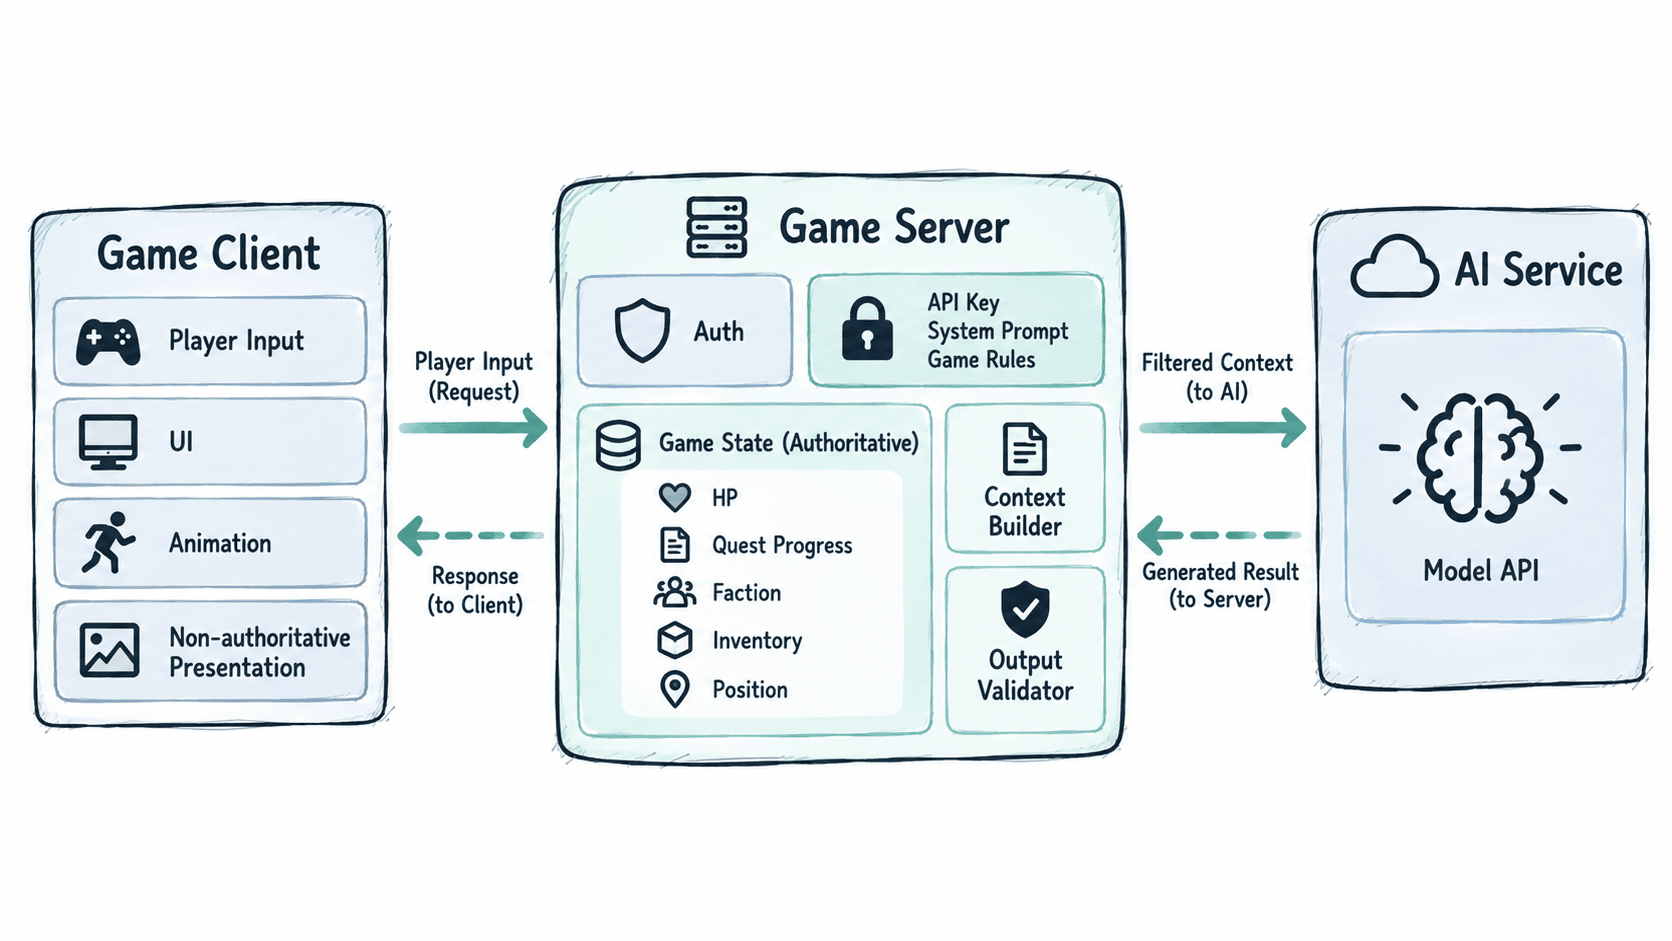
客户端最适合处理输入采集、动画、UI 和非敏感表现数据。服务端应保存任务进度、关系、库存、阵营、权限等权威状态,并决定一次 AI 请求允许看到哪些上下文。AI 服务负责生成文本、情绪或叙事建议,但不应直接成为游戏规则的最终裁判。
因此,“玩家一句话直接调用模型”通常不是完整架构。真正安全的链路应是客户端发送业务意图或对话输入,服务端读取权威状态并组装受限上下文,再由服务端调用 AI 提供商,最后把经过校验的结果返回客户端。
为什么模型调用通常放服务端
最直接的原因是密钥安全。只要把模型 API Key 放进客户端包、网页脚本或可下载资源,攻击者就可以通过反编译、网络检查或运行时调试取得它。即使客户端代码经过压缩或混淆,也不能把它当作真正的密钥保护措施。
第二个原因是规则安全。服务端才能决定玩家当前真的拥有哪些任务、阵营和物品。客户端上报“玩家已经完成任务”不等于任务真的完成;客户端上报“NPC 应该信任玩家 100 点”也不应直接改变关系数据。
第三个原因是成本和速率控制。服务端可以统一限制请求频率、上下文长度、模型选择和超时策略,还能记录 requestId 与结果状态,便于定位一次异常生成来自哪里。
让客户端只发送必要输入
客户端不需要把完整世界状态全部发送给 AI。接口只接收业务需要的字段,例如 npcId 和当前对话文本。服务端从登录会话取得玩家身份,再判断该玩家在当前存档、分支和场景里能否与这个 NPC 交互。
下面是一个可独立运行的 Node.js 示例,用 HTTP 服务模拟这一职责边界。示例只绑定本机,采用每次启动随机生成的教学会话,并模拟模型回复。线上由真实登录中间件解析会话,模型适配器从服务端密钥存储取凭证。
const http = require("node:http");
const {randomUUID} = require("node:crypto");

const PORT = Number(process.env.PORT ?? 3000);
const demoSession = randomUUID();
const players = new Map([
  ["player-01", { nearby: new Set(["npc-01"]), escortCompleted: true }],
  ["player-02", { nearby: new Set(["npc-02"]), escortCompleted: false }],
]);
const sessions = new Map([[demoSession, "player-01"]]);

function send(res, status, payload, headers = {}) {
  res.writeHead(status, {"content-type": "application/json", ...headers});
  res.end(JSON.stringify(payload));
}

const server = http.createServer({requestTimeout: 5000}, (req, res) => {
  if (req.method !== "POST" || req.url !== "/ai/dialogue") {
    send(res, 404, {error: "not_found"});
    return;
  }
  const token = /^Bearer ([^\s]+)$/i.exec(req.headers.authorization ?? "")?.[1];
  const playerId = sessions.get(token);
  const state = players.get(playerId);
  if (!state) {
    send(res, 401, {error: "authentication_required"});
    return;
  }
  let size = 0;
  const chunks = [];
  req.on("data", chunk => {
    if (size > 4096) return;
    size += chunk.length;
    if (size > 4096) {
      send(res, 413, {error: "body_too_large"}, {connection: "close"});
      return;
    }
    chunks.push(chunk);
  });
  req.on("end", () => {
    if (size > 4096) return;
    let input;
    try {
      input = JSON.parse(Buffer.concat(chunks).toString("utf8"));
    } catch {
      send(res, 400, {error: "invalid_json"});
      return;
    }
    if (!input || typeof input.npcId !== "string" ||
        typeof input.playerText !== "string" || !input.playerText.trim() ||
        input.playerText.length > 500 ||
        Object.keys(input).some(key => !["npcId", "playerText"].includes(key))) {
      send(res, 400, {error: "invalid_input"});
      return;
    }
    if (!state.nearby.has(input.npcId)) {
      send(res, 403, {error: "npc_out_of_scope"});
      return;
    }
    const context = {playerText: input.playerText, escortCompleted: state.escortCompleted};
    // 本地模拟生成。真实模型密钥由服务端适配器加载。
    const reply = context.escortCompleted ? "守卫:谢谢你完成护送。" : "守卫:你找我?";
    send(res, 200, {reply});
  });
  req.on("error", () => { if (!res.headersSent && !res.destroyed) send(res, 400, {error: "read_failed"}); });
});

server.listen(PORT, "127.0.0.1", () => {
  console.log("Local demo port: " + server.address().port);
  console.log("Local demo session: " + demoSession);
});
预期输出
Local demo port: 3000
Local demo session: <每次启动生成的随机值>
保存为 dialogue.cjs 后用 node dialogue.cjs 启动。在本机用 POST 请求 /ai/dialogue,把日志里的随机值填到 Authorization: Bearer <会话值>,请求体使用 {"npcId":"npc-01","playerText":"你好"}。返回 JSON 只包含 reply。替换成 npc-02 应得到 403,增加 playerId 应得到 400。上线时应关掉教学会话输出,按真实身份限流,并把模型返回的文本或结构化建议送入业务校验。
哪些请求一定不要直接放客户端
凡是包含密钥、隐藏系统提示、完整受限世界状态或需要修改权威游戏状态的请求,都应优先放服务端。典型例子包括购买后剧情生成、阵营关系判断、任务奖励建议、受限 NPC 记忆检索以及任何会改变服务端数据的 AI 操作。
纯表现类请求则可以更灵活。例如客户端可以本地决定 UI 动画速度、输入框效果或已经缓存好的非敏感文本展示。判断标准不是“用了 AI 就必须上服务端”,而是这次请求是否涉及秘密、权威状态、计费资源或可被滥用的规则。
| 请求内容 | 推荐位置 | 原因 |
|---|---|---|
| 玩家输入、按钮点击、UI 状态 | 客户端 | 属于交互与表现 |
| 任务进度、库存、阵营、关系 | 服务端 | 必须保持权威 |
| 模型 API Key | 服务端 | 不能暴露给客户端 |
| 允许检索的记忆 | 服务端 | 需要按权限筛选上下文 |
| AI 生成对白 | 服务端或受控 AI 层 | 需要统一限流与校验 |
| 最终奖励与状态写入 | 服务端 | 客户端不能直接裁决 |
给 AI 的上下文也要经过边界控制
把请求放到服务端并不等于把整个数据库丢给模型。服务端仍需要执行最小权限原则,只提供本次生成确实需要的信息,例如当前 NPC 的身份、与玩家的关系阶段、最近几条相关记忆和当前剧情阶段。
尤其要把“模型可参考的信息”和“模型不可修改的事实”分开。模型可以根据 questProgress=completed 生成更自然的对白,但不能因为自己生成了“奖励已发放”就让服务端自动写入库存。涉及状态变更时,应由明确的业务 API 或规则层决定是否执行。
当游戏运行链路采用“客户端输入 → 服务端取权威状态 → 受限上下文 → AI 服务 → 服务端校验 → 客户端表现”这一边界后,密钥、规则与状态都有明确归属,后续才能继续加入限流、审计、缓存和故障降级,而不用重新拆架构。