
游戏 AI / 系统课时
手算一次完整A*搜索
手算一次完整A*搜索
只看公式很容易觉得 A* 是“挑最小的 一直走”,但真正执行搜索时还要同时维护开放集、关闭集、、、 和父节点。本节在一个很小的四方向网格上手算完整搜索,重点观察候选节点如何更新,以及最终路径为什么要沿父节点反向恢复。
学习目标
- 能逐轮记录开放集、关闭集和节点的
- 理解发现更低 时为什么要更新父节点
- 能从目标节点沿父节点链恢复最终路径
先固定地图与计分规则
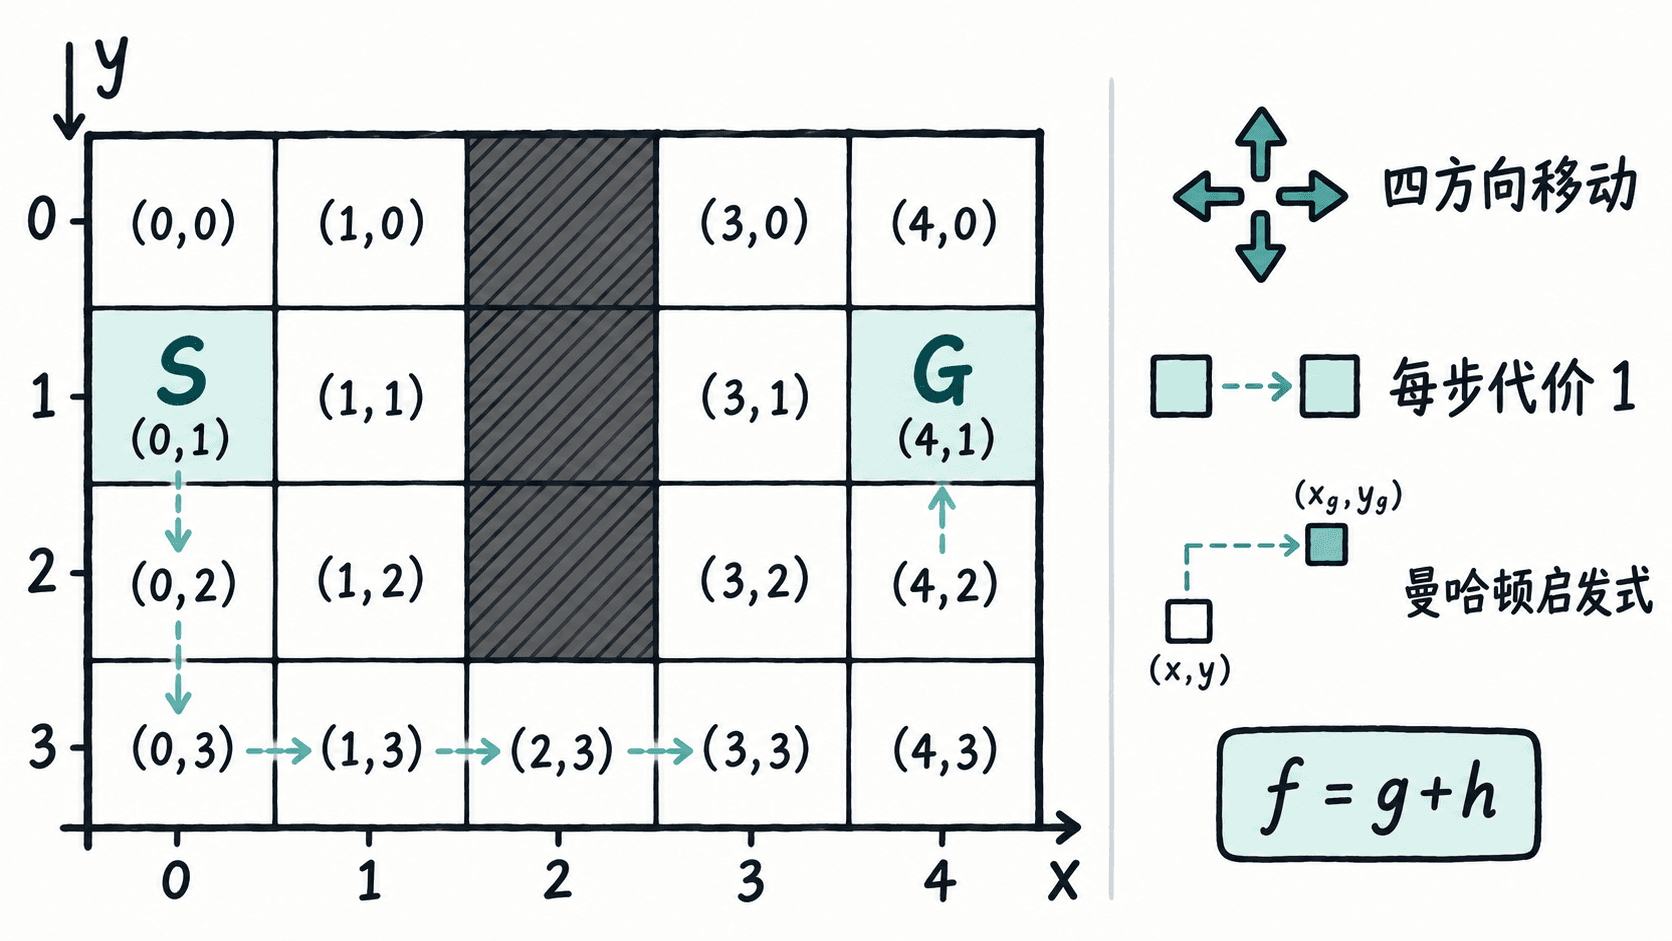
使用 5×4 网格,只允许上、下、左、右移动,每步代价为 1。起点是 S=(0,1),目标是 G=(4,1),障碍位于 (2,0)、(2,1)、(2,2),因此角色必须从墙的下方绕过去。
启发式采用曼哈顿距离:
总评分仍然是 。若多个节点 相同,本节为了让演算唯一,约定优先选择 更小的节点;若仍相同,再按坐标从左到右、从上到下选择。
从起点展开到墙前
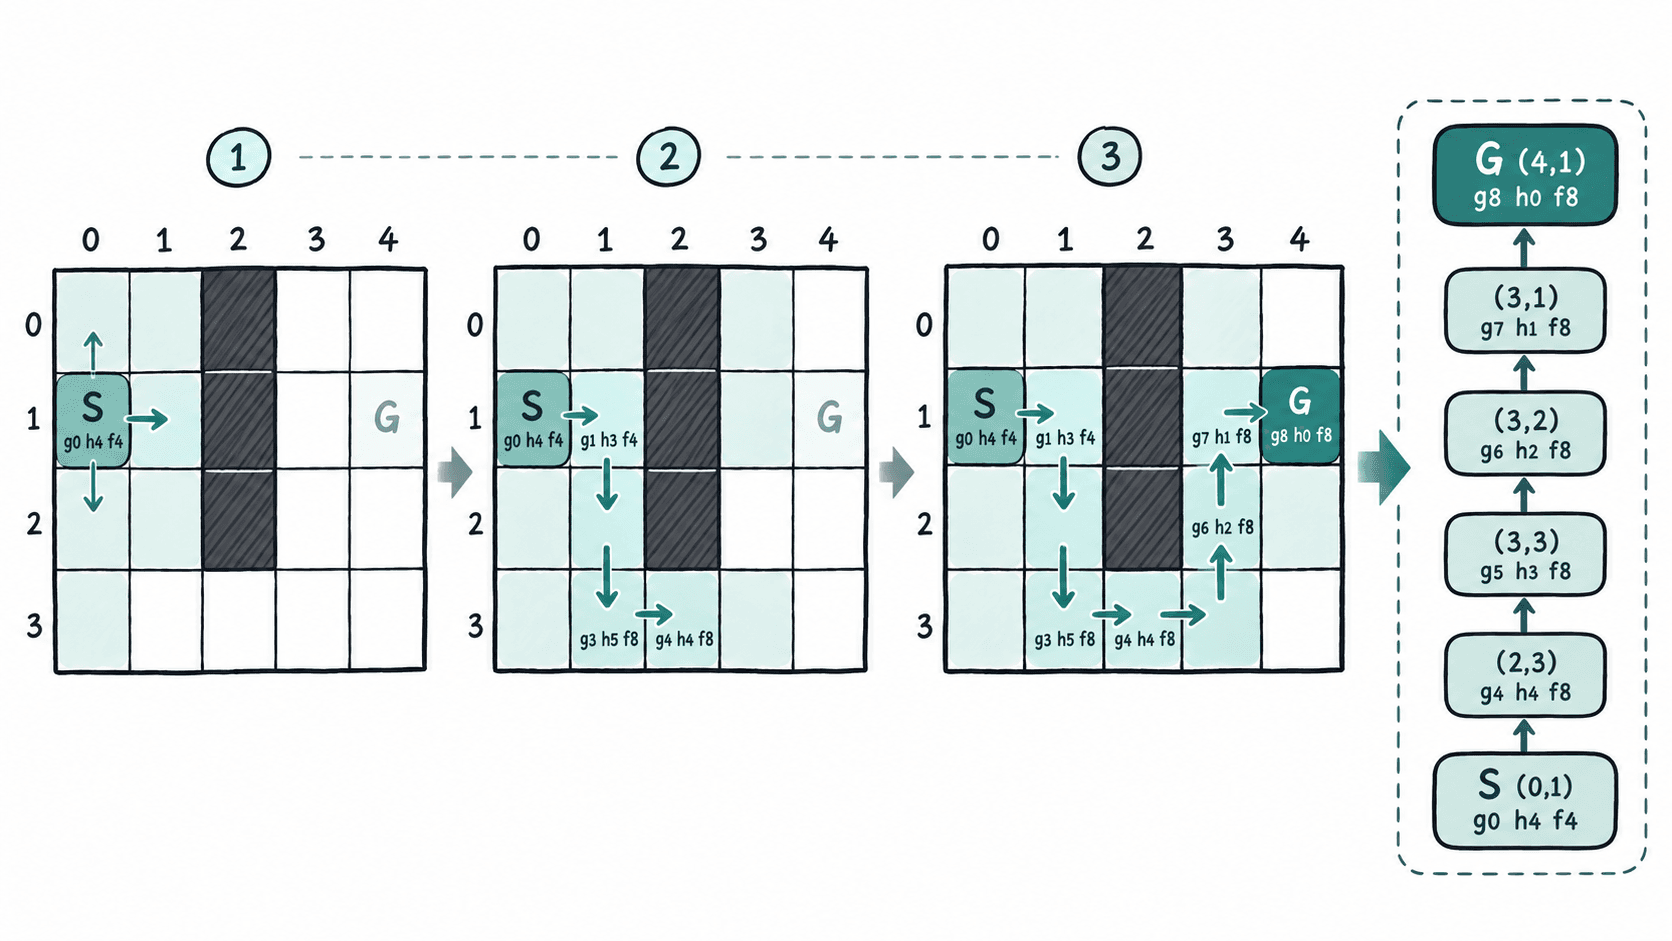
初始化时,开放集只有起点。起点的 ,到目标的曼哈顿距离为 4,所以 。取出 S=(0,1) 后,把它放入关闭集,并检查可走邻居。
第一轮可加入 (1,1)、(0,0)、(0,2)。它们的评分如下:
| 节点 | g | h | f | 父节点 |
|---|---|---|---|---|
| (1,1) | 1 | 3 | 4 | (0,1) |
| (0,0) | 1 | 5 | 6 | (0,1) |
| (0,2) | 1 | 5 | 6 | (0,1) |
按约定先选 (1,1)。它右侧 (2,1) 是障碍,因此只能继续产生 (1,0) 和 (1,2),两者都得到 、、。此时开放集中的候选节点全部为 。
搜索怎样绕过障碍
接下来按 、 和坐标顺序继续选择节点。墙上方的 (1,0) 无法跨过 (2,0),而下方分支会经过 (1,2)、(1,3),最终到达位于障碍底部的 (2,3)。一旦绕到墙右侧,启发式值开始快速下降,搜索就会被目标方向吸引。
关键节点的评分如下:
| 被展开节点 | g | h | f | 新增关键节点 |
|---|---|---|---|---|
| (1,2) | 2 | 4 | 6 | (1,3) |
| (1,3) | 3 | 5 | 8 | (2,3) |
| (2,3) | 4 | 4 | 8 | (3,3) |
| (3,3) | 5 | 3 | 8 | (4,3)、(3,2) |
| (3,2) | 6 | 2 | 8 | (4,2)、(3,1) |
| (3,1) | 7 | 1 | 8 | (4,1) |
当 (4,1) 被加入开放集时,它的 、、。标准 A* 通常在目标节点被真正取出作为当前节点时结束,而不是“第一次看见目标”就立刻结束,这样可以让终止条件与开放集的最小评分保持一致。
父节点为什么可能被改写
手算时最容易漏掉的规则是:一个节点已经在开放集中,并不代表它的路径已经确定。若后来从另一个当前节点到达它,得到更小的候选代价,就必须更新它的 和父节点。
候选代价可写成:
只有当 neighbor 从未被发现,或者 时,才用当前节点替换它的父节点。这样父节点链始终保存“目前已知最便宜的到达方式”,最终回溯出来的才是最短路径。
在本例中,因为所有边代价相同且地图很小,最终路径上的关键节点没有发生二次改写。但到了泥地、道路代价不同的加权地图中,同一个节点完全可能先通过昂贵路线被发现,随后再被更便宜的路线更新。
从目标反向恢复完整路径
目标 (4,1) 的父节点是 (3,1),继续沿父节点回溯,可得到:
(4,1) ← (3,1) ← (3,2) ← (3,3) ← (2,3) ← (1,3) ← (1,2) ← (1,1) ← (0,1)
将顺序反转后,最终路径是:
(0,1) → (1,1) → (1,2) → (1,3) → (2,3) → (3,3) → (3,2) → (3,1) → (4,1)
这条路径共移动 8 步,因此目标节点的 。它也说明了 A* 的两个职责是分开的:搜索阶段不断改进“到达每个节点的最优已知代价”,真正的路径序列则在命中目标后,通过父节点链一次性恢复。