
游戏 AI / 系统课时
g、h、f分别在算什么
g、h、f分别在算什么
A* 每次都要在一批候选节点里决定“下一步先扩展谁”。真正驱动这个决定的就是 g、h、f:一个记录已经付出的代价,一个估计剩余代价,一个把两者合并成排序依据。理解三者分工后,A* 的搜索过程就不再像黑盒。
学习目标
- 能分别说明
g、h、f的含义以及它们在搜索中的职责 - 能根据同一批候选节点判断 A* 会优先扩展哪个节点
- 能理解启发式估计过大、过小分别会带来什么影响
g 是已经走过的真实代价
g(n) 表示从起点走到当前节点 n 的累计代价。它只统计已经发生的部分,因此通常来自实际移动成本,例如直走一格代价为 1,进入泥地额外加权,或者某些区域被赋予更高通行成本。
如果起点为 S,从 S 到 A 花费 2,再从 A 到 B 花费 3,那么:
g 越小,说明当前这条已走路径越便宜;但只看 g 会倾向于在起点附近大量扩散,缺少“朝目标前进”的方向感。
h 是还没走的估计代价
h(n) 是从当前节点到目标的启发式估计。它不是已经发生的真实成本,而是告诉搜索算法“这个节点看起来离目标还有多远”。
四方向方格地图常用曼哈顿距离:
允许任意方向移动时,可以考虑欧氏距离;允许八方向且直走、斜走成本不同,则通常选择与移动规则匹配的估计方式。关键不是公式越复杂越好,而是启发式要和实际移动模型一致。
f 是当前节点的综合评分
A* 用下面的评分把“已经花了多少”和“预计还要花多少”合在一起:
搜索时通常从开放集合中选择 f 最小的节点继续扩展。于是 g 负责约束已经付出的成本,h 负责提供朝目标的方向,f 则负责最终排序。
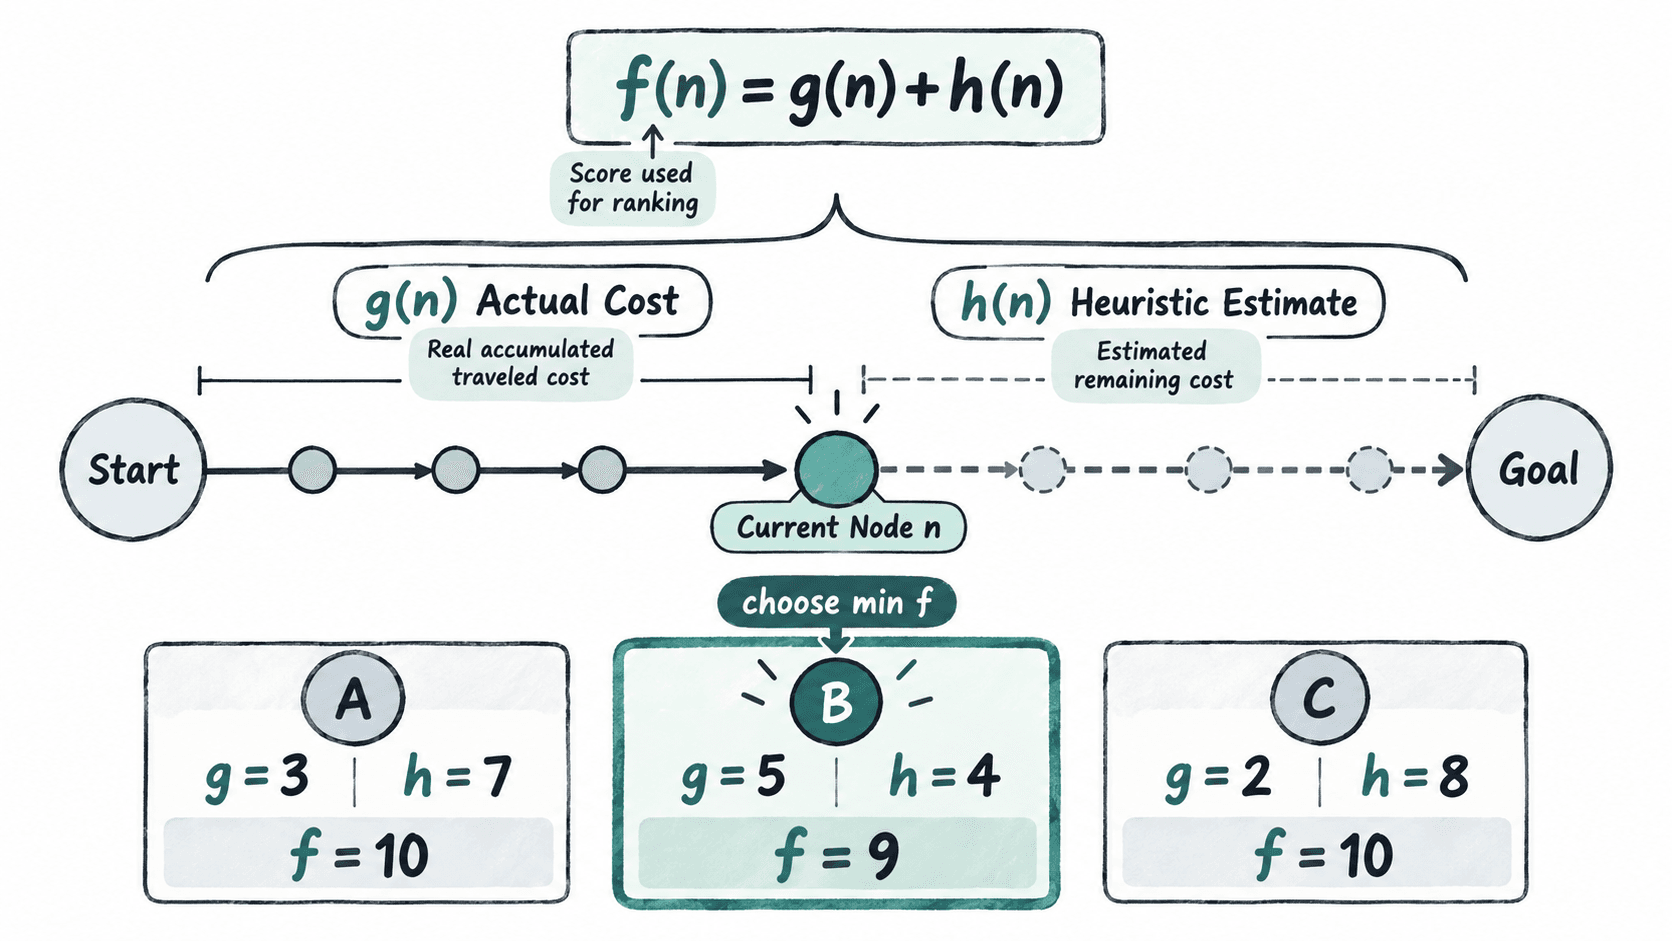
假设开放集合中有三个候选节点:
| 节点 | g |
h |
f = g + h |
|---|---|---|---|
| A | 4 | 6 | 10 |
| B | 7 | 2 | 9 |
| C | 3 | 8 | 11 |
虽然 B 已经走过的成本 g 最高,但它离目标的估计距离 h 很小,因此 f 最低,A* 会优先扩展 B。
用代码看一次排序结果
下面的最小示例直接计算三个节点的 f,再选出评分最低者。它没有实现完整 A*,只聚焦本课的节点评分规则。
nodes = [
    {"name": "A", "g": 4, "h": 6},
    {"name": "B", "g": 7, "h": 2},
    {"name": "C", "g": 3, "h": 8},
]

for node in nodes:
    node["f"] = node["g"] + node["h"]

best = min(nodes, key=lambda node: node["f"])

for node in nodes:
    print(f'{node["name"]}: g={node["g"]}, h={node["h"]}, f={node["f"]}')

print("expand:", best["name"])
预期输出:
A: g=4, h=6, f=10
B: g=7, h=2, f=9
C: g=3, h=8, f=11
expand: B
实际 A* 还会维护开放集合、关闭集合、父节点和更优路径更新,但节点优先级判断的核心仍是同一个 f = g + h。
h 太弱或太强会怎样
如果把 h 全部设为 0,那么 f 就只剩 g,A* 会退化成类似 Dijkstra 的搜索:仍能按累计代价找到最优路径,但通常会扩展更多无关节点。
如果 h 明显高估真实剩余代价,算法会更偏向“看起来离目标近”的方向,搜索可能更快,却可能错过总代价更低的路线。因此调启发式时,不要只看寻路速度,还要确认是否仍满足你的最优路径要求。
判断三者时可以记住一句话:g 回头看已经付出的成本,h 向前估计还要付出的成本,f 用两者之和决定当前最值得继续搜索的节点。