
游戏 AI / 系统课时
什么时候该换分层或预计算
什么时候该换分层或预计算
普通网格 A* 足以解决很多关卡,但地图持续扩大、查询频率升高后,单纯优化堆或节点对象只能降低常数成本。本节建立一个更实用的判断方法:根据地图规模、静态程度和查询频率,决定继续使用平面 A*,还是换成分层图、稀疏路网或预计算结果。
学习目标
- 判断性能瓶颈是否已经超出单次 A* 微优化能够解决的范围
- 区分分层寻路、稀疏路网和预计算分别适合什么地图
- 用实际统计数据而不是固定地图尺寸决定架构切换时机
先看规模、变化和查询频率
决定是否换方案时,最重要的不是“地图看起来很大”,而是三个量同时造成了什么搜索成本。
- 地图规模:可搜索节点越多,长距离搜索可能接触的候选节点越多。
- 静态程度:障碍频繁变化时,预先计算的结果会很快失效;长期稳定的地图则更适合复用结果。
- 查询频率:偶尔执行一次长距离搜索,与每秒几十甚至上百次搜索,对架构的要求完全不同。
如果主要问题只是少量异常请求,应先设置搜索预算并修复异常地图。只有当大量正常请求都稳定触及较高节点数时,才说明搜索空间本身已经值得分层。
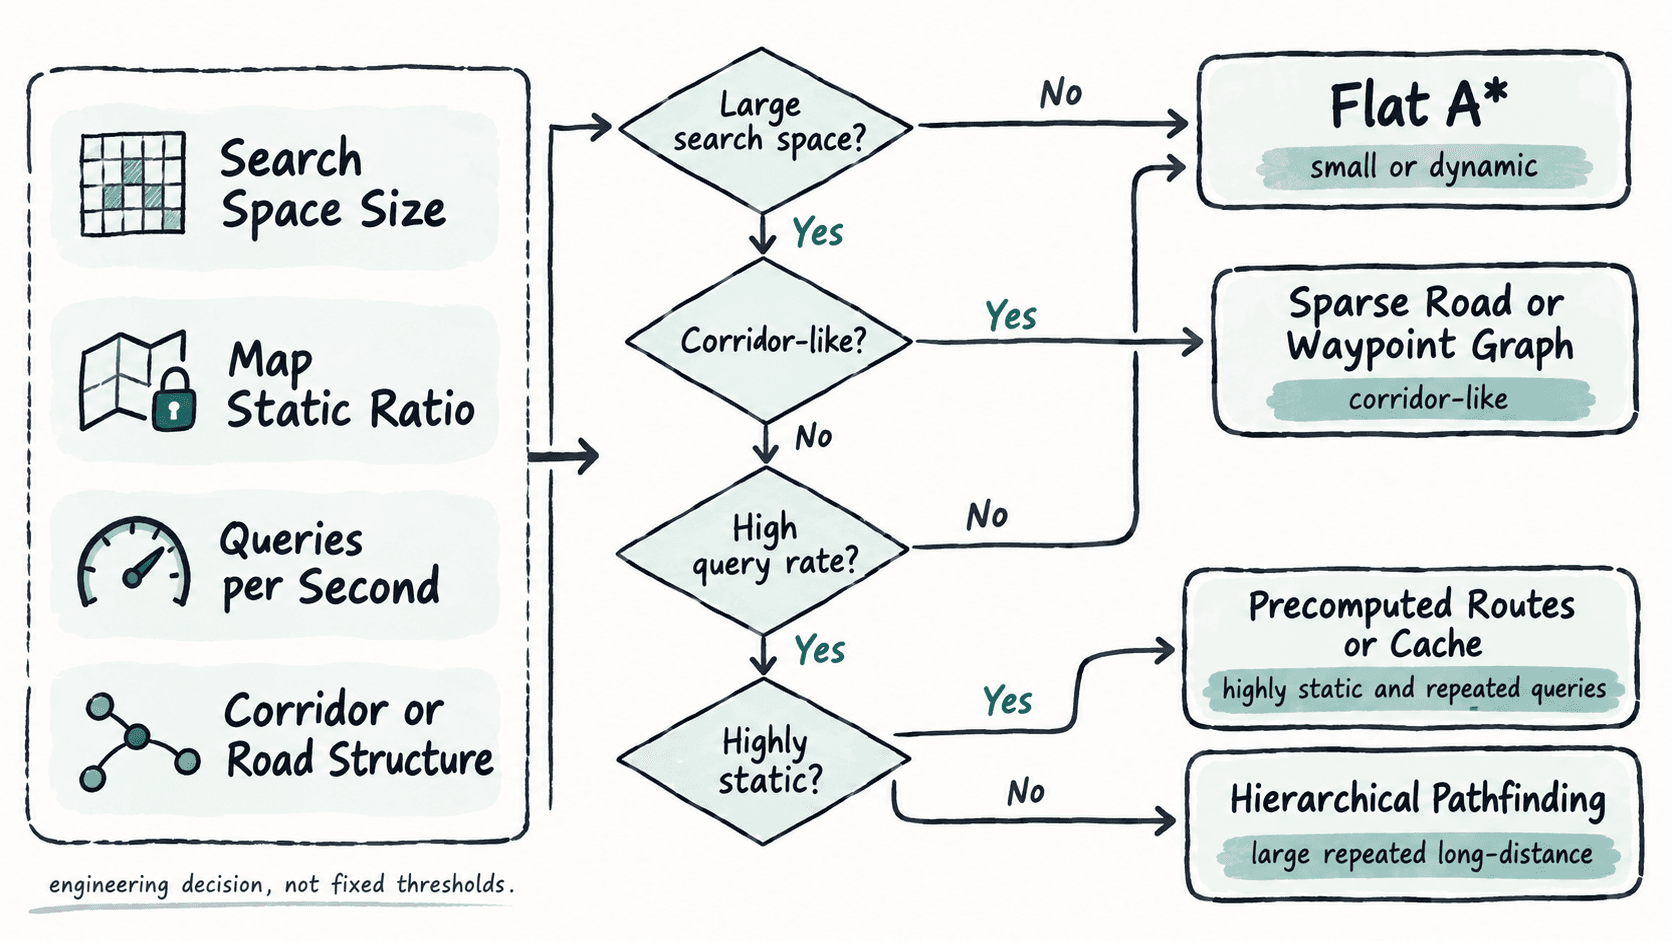
分层寻路解决的是搜索空间过大
分层寻路的核心是先在粗粒度结构上决定“经过哪些区域”,再进入具体区域计算局部路径。假设一个大地图被划成若干区域,并在区域之间保留入口节点,长距离搜索就不必一开始遍历整张细网格。
典型执行过程是:先把起点和终点映射到区域,在区域图上得到粗路径,再只对相关区域进行局部 A*。这样会引入额外的数据构建、入口维护和局部拼接逻辑,但可以显著减少远距离查询需要接触的细粒度节点。
当监控数据显示长距离请求普遍展开大量节点,而地图又具有明显的房间、街区、楼层或区块结构时,分层通常比继续压缩单个节点对象更值得投入。
如果可移动空间本身就是道路、航线、走廊或固定连接点,则可以进一步使用稀疏路网。此时角色不必在每个网格之间搜索,而是在少量关键节点组成的图上规划主路径,再处理起点和终点附近的局部接入。
预计算适合稳定且重复的问题
预计算的价值来自“同一问题会反复出现”。例如地图基本不变,而且大量单位持续查询相同区域之间的路线,就可以提前保存区域间下一跳、关键路径或常用路线缓存,运行时直接复用。
但不要轻易为每两个细网格节点保存完整路径。如果节点数为 ,全节点对结果的规模可能达到 ,地图一大就会带来明显的内存、构建时间和更新成本。更常见的做法是只对区域、门户、路网节点或高频起终点进行预计算。
动态门、可破坏障碍和临时封路越多,预计算结果的失效管理越复杂。此时可以只预计算高层区域关系,让局部网格仍然实时搜索,而不是要求整个系统完全静态。
用监控数据触发架构升级
下面的 Java 程序把几个监控指标转成方案建议。阈值只是演示如何建立决策规则,并不是通用标准;实际项目应根据设备预算、地图结构和真实 p95 搜索数据重新标定。
public class PathfindingStrategyAdvisor {
    enum Strategy {
        FLAT_ASTAR,
        HIERARCHICAL,
        ROAD_GRAPH,
        PRECOMPUTED
    }

    record Scene(
            int walkableNodes,
            double staticRatio,
            int queriesPerSecond,
            boolean corridorLike) {}

    static Strategy choose(Scene scene) {
        if (scene.corridorLike() && scene.walkableNodes() >= 200_000) {
            return Strategy.ROAD_GRAPH;
        }
        if (scene.staticRatio() >= 0.98 && scene.queriesPerSecond() >= 100) {
            return Strategy.PRECOMPUTED;
        }
        if (scene.walkableNodes() >= 200_000
                && scene.queriesPerSecond() >= 20) {
            return Strategy.HIERARCHICAL;
        }
        return Strategy.FLAT_ASTAR;
    }

    public static void main(String[] args) {
        System.out.println("dungeon=" + choose(
                new Scene(30_000, 0.70, 8, false)));
        System.out.println("openWorld=" + choose(
                new Scene(800_000, 0.85, 40, false)));
        System.out.println("staticArena=" + choose(
                new Scene(120_000, 0.995, 180, false)));
        System.out.println("roads=" + choose(
                new Scene(500_000, 0.95, 30, true)));
    }
}
预期输出:
dungeon=FLAT_ASTAR
openWorld=HIERARCHICAL
staticArena=PRECOMPUTED
roads=ROAD_GRAPH
这个示例的重点不是记住 200000 或 100,而是把架构选择绑定到可以测量的数据。真实项目可以把 walkableNodes 换成典型请求的 expandedNodes p95,把 queriesPerSecond 换成实际峰值,再结合地图更新频率做判断。
不要过早把简单问题复杂化
如果普通 A* 的 p95 耗时稳定在预算内,开放集规模可控,地图又经常变化,那么引入区域图和预计算只会增加构建、同步和失效处理成本。分层算法首先优化的是搜索空间,预计算首先优化的是重复计算,它们都不是免费的性能开关。
比较稳妥的升级顺序是先确认基础 A* 正确,再做好指标统计与搜索上限;当正常长距离查询持续变贵时引入分层,当空间天然稀疏时改用路网,当地图高度稳定且查询重复率高时再预计算。架构切换的依据应来自持续出现的搜索模式,而不是单次最坏案例。