
游戏 AI / 系统课时
不同地图尺度怎样调整搜索成本
不同地图尺度怎样调整搜索成本
同一张 100 米见方的关卡,使用 2 米网格和 0.5 米网格时,A* 面对的节点规模会相差一个数量级。本节把路径精度、搜索节点数和内存放在一起比较,并说明缩放网格后怎样保持移动代价与启发式函数的单位一致。
学习目标
- 判断粗网格和细网格分别牺牲了什么、换来了什么
- 估算网格尺寸变化对节点数和内存的影响
- 调整步进代价与启发式时保持同一计量单位
网格越细,搜索空间增长越快
二维地图中,格子边长减半,横纵两个方向的格子数都会约翻倍,因此总节点数约变成 4 倍。细网格能更准确表示窄通道、障碍边缘和目标位置,但开放集合、关闭集合以及节点状态也会同步变大。
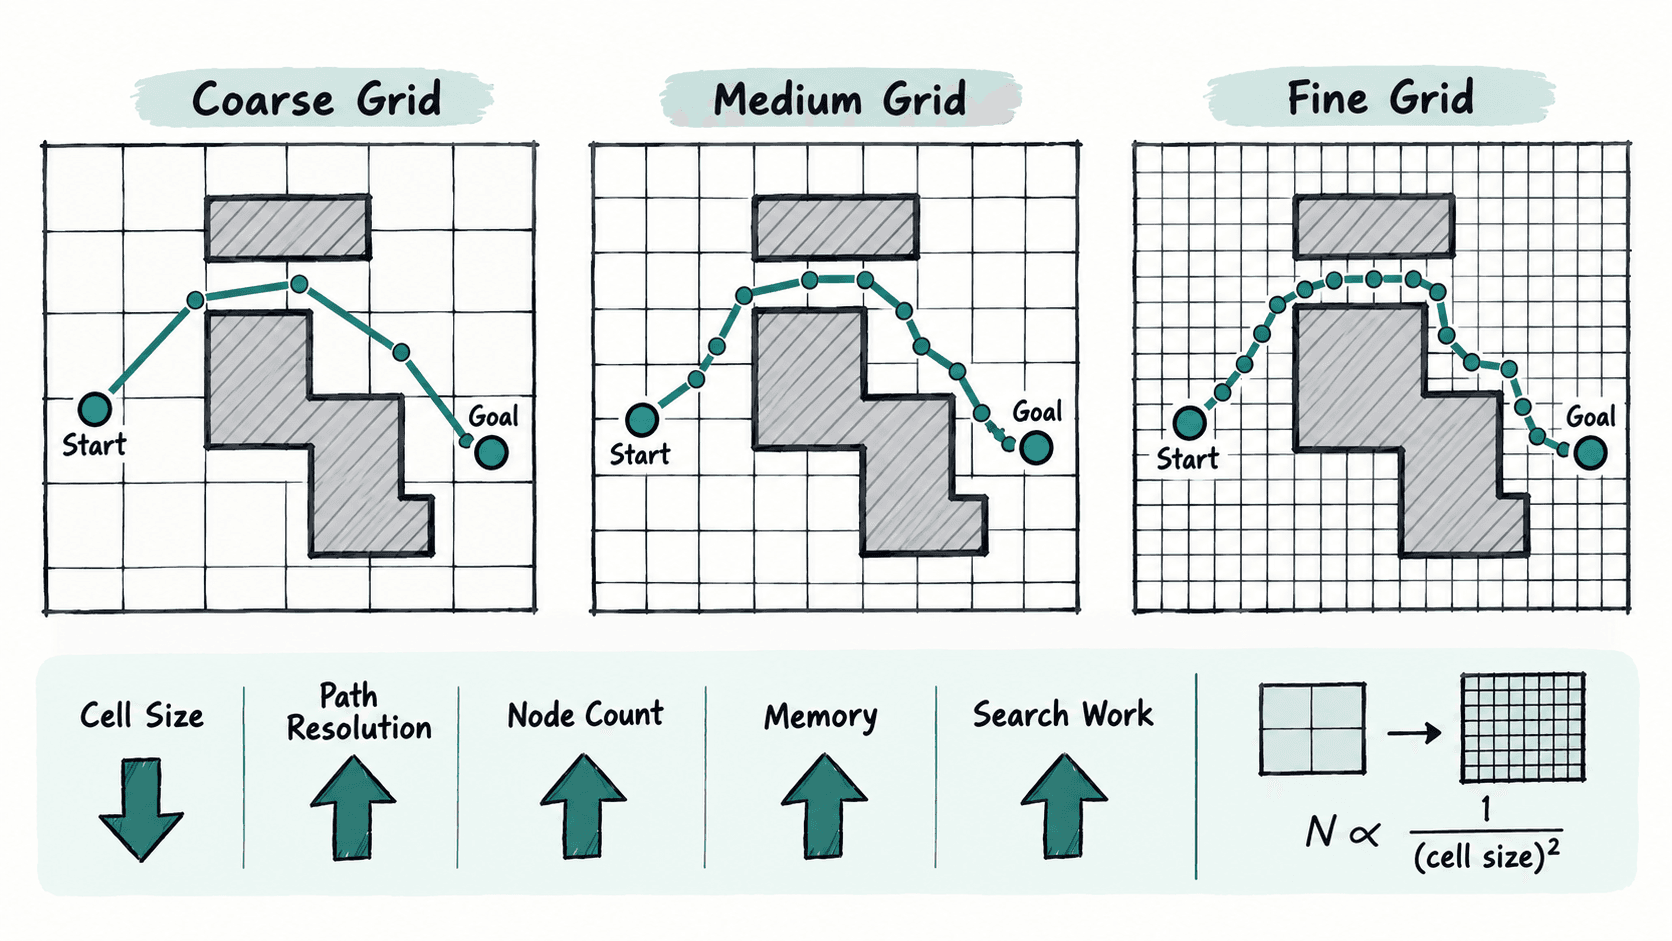
下面的可运行示例只做规模估算:把同一个 100m × 100m 区域分别离散成 2 米、1 米和 0.5 米网格,并假设每个节点状态平均占 64 字节。64 字节只是演示参数,实际值取决于你的节点结构、容器和运行时。
import math

WORLD_SIZE = 100.0
BYTES_PER_NODE = 64

for cell_size in (2.0, 1.0, 0.5):
    cols = math.ceil(WORLD_SIZE / cell_size)
    rows = math.ceil(WORLD_SIZE / cell_size)
    nodes = cols * rows
    memory_kib = nodes * BYTES_PER_NODE / 1024

    # 从任意世界点吸附到格子中心时,最坏误差约为半个格子对角线。
    max_snap_error = math.sqrt(2) * cell_size / 2

    print(
        f"cell={cell_size:.1f}m, nodes={nodes}, "
        f"memory={memory_kib:.1f}KiB, "
        f"max_snap_error={max_snap_error:.2f}m"
    )
预期输出:
cell=2.0m, nodes=2500, memory=156.2KiB, max_snap_error=1.41m
cell=1.0m, nodes=10000, memory=625.0KiB, max_snap_error=0.71m
cell=0.5m, nodes=40000, memory=2500.0KiB, max_snap_error=0.35m
这个结果说明:把格子从 1 米缩到 0.5 米,位置离散误差约减半,但节点数和示例内存都变成 4 倍。A* 实际扩展多少节点还受障碍、启发式和起终点位置影响,不能简单等同于总节点数。
让 g 与 h 使用同一单位
调整网格尺寸时最容易出错的不是节点数,而是代价单位。假设 g 表示真实世界距离,那么水平或垂直移动一格的代价应是 cellSize,对角移动则是 cellSize × √2;启发式 h 也必须按同样的世界距离计算。
如果 g 采用“每格 1 点”的抽象单位,也可以保持正确,但 h 必须同样使用格子单位。不要让 g 用米、h 用格子数,否则两者相加得到的 f 没有一致含义,搜索顺序也会被扭曲。
对于允许八方向移动的均匀网格,可以把横纵差换算成同一单位后使用 Octile 距离;如果地形还有泥地、道路等额外代价,则在步进距离之上叠加或乘以明确的地形成本,且保证所有边代价非负。
不能靠放大启发式掩盖细网格成本
地图变细后搜索变慢,直接把启发式乘上更大的权重确实可能减少扩展节点,但这已经从标准 A* 变成 Weighted A*。权重大于 1 时通常能更快靠近目标,却不再保证得到全局最优路径。
因此尺度调整应优先从表示方式入手:大型开放区域使用更粗的导航层,狭窄或关键区域使用更细表示;超大地图还可以按区块加载、分层搜索,或先做区域级路径再做局部精细搜索。只有业务允许牺牲最优性时,才把启发式权重作为明确的性能取舍。
同一项目也不必只有一个固定尺度。关键是让地图离散精度服务于角色尺寸和关卡需求,并确保任何尺度下 g、h 与地形附加代价都保持一致单位,这样性能优化才不会悄悄改变路径语义。