
HTTP 与 Web 标准 / 系统课时
解析方式应该怎样选择
解析方式应该怎样选择
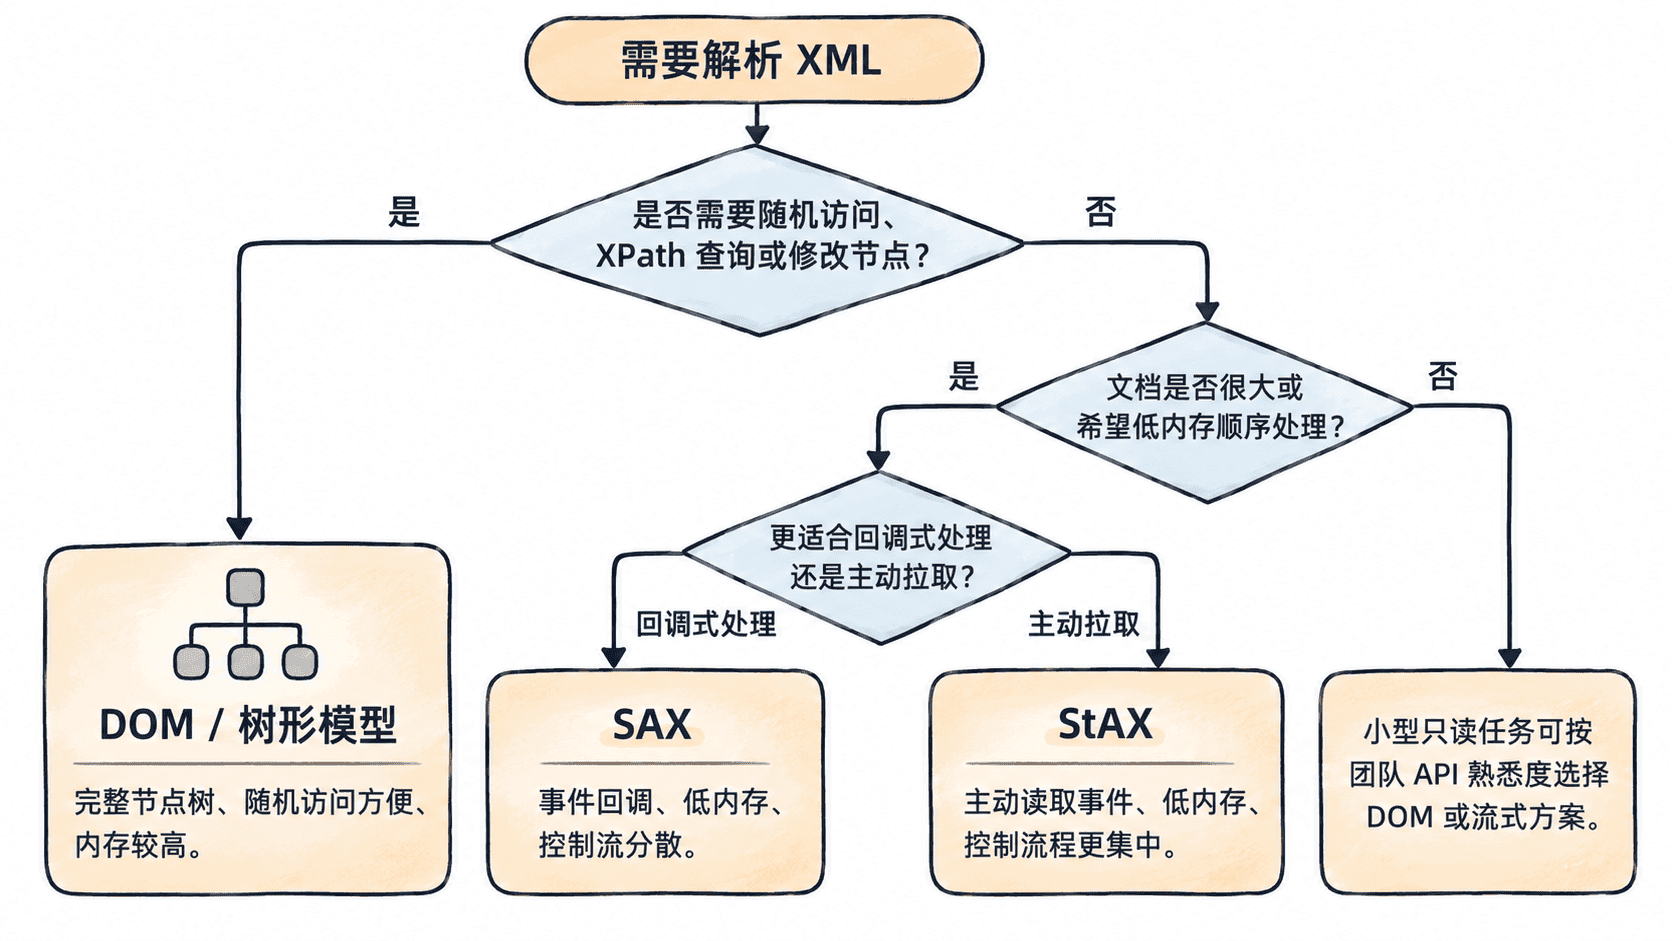
选择 XML 解析方式时,真正需要权衡的不是“哪个 API 更高级”,而是文档有多大、是否只顺序读取、要不要随机查找节点,以及是否需要修改后重新写回。把这些需求先确定下来,通常就能在树形解析和流式解析之间快速做出选择。
学习目标
- 能根据内存、访问方式和修改需求选择 XML 解析思路
- 理解 DOM、SAX 与 StAX 一类方案的核心差异
- 能避免因为解析模型选错而产生不必要的内存或代码复杂度
先看应用需要怎样访问 XML
常见 XML 解析方式可以先分成两类:一类把文档构造成节点树,另一类按文档出现顺序逐步读取事件。DOM 属于典型树形模型;SAX 和 StAX 都偏向流式处理,但编程方式不同。
选择之前,先回答几个实际问题:文档能否完整放入内存,处理是否只进行一次,代码是否需要随时回到前面的节点,是否要按层级反复查询,以及是否会修改节点后再输出 XML。这些问题比单纯比较 API 名称更有意义。
树形解析适合反复访问和修改
DOM 会把整个 XML 文档表示成内存中的节点树。解析完成后,可以从父节点访问子节点,也可以在不同位置之间跳转,还能配合 XPath 做条件查询。需要增加、删除或修改节点时,树形模型也更直观。
它的代价是必须维护整棵树以及节点对象等额外结构,所以实际内存占用通常明显高于 XML 文件本身。对于几十 KB 或几 MB 的配置文件,这往往不是问题;对于数百 MB 甚至更大的数据文件,就需要谨慎评估。
适合 DOM 的典型任务包括读取并修改配置文件、反复查询多个位置、根据前后节点关系做处理,以及修改完成后重新序列化为 XML。
流式解析适合一次顺序处理
SAX 与 StAX 都不要求先构造完整节点树,而是随着输入推进处理开始元素、文本、结束元素等事件,因此通常能把内存占用控制在较低水平。
两者主要区别在控制方式。SAX 通常由解析器主动推进,并在遇到事件时调用应用提供的回调方法;应用需要把跨多个事件的上下文保存在自己的状态变量中。StAX 更像迭代器,由应用主动请求下一个事件,因此循环、条件判断和提前停止通常更容易组织。
如果业务只是扫描大型订单 XML,遇到一个 order 就处理一个,并且处理完后不再返回这个节点,那么流式解析通常比构造完整 DOM 更合适。相反,如果处理后半部分时还需要频繁回看前半部分,就要自己缓存数据,流式方案的优势可能随之减弱。
用需求而不是文件格式名称做决定
三种常见方案可以这样比较:
| 需求 | DOM | SAX | StAX |
|---|---|---|---|
| 完整节点树 | 支持 | 不构建 | 不构建 |
| 随机访问节点 | 方便 | 不方便 | 不方便 |
| 修改节点结构 | 方便 | 不适合 | 不适合 |
| 大文件低内存处理 | 较弱 | 适合 | 适合 |
| 控制流程 | 应用操作节点树 | 解析器回调应用 | 应用主动拉取事件 |
| XPath 配合 | 常见且自然 | 通常不能直接对完整流任意查询 | 通常不能直接对完整流任意查询 |
这里不存在始终正确的“最快解析器”。性能还会受具体库实现、XML 结构、字符编码以及应用处理逻辑影响。选型时更稳妥的顺序是先判断访问模式,再考虑内存限制,最后才做性能测试。
常见的选错方式
小型配置文件为了节省极少量内存而改用 SAX,往往会增加状态管理和代码复杂度;大型数据文件为了调用方便而无条件构造 DOM,则可能让内存成为瓶颈。另一个常见误区是看到“需要查询”就默认必须使用 XPath:如果查询实际上只是“按顺序找到每个某类元素并处理一次”,流式解析往往已经足够。
解析方案的核心差异来自数据是否常驻内存以及应用怎样访问节点,而不是 XML 内容本身。只要先明确“顺序处理还是随机访问、只读还是修改、文件规模是否受内存约束”,多数 XML 解析选型都可以在实现代码之前确定。