
HTTP 与 Web 标准 / 系统课时
DOM 为什么会构建整棵文档树
DOM 为什么会构建整棵文档树
DOM 解析 XML 时,会先把文档中的元素、属性和文本转换成相互关联的节点,并保存在内存中。理解这棵树为什么存在,能帮助你判断 DOM 何时适合随机查询、修改节点,以及为什么处理超大 XML 时内存压力会明显增加。
学习目标
- 理解 DOM 将 XML 转换为节点树的原因
- 说明整棵树如何支持随机访问与修改
- 判断 DOM 更适合哪些 XML 处理场景
从 XML 文本到节点树
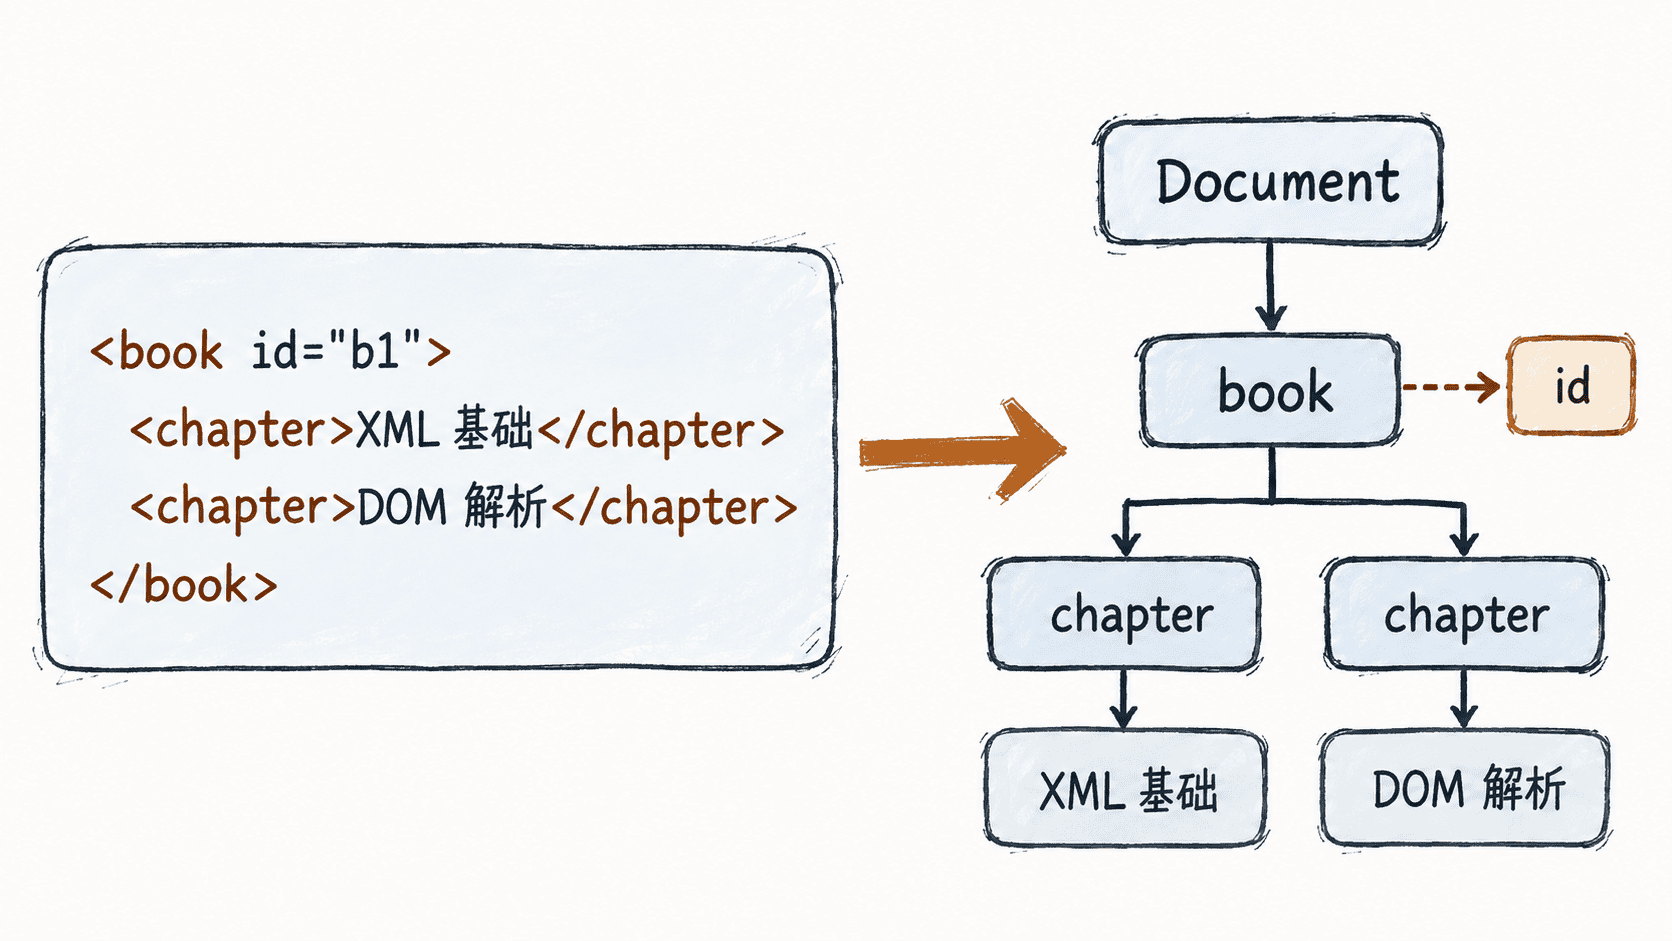
XML 文件本质上是按字符顺序保存的文本,但其中存在明显的父子关系。例如下面的文档中,book 是根元素,两个 chapter 是它的子元素,而标题文字又属于各自元素内部的文本节点。
<book id="b1">
  <chapter>XML 基础</chapter>
  <chapter>DOM 解析</chapter>
</book>
如果程序只保留原始字符,要访问第二个 chapter、查找它的父元素,或把它移动到其他位置,就需要反复扫描并重新解释文本结构。DOM 的做法是先解析整个文档,再建立带有父子、兄弟和属性关系的节点对象。
为什么必须先构建完整结构
DOM 的核心目标不是尽快读完 XML,而是让解析后的文档成为一个可以随时导航和操作的对象模型。程序拿到根节点后,可以向下访问子节点,也可以从节点访问父节点、兄弟节点或属性,而不必重新读取源文件。
这种能力依赖节点之间已经建立好的关系。尤其是随机访问时,程序可能先查询文档末尾的节点,再回到开头修改另一个节点,因此解析器不能只保留当前位置附近的数据。
DOM 通常还允许创建、删除、替换和移动节点。修改发生后,内存中的树代表文档当前状态,程序最后可以再把整棵树序列化为 XML。也就是说,DOM 不只是“读取器”,更像一个可编辑的 XML 文档模型。
整棵树带来的优势
当需求需要多次查询同一份 XML 时,DOM 很方便。例如程序可以先按元素名查找节点,再读取属性,随后回到父节点继续处理,而无需考虑这些内容在原始文件中的先后位置。
修改文档也是 DOM 的强项。假设要为某个 chapter 增加属性、删除旧节点,再把一个节点插入指定位置,树结构可以直接表达这些变化。代码操作的是节点之间的关系,而不是手工拼接 XML 字符串。
因此,配置编辑器、小型 XML 文档转换工具,以及需要反复导航节点的程序,通常都能从 DOM 的随机访问能力中受益。
代价是内存占用
DOM 的便利来自一个明显成本:解析完成后,内存里保存的不只是 XML 原始字符,还包括元素节点、文本节点、属性对象以及节点关系等额外结构。因此,内存占用通常会高于 XML 文件本身的大小。
如果文件只有几十 KB 或几 MB,这种开销通常容易接受;如果文件达到数百 MB,甚至更大,完整构建文档树就可能消耗大量内存,并增加垃圾回收和节点创建成本。
什么时候选择 DOM
当你需要随机访问任意位置、频繁回到已经读取过的节点,或者需要修改 XML 结构时,DOM 的整棵文档树非常有价值。它用更高的内存占用换取了直接、灵活的节点操作能力。
如果任务只是从头到尾读取一次大文件,例如逐条导入几十万条记录,那么保存整棵树往往没有必要。此时更适合使用能够边读取边处理的事件式解析方式,而不是为了顺序读取承担完整 DOM 树的内存成本。