
HTTP 与 Web 标准 / 系统课时
混合内容是什么结构
混合内容是什么结构
有些 XML 元素并不是“只放文本”或“只放子元素”,而是让普通文字与子元素交替出现。这样的结构称为混合内容。它非常适合表达带标记的自然语言,但解析、修改和重新拼接时必须同时维护文本与元素的原始顺序。
学习目标
- 识别 XML 中普通文本与子元素交替出现的混合内容
- 理解混合内容在文档树中的
text、子元素和tail关系 - 避免提取或修改混合内容时破坏空格与文本顺序
文本和元素可以出现在同一层内容中
下面的 p 元素既包含普通文本,又包含用于强调的 em 子元素:
<p>Hello <em>XML</em> world.</p>从阅读结果看,它是一句连续的话:Hello XML world.。但从 XML 结构看,这段内容不是一个完整文本节点,也不是一个简单的子元素列表,而是按顺序排列的“文本、元素、文本”。这就是混合内容的核心特征。
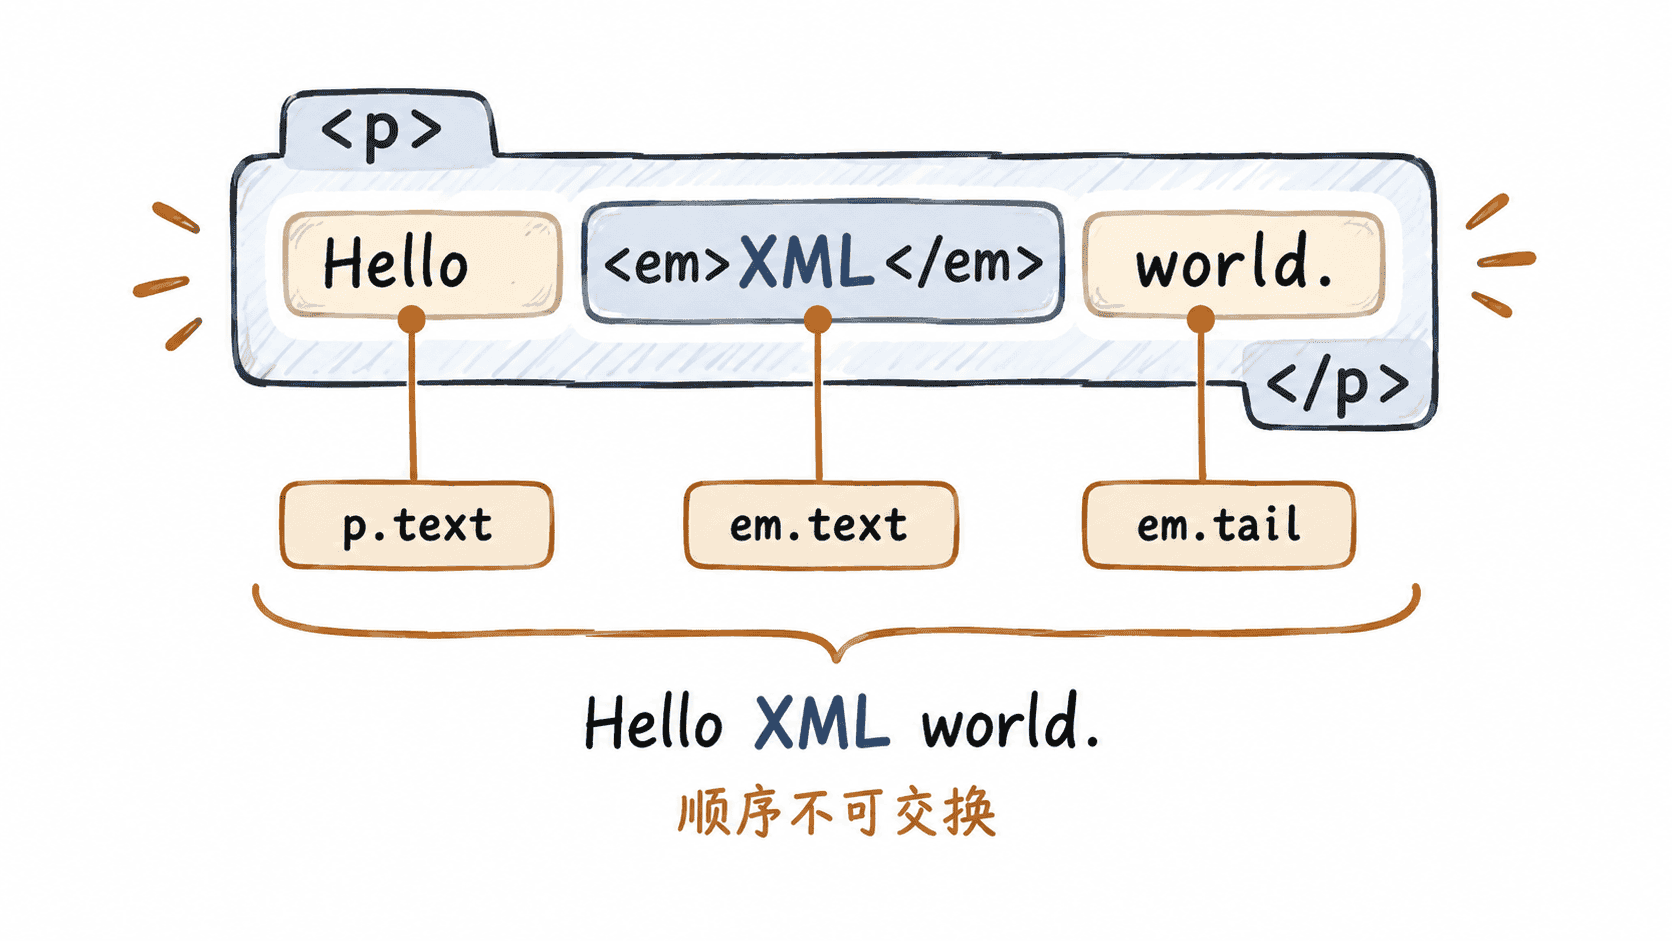
如果只读取父元素的直接文本,或者只遍历子元素,就会漏掉其中一部分内容。因此处理混合内容时,关键不是“有哪些节点”,而是“文本和节点以什么顺序出现”。
解析后文本分布在哪里
在 Python 的 xml.etree.ElementTree 中,父元素开始标签之后、第一个子元素之前的字符保存在父元素的 text 中;子元素自己的文本位于子元素的 text;子元素结束标签之后的字符则位于该子元素的 tail。
from xml.etree import ElementTree as ET

xml = "<p>Hello <em>XML</em> world.</p>"
p = ET.fromstring(xml)
em = p.find("em")

print("p.text =", repr(p.text))
print("em.text =", repr(em.text))
print("em.tail =", repr(em.tail))
print("all text =", "".join(p.itertext()))
预期输出
p.text = 'Hello '
em.text = 'XML'
em.tail = ' world.'
all text = Hello XML world.
这里两个空格都很重要:一个位于 Hello 后,另一个位于 world. 前。如果分别对三个片段调用 strip() 后直接拼接,结果就会变成 HelloXMLworld.,原句的词间边界被破坏。
为什么混合内容更难处理
纯数据 XML 往往拥有规则结构,例如一个 user 元素包含 name、email 等子元素。程序可以按元素名称读取字段,文本通常只出现在叶子元素内部。
混合内容则不同。一个段落可能同时出现多个内联元素:
<p>Use <code>parse()</code> to read <strong>XML</strong> safely.</p>程序若要保持原文,就必须保存 Use 、code 元素、to read、strong 元素以及 safely. 的相对顺序。删除某个子元素时,还要决定它的文本是否保留;移动元素时,也可能连带改变其尾随文本的位置。
因此,对混合内容进行转换时,简单地“读取所有子元素再处理”通常不够。需要使用能够按文档顺序遍历文本和元素的 API,或者在修改后通过序列化结果验证最终内容。
什么时候适合使用混合内容
混合内容最适合文档型 XML,例如技术文档、出版格式、富文本或 XHTML 一类需要在自然语言中嵌入强调、链接、代码和引用的场景。在这些场景中,内联元素本身就是句子结构的一部分。
如果 XML 的主要目标是交换结构化业务数据,则通常应尽量保持元素内容规则、字段边界明确。不是因为混合内容“不合法”,而是因为规则结构更容易进行校验、查询、映射和修改。