
HTTP 与 Web 标准 / 系统课时
程序读取 XML 时发生了什么
程序读取 XML 时发生了什么
程序读取 XML 并不是直接把标签变成对象。解析器需要先取得字节并确定字符编码,再识别开始标签、结束标签、属性和文本,随后才会构建节点树或持续产生解析事件。理解这条链路有助于定位编码和格式错误。
学习目标
- 说清 XML 从字节到元素节点经历的主要阶段
- 区分树模型解析与事件模型解析的结果形态
- 使用程序读取一段 XML,并观察解析后的节点数据
解析器先把字节变成字符
XML 文件最终以字节形式存放。解析器首先需要把这些字节解码成字符,可能参考字节顺序标记、XML 声明中的 encoding,以及 XML 规范规定的编码识别规则。
如果文件实际采用 UTF-8,却声明成另一种不兼容编码,解析可能在这一阶段失败;即使标签结构完全正确,也无法继续识别元素。因此,很多所谓“XML 解析失败”其实首先是字符解码问题。
识别标记并检查格式
得到字符后,解析器会识别 <book>、</book>、属性、文本、注释等 XML 语法结构,同时检查文档是否满足基本的良构规则。
例如,开始标签必须正确闭合,属性值必须加引号,一个文档只能有一个根元素。像 <book><title></book> 这样的交叉闭合会在解析阶段直接报错,程序甚至无法得到完整的节点结构。
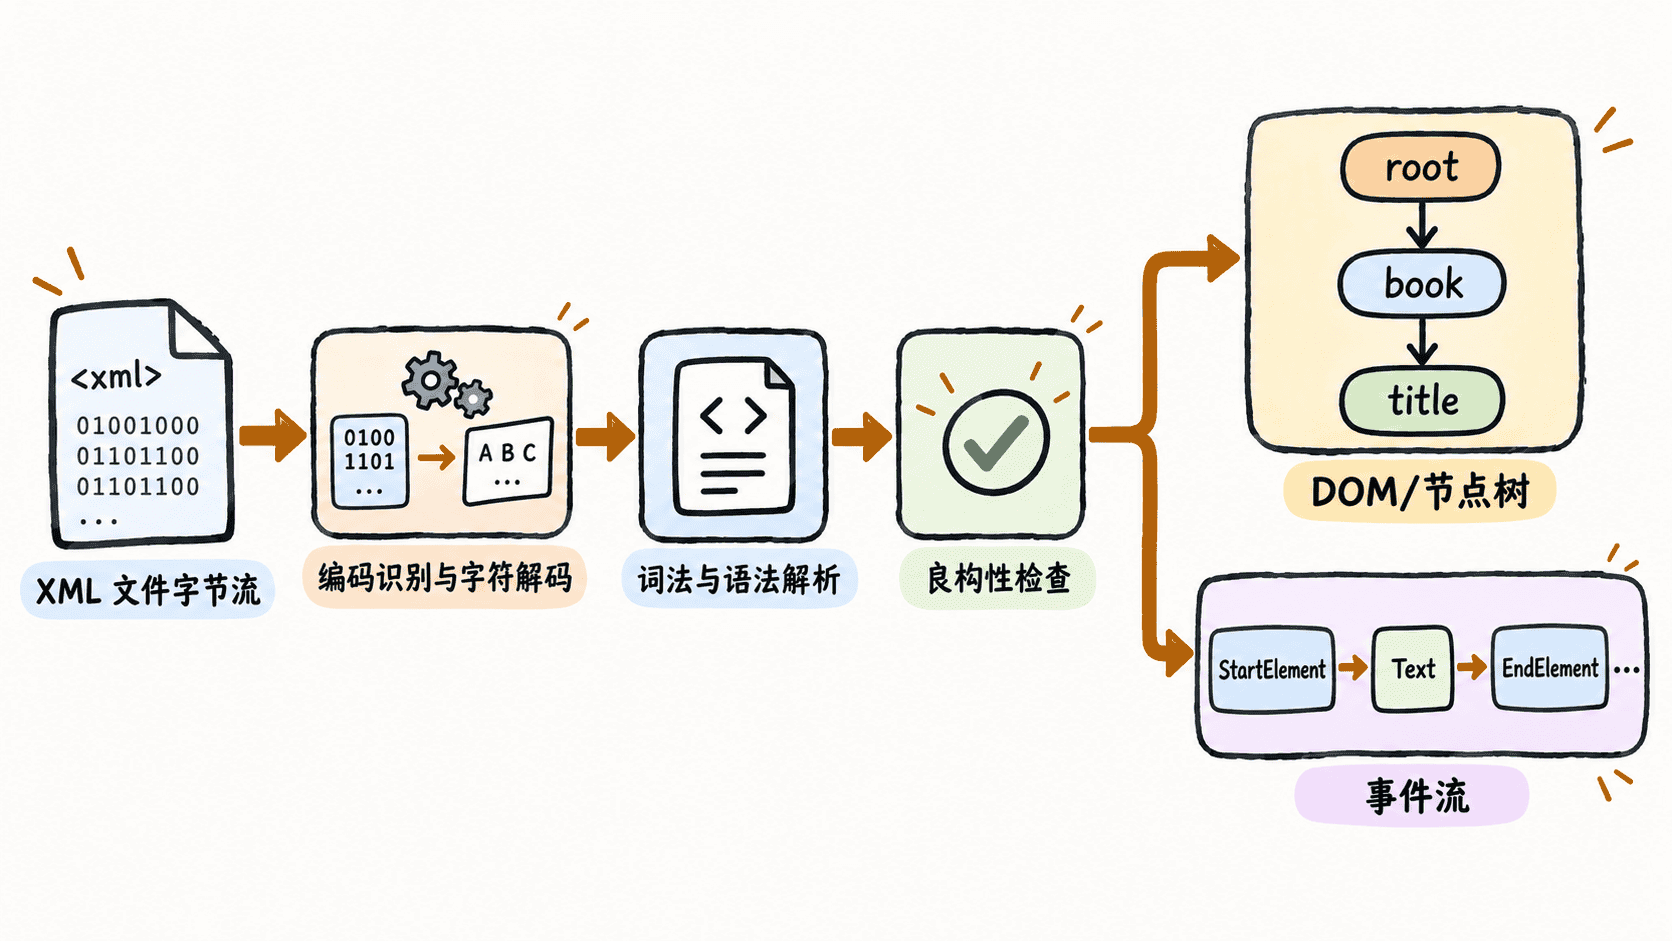
树模型和事件模型会在这里分岔
语法被识别以后,解析器并不一定产生同一种结果。树模型会把文档组织成内存中的节点关系,程序可以从根节点向下查找元素、属性和文本。DOM 以及许多常见 XML 库都提供这种使用方式。
事件模型则不要求一次构建完整树。解析器向前读取时,会依次报告“开始元素”“文本”“结束元素”等事件,程序在事件到达时立即处理。SAX、StAX 或其他流式解析方式都体现了这种思路。
树模型通常更方便随机访问和修改节点,但需要保存较多内存状态;事件或流式模型适合很大的 XML 文件,因为程序可以边读边处理,不必长期保存整份文档。
用代码观察树模型
下面使用 Python 标准库 xml.etree.ElementTree。示例先得到 UTF-8 字节,再交给解析器构建节点树,最后读取根元素、属性和子元素文本。
import xml.etree.ElementTree as ET

xml_text = '<?xml version="1.0" encoding="UTF-8"?><catalog><book id="b1"><title>XML 入门</title></book></catalog>'
xml_bytes = xml_text.encode("utf-8")

root = ET.fromstring(xml_bytes)
book = root.find("book")

print(root.tag)
print(book.get("id"))
print(book.findtext("title"))
预期输出
catalog
b1
XML 入门
ET.fromstring() 在这里完成了解码、语法检查和树节点构建。程序之后操作的 root 已经不是原始 XML 字符串,而是解析后的元素对象。
选择解析方式时看什么
如果 XML 规模较小,并且程序需要反复查找不同节点,构建树通常最直接。配置文件、接口返回的小型 XML 和需要修改后重新写出的文档,都很适合这种方式。
如果文件可能达到数百 MB,或者业务只需要逐条消费其中的记录,就应优先考虑流式或事件式解析。无论最终使用哪种 API,底层思路都相同:先把字节可靠地解释成 XML 语法,再把这些语法结构转换成程序可以处理的节点或事件。