
HTTP 与 Web 标准 / 系统课时
SAX 为什么适合大文件
SAX 为什么适合大文件
SAX 解析 XML 时不会先把整份文档保存成节点树,而是在读取过程中不断产生“元素开始、文本、元素结束”等事件。程序收到事件后立即处理并继续向前,因此内存占用通常与当前处理状态有关,而不是随着整个 XML 文件大小同步增长。
学习目标
- 理解 SAX 的事件式顺序解析机制
- 说明 SAX 处理大文件时内存占用较低的原因
- 判断哪些读取任务适合使用 SAX
SAX 看到的是事件流
假设解析下面的 XML:
<users>
  <user id="101">Alice</user>
  <user id="102">Bob</user>
</users>
DOM 会把它转换成一棵节点树,而 SAX 更像一个按顺序工作的扫描器。解析器从文件开头向后读取,并依次通知应用程序发生了什么,例如开始读取 users、开始读取 user、读取文本 Alice、结束 user。
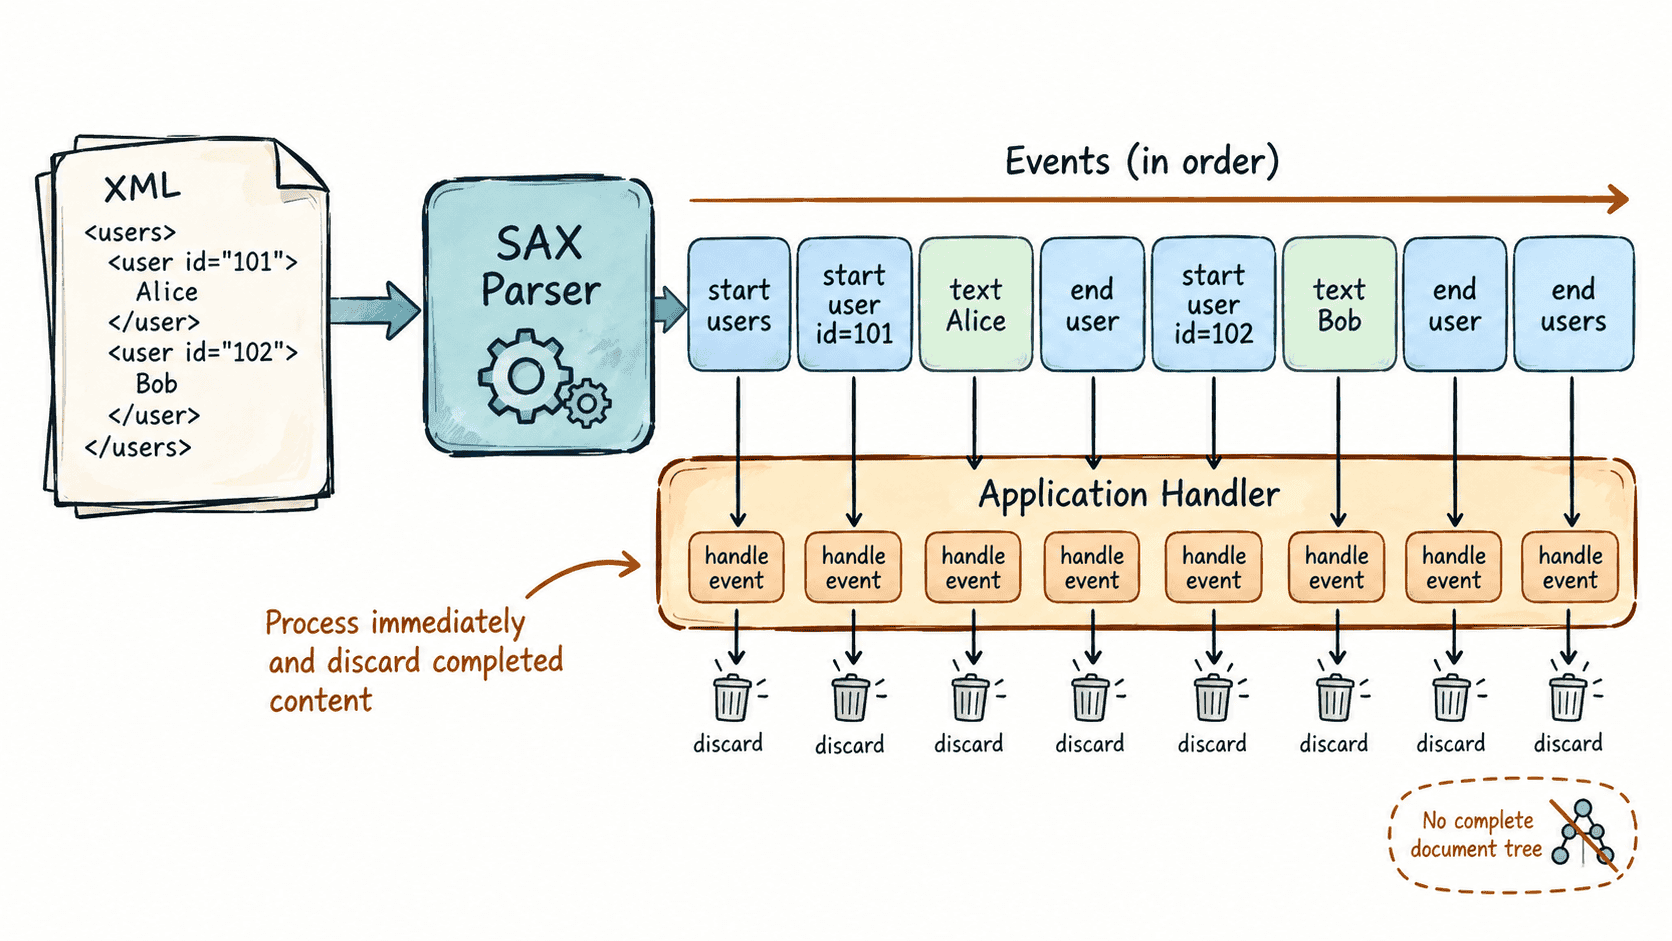
应用程序通常通过回调处理这些事件。解析器负责识别 XML 语法,业务代码则决定遇到某个开始标签、文本或结束标签时要做什么。
为什么不需要保存完整文档
SAX 的关键优势来自“处理完就可以忘记”。例如程序读取完第一个 user 后,如果已经把它写入数据库或完成统计,就没有必要继续在内存中保存这个用户对应的所有 XML 节点。
因此,处理一个 2 GB 的 XML 文件时,程序并不需要准备能够容纳 2 GB 文档树的内存。实际内存仍会受到缓冲区、当前字段值以及业务代码自行保存的数据影响,但解析器本身不要求把完整 XML 长期保存在内存里。
这种方式特别适合记录型 XML:文档包含大量结构相似的条目,每个条目可以独立处理。例如日志导入、数据交换文件、批量订单和大规模目录数据都可能采用这种模式。
顺序读取如何处理一条记录
事件本身往往是碎片化的,因此应用程序通常需要保存少量“当前状态”。读取用户数据时,可以在遇到 user 开始事件后记录其 id,随后积累文本内容,在 user 结束事件到达时形成一条完整记录并立即处理。
这意味着 SAX 并非完全不使用内存,而是只保存当前业务真正需要的数据。只要程序没有主动把所有记录收集到列表中,内存规模通常不会随着已处理记录数量持续增长。
SAX 的代价是访问方式受限
事件流通常只向前推进。一个节点处理完成以后,如果后续逻辑突然需要重新读取前面的兄弟节点,SAX 没有现成的文档树可以直接返回。程序只能提前保存所需信息,或者重新解析输入。
修改 XML 也比 DOM 更麻烦。SAX 更适合把输入转换为其他结果,而不是在任意位置插入、删除和移动节点。如果业务需要反复跳转节点或编辑原文档,事件模型会让状态管理变得复杂。
什么时候选择 SAX
当 XML 很大,而且任务能够按照文档顺序逐条完成时,SAX 往往非常合适。典型模式是读取一条记录、完成校验或转换、立即写入目标系统,然后继续下一条。
如果文件规模较小,同时需要随机查询、回到父节点、重复访问不同位置或直接修改文档结构,DOM 通常更直观。选择 SAX 的关键并不是“它比 DOM 更高级”,而是当前任务是否能接受单向事件流,并真正利用边读边处理带来的低内存特性。