
HTTP 与 Web 标准 / 系统课时
encoding 为什么会导致乱码
encoding 为什么会导致乱码
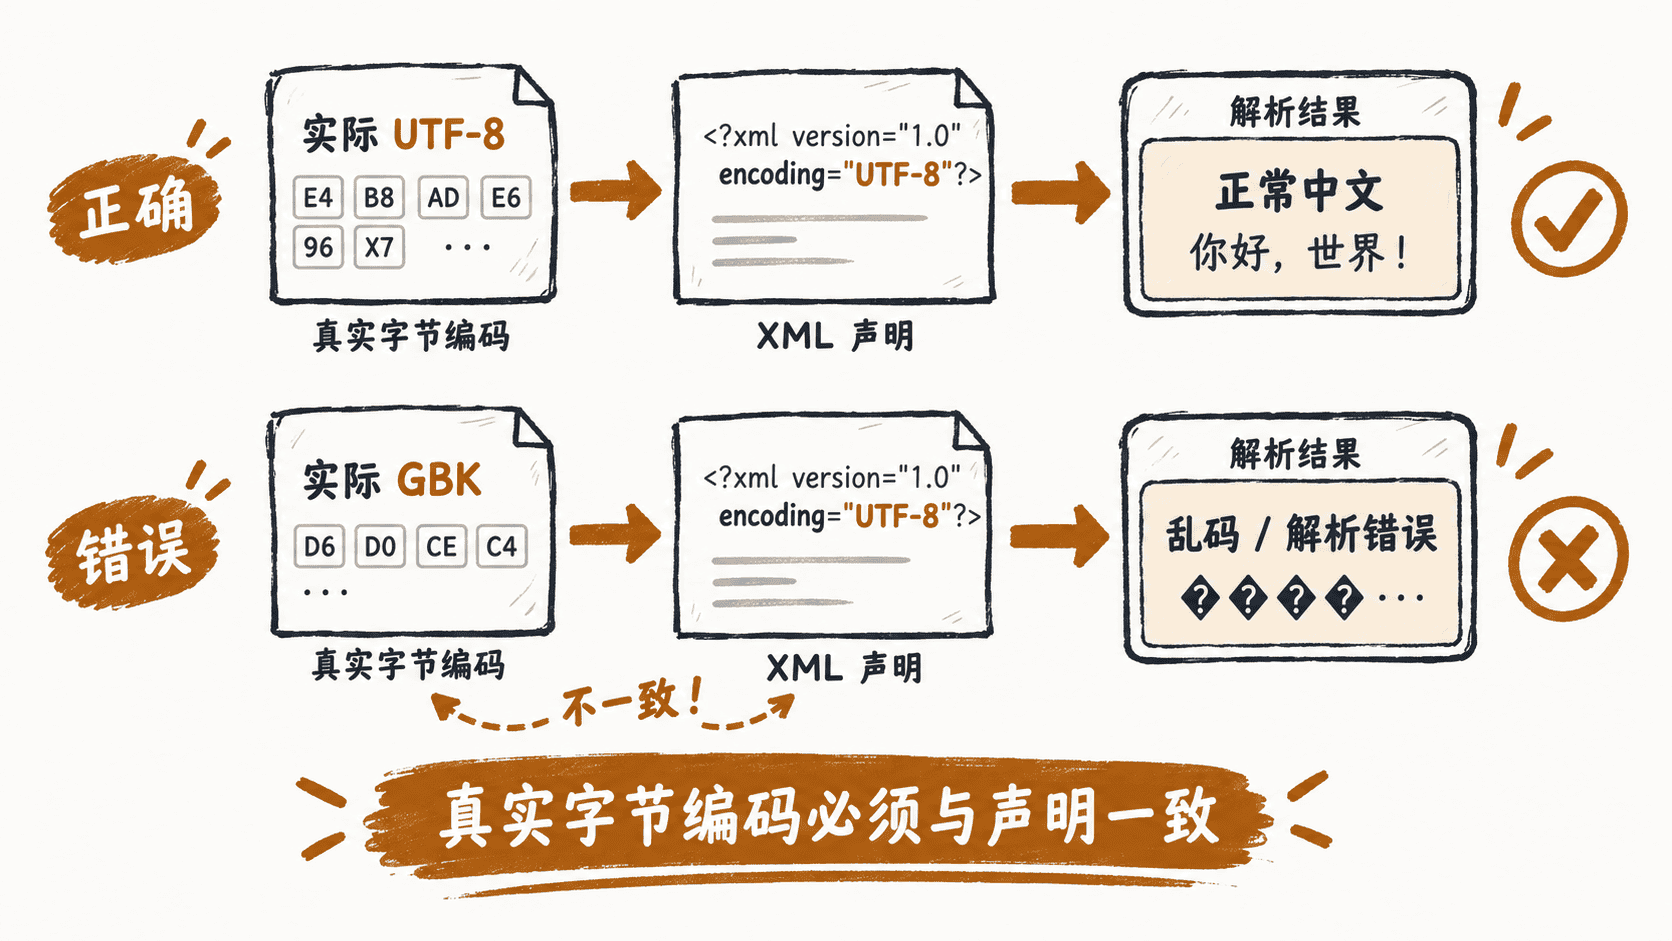
XML 声明中的 encoding 必须和文件实际保存成的字节编码一致。若声明写着 UTF-8,文件却按 GBK 保存,解析器会用错误规则把字节还原为字符,结果可能是乱码,也可能直接报编码错误。最简单可靠的做法是让“声明、保存、传输、读取”统一使用 UTF-8。
学习目标
- 解释 XML 声明编码与文件真实字节编码的关系
- 判断编码不一致为什么会产生乱码或解析失败
- 使用 UTF-8 统一 XML 的保存与读取方式
乱码发生在字节还原成字符时
XML 文件最终存储的是字节。解析器读取文件后,需要依据编码规则把字节重新解释成字符。例如同一个“中”字,在 UTF-8 和 GBK 中对应的字节序列并不相同。
因此,下面这行声明不是装饰信息:
xml
<?xml version="1.0" encoding="UTF-8"?>它等于告诉解析器:“请按 UTF-8 解释接下来的字节。”如果真实文件不是 UTF-8,这个承诺就被破坏了。
用字节实验理解差异
下面的 Python 程序把同一段中文分别编码为 UTF-8 和 GBK,再输出对应的十六进制字节:
python
text = "中文"

utf8_bytes = text.encode("utf-8")
gbk_bytes = text.encode("gbk")

print("UTF-8:", utf8_bytes.hex())
print("GBK:", gbk_bytes.hex())
预期输出:
text
UTF-8: e4b8ade69687
GBK: d6d0cec4
同一字符得到完全不同的字节。如果文件实际包含第一组字节,却被读取方按 GBK 解释,就无法稳定还原为原来的“中文”。
声明和文件编码要同时修改
假设 XML 顶部写的是:
xml
<?xml version="1.0" encoding="UTF-8"?>
<user>
  <name>张三</name>
</user>
此时编辑器或程序也必须真正以 UTF-8 保存文件。只修改声明但不重新保存文件,不能把原来的 GBK 字节“变成”UTF-8。
反过来也一样:文件已经转换为 UTF-8,却仍保留 encoding="GBK",解析器仍可能按 GBK 处理,从而失败。
建立统一的 UTF-8 习惯
处理 XML 时,可以把编码问题按同一条链路检查:文件保存编码、XML 声明、网络传输或接口头、程序读取编码是否一致。只要其中某一环使用了不同编码,就可能出现问题。
对新项目而言,统一使用 UTF-8 通常最省事:XML 声明写 encoding="UTF-8",编辑器保存为 UTF-8,程序读取和输出也沿用 UTF-8。这样可以最大限度减少跨平台和跨语言环境中的编码差异。
按自己的节奏,确认真正理解。