
HTTP 与 Web 标准 / 系统课时
XPath 为什么能直接找节点
XPath 为什么能直接找节点
读取 XML 后,如果还要靠循环逐层检查元素名、属性和值,查询代码很快会变得冗长。XPath 把节点层级、方向和筛选条件写成路径表达式,由 XPath 引擎在 XML 节点树上完成定位,因此特别适合从结构明确的文档中直接取出目标节点。
学习目标
- 理解 XPath 能定位节点的根本原因
- 能读懂常见的层级路径、后代选择和条件筛选
- 知道 XPath 查询成立的前提和适用边界
XPath 查询的是节点树
XML 原文看起来是一串标签,但解析器读取文档后,会把元素、属性和文本等内容表示为具有父子关系的节点。XPath 面向的正是这种结构,而不是在字符串中搜索标签文字。
例如有下面的 XML:
<library>
  <book id="b1">
    <title>XML Basics</title>
    <price>39</price>
  </book>
  <book id="b2">
    <title>XPath Guide</title>
    <price>68</price>
  </book>
</library>
这段 XML 可以理解为 library 根元素下面有两个 book 子元素,每个 book 又拥有 title、price 子元素和 id 属性。XPath 只需描述从哪个节点出发、沿什么关系前进以及满足什么条件,不必手工编写逐层遍历逻辑。
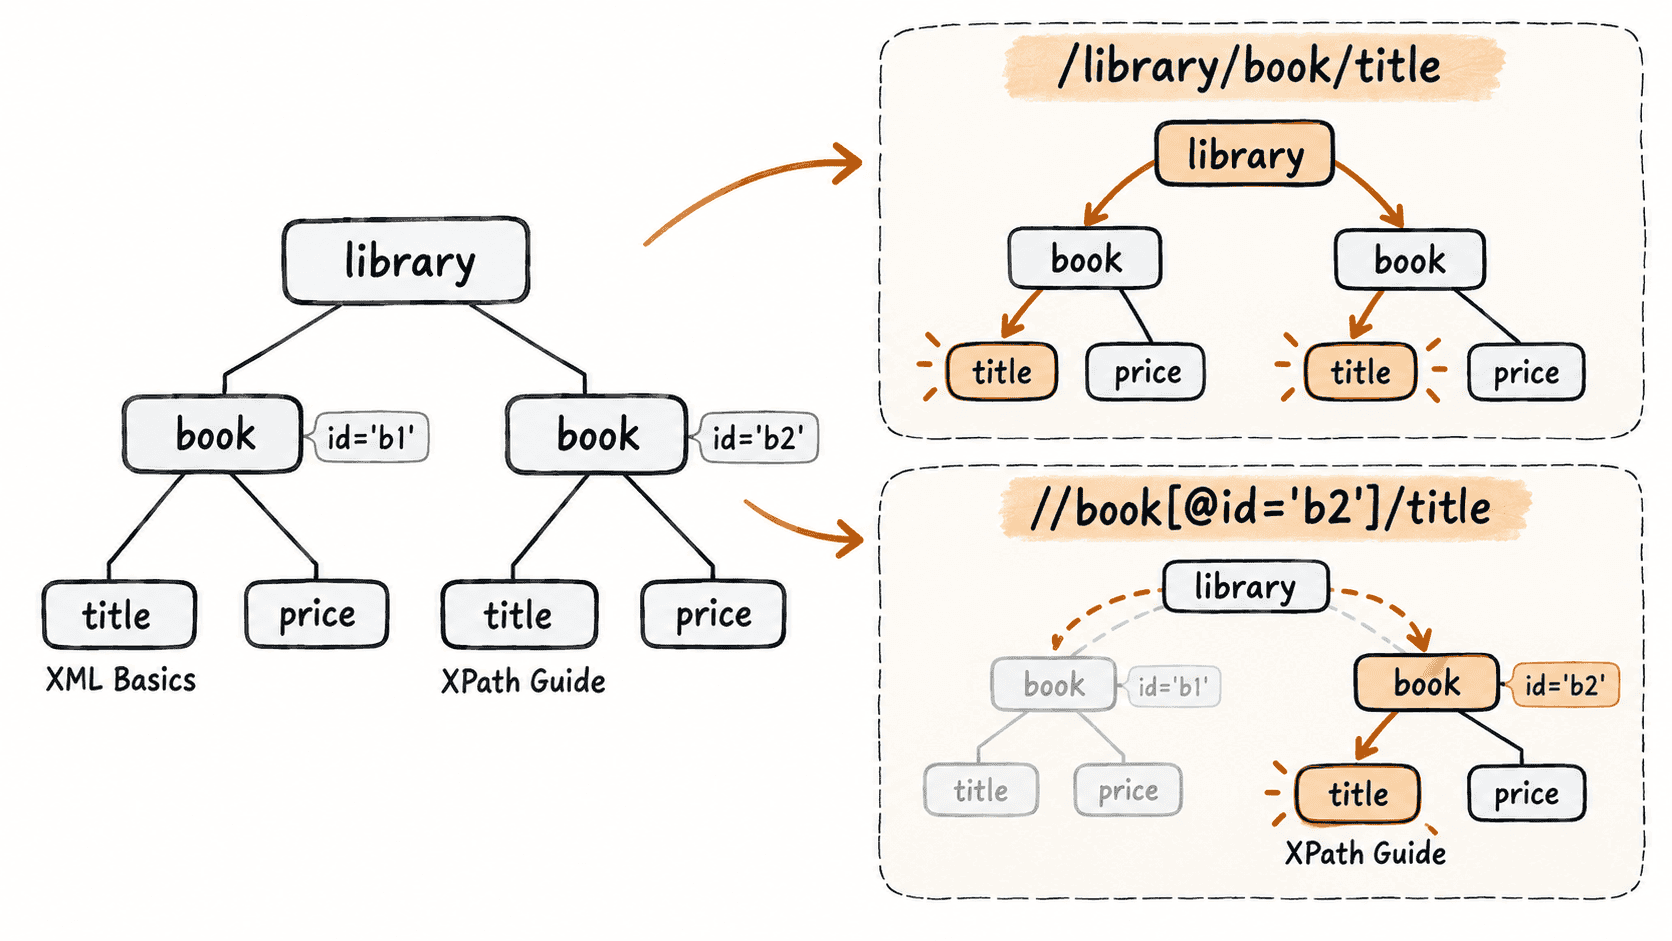
路径描述了怎样到达节点
最直观的 XPath 是绝对路径。下面的表达式从文档根开始,依次经过 library、book,最后选择 title:
/library/book/title对前面的 XML,它会选中两个 title 元素。这里的 / 表示沿直接父子层级继续查找,因此路径结构与 XML 的层级结构直接对应。
如果只关心某种节点,而不确定它位于文档的哪一层,可以使用 // 搜索当前范围内的后代节点:
//price它会匹配文档中的两个 price 元素。// 虽然写起来方便,但搜索范围通常比明确的层级路径更大,因此结构固定时优先写清楚路径更容易理解和维护。
谓词把查找范围继续缩小
XPath 的方括号用于写谓词,也就是给候选节点增加条件。例如,只选择 id 属性等于 b2 的书:
/library/book[@id='b2']其中 @id 表示属性节点。如果还要取得这本书的标题,可以继续沿子节点前进:
/library/book[@id='b2']/title对于示例 XML,最终命中的是文本内容为 XPath Guide 的 title 元素。条件也可以基于子元素,例如选择价格大于 50 的书:
/library/book[price > 50]XPath 因此并不是简单的“按标签名搜索”,而是把层级关系、节点类型和条件组合在一个查询表达式中。
直接查找不等于跳过解析
XPath 能让调用者直接写查询表达式,但 XML 仍然需要先被解析,并由具体库提供 XPath 求值能力。常见 DOM API 会先在内存中建立完整节点树,再执行 XPath;某些库也可能用自己的内部模型完成相同工作。
如果任务只是按顺序读取超大 XML,并且每个元素只处理一次,那么逐事件的流式解析通常更节省内存;如果需要反复按层级、属性或条件随机查询节点,XPath 与树形解析模型会更自然。理解这一点后,看到 /、//、@ 和 [] 时,就能把它们还原成对节点树的导航与筛选,而不是把 XPath 当成神秘的字符串语法。