
HTTP 与 Web 标准 / 系统课时
缩进空格为什么可能成为文本
缩进空格为什么可能成为文本
为了让 XML 更易读,我们通常会在元素之间换行并缩进。但解析器看到的并不一定只是“排版”:这些换行和空格本身也是字符数据,可能进入文档树。理解它们落在什么位置,可以避免遍历节点、提取文本或比较文档时得到意外结果。
学习目标
- 理解元素之间的换行和缩进为什么可能成为文本内容
- 观察解析后元素的
text与tail中如何保存空白 - 区分用于排版的空白与真正有业务含义的文本
缩进并不会自动消失
下面的 XML 看起来只是把两个 item 元素排版得更清楚:
<root>
  <item>A</item>
  <item>B</item>
</root>从字符角度看,<root> 后实际存在一个换行和两个空格,第一个 </item> 后也存在换行和两个空格,第二个 </item> 后还有一个换行。这些字符位于元素内容中,因此解析器可以把它们保留下来。
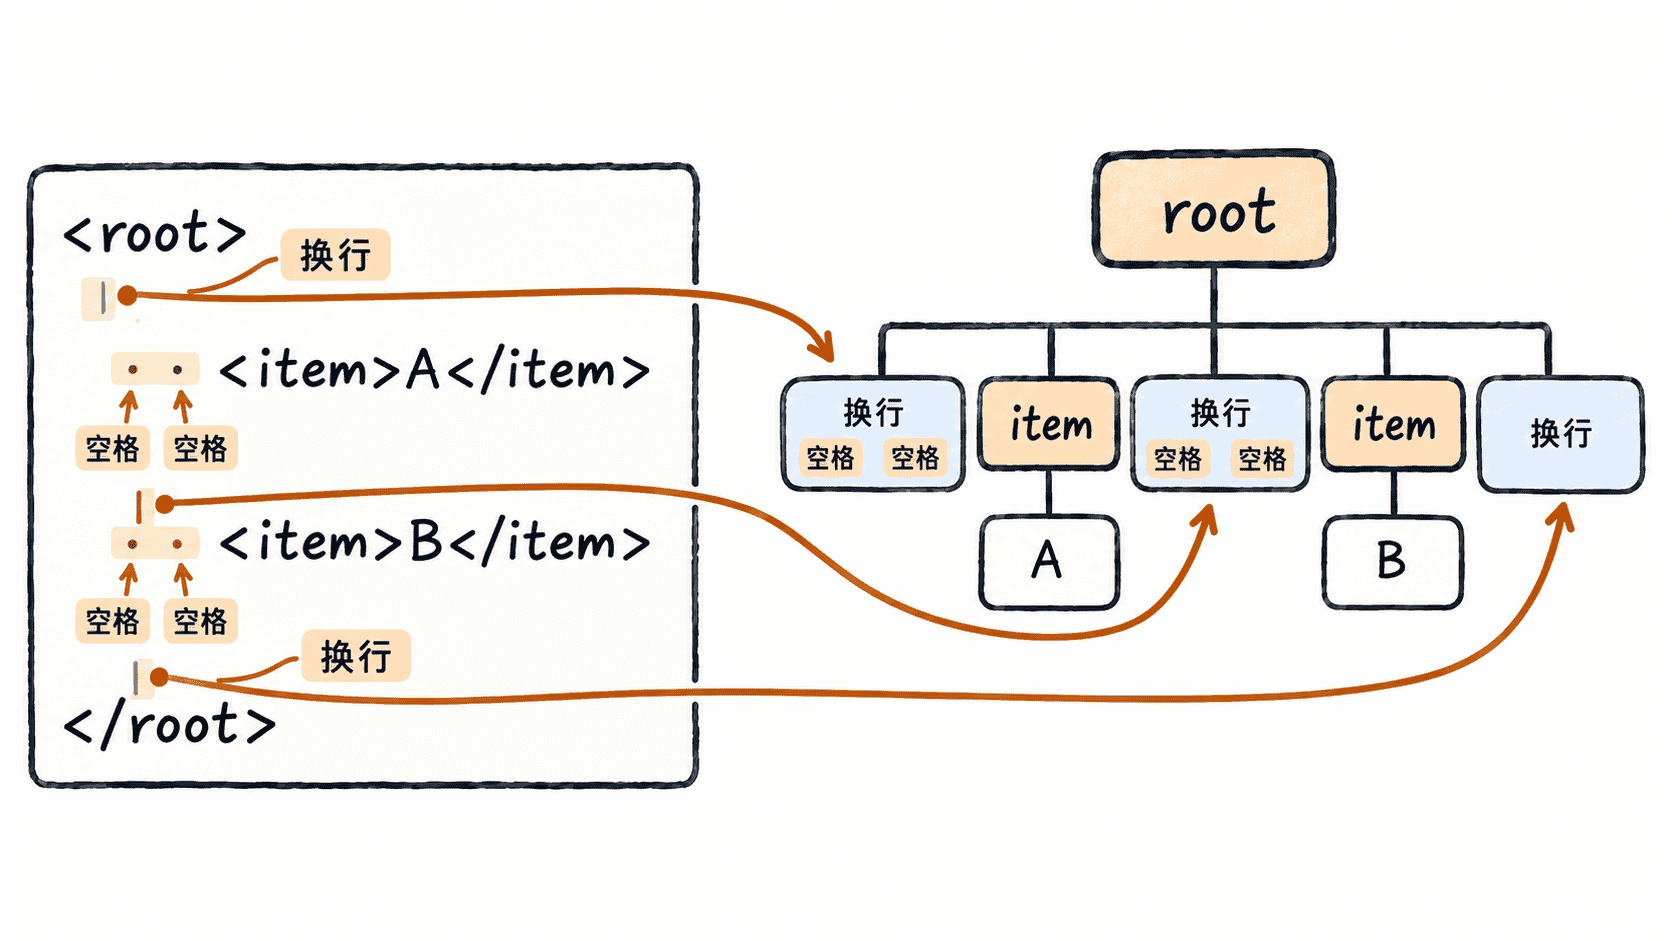
这里最容易产生误解的一点是:XML 规范并没有规定“为了好看而输入的空格一律删除”。空白是否有业务意义,要由文档所采用的数据模型以及应用程序的处理规则决定。
在解析结果中观察空白
Python 标准库 xml.etree.ElementTree 可以直接看到这些字符被保存在哪里。元素开始标签后的文本放在 text 中,子元素结束标签之后、下一个兄弟元素之前的文本放在该子元素的 tail 中。
from xml.etree import ElementTree as ET

xml = """<root>
  <item>A</item>
  <item>B</item>
</root>"""

root = ET.fromstring(xml)

print("root.text =", repr(root.text))
for index, child in enumerate(root):
    print(f"item[{index}].text =", repr(child.text))
    print(f"item[{index}].tail =", repr(child.tail))
预期输出
root.text = '\n  '
item[0].text = 'A'
item[0].tail = '\n  '
item[1].text = 'B'
item[1].tail = '\n'
repr() 把换行显示为 \n,因此可以清楚地区分不可见的空白与普通文本。第一个 item 的内容仍然只是 A,但它后面的缩进并不属于 item.text,而是保存在 item.tail 中。
为什么不同处理方式会得到不同结果
不同 XML API 对文档树的表示方式并不完全相同。DOM 风格的接口可能把元素之间的空白暴露成独立文本节点;ElementTree 则使用 text 和 tail 表示同一类字符数据。应用代码还可能主动调用 strip()、过滤空白节点或执行模式相关的处理,因此最终看到的结果会不同。
这意味着不能仅凭“肉眼看起来只是缩进”就假设空白一定不存在。如果程序按节点逐个遍历,空白文本可能影响节点数量;如果直接拼接文本,空白又可能改变最终字符串。
判断空白是否应该保留
处理 XML 时可以先问一个问题:这些字符删除后,业务含义是否改变?对于只包含结构化字段的配置或数据交换文档,父元素中仅由换行和缩进组成的文本通常没有实际意义,应用可以在明确规则下忽略它们。
如果元素承载自然语言,例如 <p>Hello <em>XML</em> world.</p>,Hello、XML 与 world. 之间的空格会直接影响阅读结果,就不能把所有空白一概删除。稳妥的做法是根据 XML 格式的语义制定规则,而不是根据文档是否“排版漂亮”来判断。