
Redis 与缓存 / 系统课时
处理阻塞读取
处理阻塞读取
本课解决 Redis Streams 消费者在没有新消息时如何等待、一次取多少条,以及这些参数怎样影响延迟、处理成本和吞吐。最终你能用 BLOCK 与 COUNT 设计可控的批量拉取策略。
学习目标
- 理解
BLOCK、COUNT在XREADGROUP中的职责 - 能根据处理能力选择等待时间和批量大小
- 能验证阻塞、批量返回以及无消息超时行为
理解 BLOCK 与 COUNT
BLOCK 控制没有可读取消息时最多等待多久,单位是毫秒。设为 0 表示持续阻塞,直到有可读消息;设置有限值则允许消费者周期性返回,便于健康检查、优雅退出或重新计算拉取策略。
COUNT 控制一次请求最多返回多少条消息。它不是“必须返回这么多条”,当可读数据不足时,Redis 会提前返回。批量越大,单条消息的请求开销通常越低,但单批处理耗时和单次失败影响也会增加。
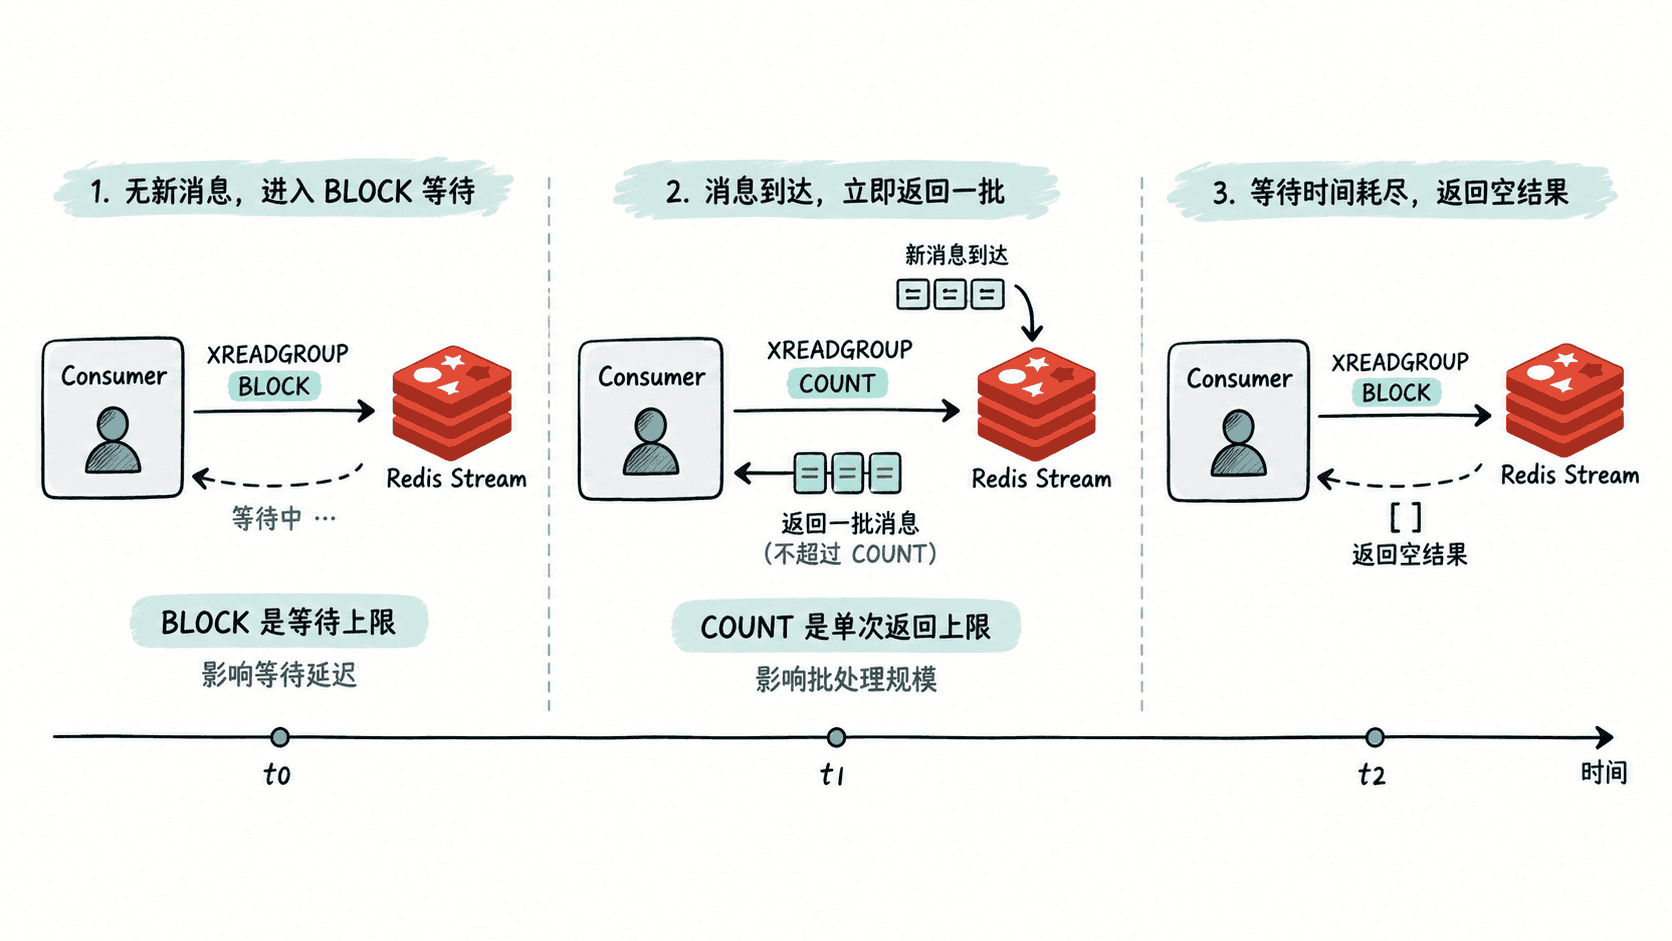
设计一次拉取
下面示例使用消费者组 orders-group 的消费者 worker-1,等待最多 5 秒,每次最多读取 10 条。> 表示只读取当前尚未分配给其他消费者的新消息。
redis-cli XREADGROUP GROUP orders-group worker-1 COUNT 10 BLOCK 5000 STREAMS orders >预期结果
1) 1) "orders"
   2) 1) 1) "<ID-1>"
         2) 1) "order_id"
            2) "1001"
      2) 1) "<ID-2>"
         2) 1) "order_id"
            2) "1002"
实际返回条数可能少于 10;如果 5 秒内没有可读消息,命令会返回空结果。消息 ID、返回顺序和等待结束时间会随运行状态变化,因此输出中的占位值不是固定文本。
平衡等待时间与吞吐
等待时间太短时,消费者会频繁发起空请求,增加网络和 Redis 调用次数;等待时间太长又会让退出、故障检测和某些定时任务变得迟钝。常见做法是让 BLOCK 覆盖正常空闲期,同时让应用本身保留独立的退出信号或超时控制。
COUNT 更适合按处理耗时倒推。假设单条消息平均处理耗时约为 ,一次取 100 条可能带来约 的串行处理窗口;这并不意味着实际耗时一定达到该值,因为真实处理可能并行、短路或受外部依赖影响。批量参数应以实测处理时间、内存占用和下游承载能力共同决定。
验证参数是否合适
可以连续观察每批返回条数和单批处理耗时。若经常返回空结果,先检查消息到达节奏与 BLOCK 是否过短;若每批处理时间持续过长,则优先减小 COUNT,再评估是否需要增加消费者并发。
一个实用原则是:先保证单批处理可以稳定完成,再逐步增大 COUNT;先避免无意义轮询,再根据退出和故障检测要求调整 BLOCK。这样调参时才能明确知道是在优化等待成本,还是在优化批处理效率。