
Redis 与缓存 / 系统课时
设计事件处理链路
设计事件处理链路
本课把一个业务事件从写入 Redis Stream 到消费、扩容、确认与补偿串成完整链路,并修正消费组起点、业务幂等和 Pending 接管的关键边界。完成后,你能把“能消费”提升为“可扩容、可恢复、可运维”的事件处理方案。
学习目标
- 能判断业务事件是否适合放入 Redis Streams,并识别主要边界
- 能设计生产、消费、确认、扩容与补偿的完整链路
- 能处理消费组并行与业务顺序、幂等之间的关系
先判断 Streams 是否适合
Redis Streams 适合“事件按追加日志写入、消费者允许短暂离线、处理进度需要被记录、失败消息需要重新接管”的场景,例如订单创建、支付状态变更、库存变更和用户行为事件。不同业务职责还可以使用不同消费组,各自维护独立进度。
如果业务要求跨集群超大规模吞吐、长期归档与大范围历史回放,或依赖复杂分区和跨地域复制语义,应优先评估专门的消息系统。若只是进程内即时回调,也没有必要为了消息化而额外引入 Streams。
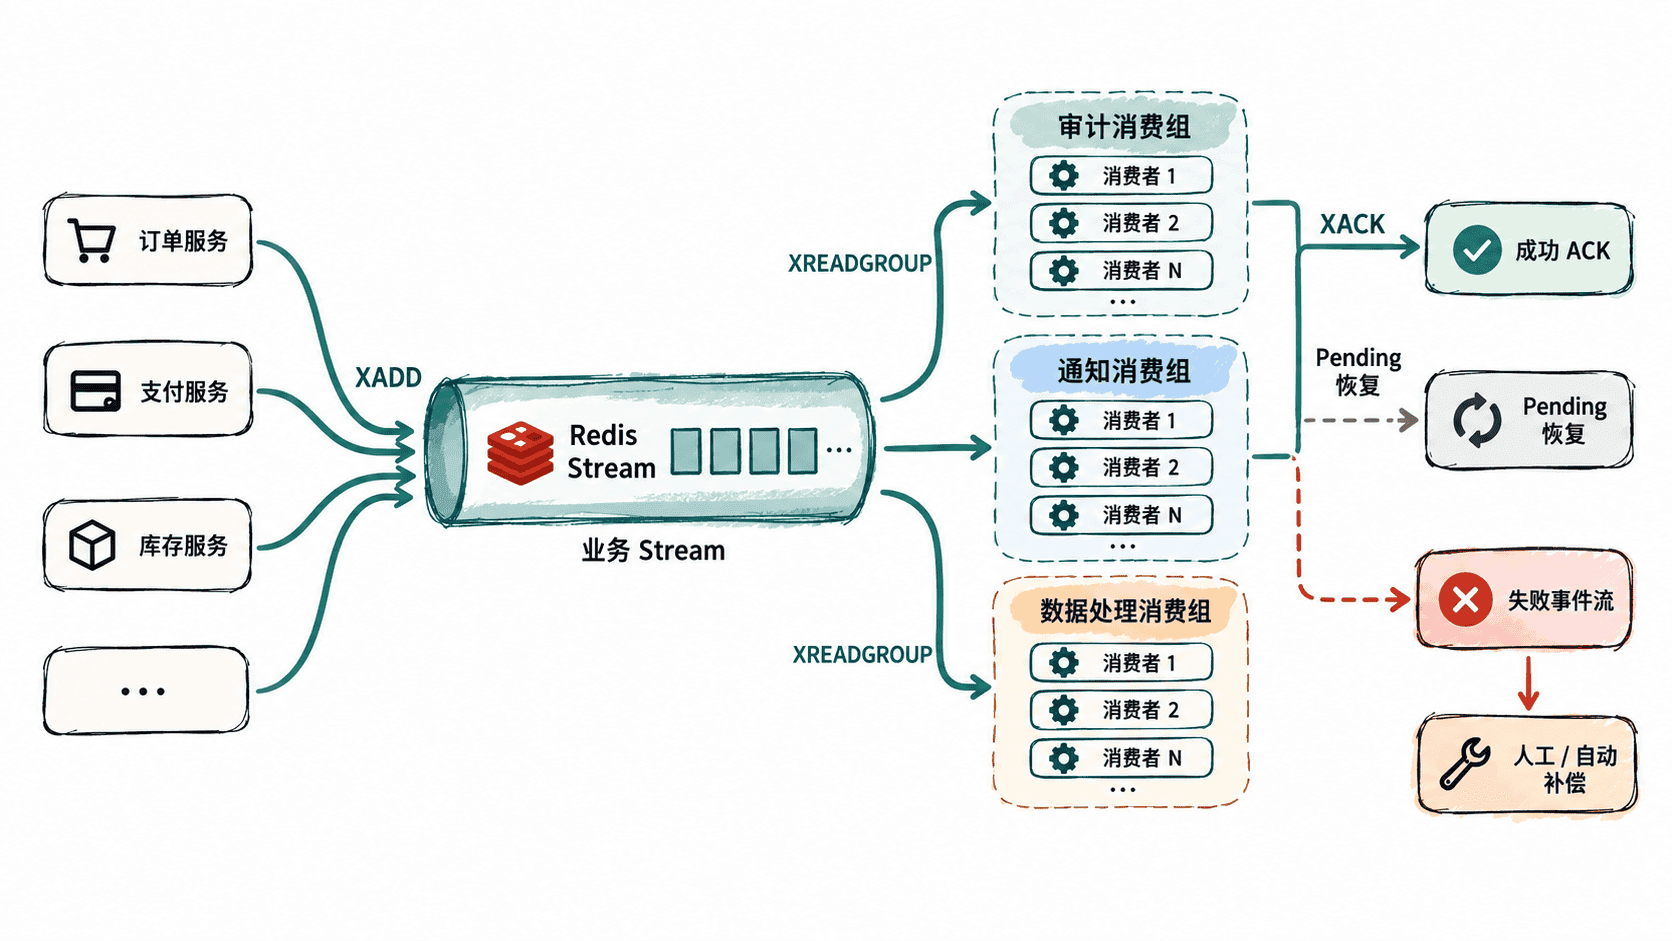
把生产、分发与确认连成主链路
生产者只负责写完整事件,不等待下游消费者处理完成。事件中应至少包含稳定的业务事件 ID、事件类型、业务主体 ID、发生时间和版本号;Redis 条目 ID 用于 Stream 定位,业务幂等则应依赖 event_id 这类稳定标识。
下面用一个空白测试 Stream 串起写入、建组、读取、Pending 查看、接管与确认。因为事件先写入再建组,所以消费组从 0-0 开始;若生产环境只想处理建组后的新事件,可把起点改为 $。示例中的 XCLAIM 把最小空闲时间设为 0,只是为了立即演示接管,生产环境应使用大于正常最长处理时长的阈值。
redis-cli -p "<PORT>" XADD order-events-demo "*" event_id evt-2001 event_type order.created order_id order-9001 occurred_at "<TIME>" version 1
redis-cli -p "<PORT>" XGROUP CREATE order-events-demo notify 0-0
redis-cli -p "<PORT>" XREADGROUP GROUP notify consumer-a COUNT 1 BLOCK 1000 STREAMS order-events-demo ">"
redis-cli -p "<PORT>" XPENDING order-events-demo notify
redis-cli -p "<PORT>" XCLAIM order-events-demo notify consumer-b 0 "<ID>"
redis-cli -p "<PORT>" XACK order-events-demo notify "<ID>"
redis-cli -p "<PORT>" XPENDING order-events-demo notify
其中 <ID> 替换为 XREADGROUP 返回的条目 ID;<PORT>、<TIME>、空闲毫秒数和实际条目 ID会因环境而不同。
预期结果
XADD:返回 <entry-id>
XGROUP CREATE:返回 OK
XREADGROUP:返回 order-events-demo 中 <entry-id> 的完整字段
第一次 XPENDING:pending 数量为 1,该条目由 consumer-a 持有
XCLAIM:返回同一 <entry-id> 的字段,条目转由 consumer-b 持有
XACK:返回 (integer) 1
最后一次 XPENDING:pending 数量为 0
不同 Redis 与 redis-cli 版本对嵌套数组的显示格式可能不同,但关键状态应一致:读取后未确认的条目进入 Pending Entries List,被接管后所有者改变,确认成功后 Pending 数量归零。
用消费组划分职责并扩容
同一事件需要通知、审计、分析等多个系统都处理时,应为每个独立职责创建不同消费组,例如 notify、audit、analytics。一个组内的消息会在消费者之间分配,所以“多个职责共享一个组”会造成某个职责处理并确认后,其他职责拿不到该消息。
吞吐不足时,优先增加同一消费组内的消费者实例,并观察入口速率、处理耗时和 Pending 是否改善。若扩容后吞吐仍不提升,瓶颈通常在数据库、外部 API、锁竞争或业务逻辑;继续增加消费者只会放大下游压力。
为 Pending 和业务失败设计补偿
补偿要区分两类失败。第一类是“消息已经投递,但消费者失联”,这时先用 XPENDING 查看消息的持有者和空闲时间,只有超过任务允许的最长处理时长后,才用 XAUTOCLAIM 或 XCLAIM 把消息交给健康消费者,避免把仍在执行的任务误判为失败。
第二类是“消费者仍健康,但业务处理持续失败”。短暂故障可以有限重试;确定性错误或超过重试阈值的事件应写入独立失败 Stream,并记录原始 event_id、失败原因、重试次数和原条目 ID。修复根因后再补投,由消费者根据业务幂等状态决定是否执行副作用。
明确顺序与适用边界
Streams 保证单个 Stream 中条目按 ID 有序,但消费组允许多个消费者并行,业务完成顺序仍可能变化。对“同一订单必须顺序执行、不同订单可以并行”的需求,应把顺序约束落实到业务键、版本号或状态转换条件,而不是把消费组理解成全局串行队列。
一条可运维的事件链路最终要能回答四个问题:事件从哪里进入,哪个消费组承担哪种职责,消费者失联或业务失败后消息在哪里,以及重复投递时业务如何证明副作用只发生一次。四个答案都明确,生产、扩容、确认与补偿才真正形成闭环。