
Redis 与缓存 / 系统课时
理解至少一次处理
理解至少一次处理
本课解决“业务已经成功,为什么同一条消息还会再次执行”的问题。Redis Streams 将投递与确认分开记录;应用再通过重读或认领恢复未确认消息,因此业务成功与 XACK 成功之间的故障窗口会让同一消息再次进入处理流程。
学习目标
- 理解消费组形成常见至少一次处理语义的前提
- 能还原“业务成功但确认失败”导致重复执行的故障路径
- 能判断哪些业务副作用必须具备幂等能力
至少一次到底保证什么
消费者用 XREADGROUP 读取新消息后,该消息会进入消费组的 Pending Entries List(PEL),直到 XACK 成功才从 PEL 中移除。XACK 只确认消费组中的 pending 状态,并不会删除 Stream 里的消息条目。
在应用持续恢复未确认消息、并且总是在业务处理完成后再确认的前提下,这种机制通常形成“未确认就继续重试”的至少一次处理语义。它并不意味着 Redis 会自动重新执行你的业务代码,也不等于 Redis 与外部数据库、支付系统之间存在跨系统原子事务。
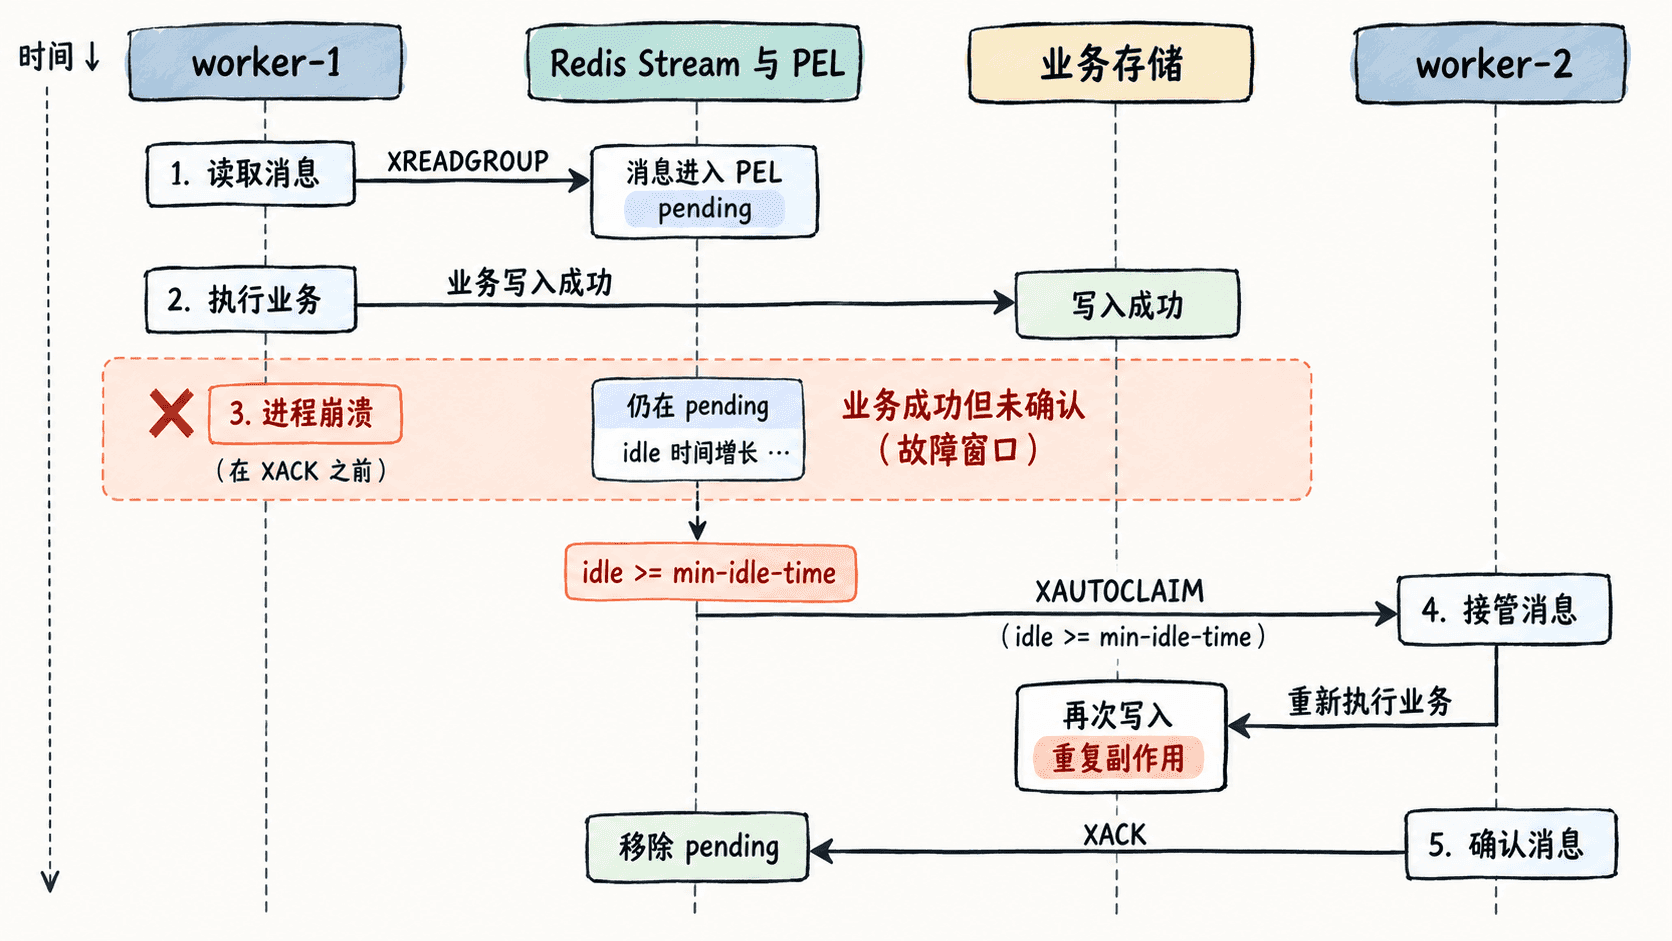
这里有两个彼此独立的成功状态:业务副作用成功与消息确认成功。如果数据库写入、扣款等动作已经完成,而进程在 XACK 前崩溃,恢复逻辑仍会把该消息视为未完成任务。
还原重复处理窗口
下面把非幂等业务动作简化为计数器。worker-1 先读取消息并执行一次 INCR,但故意不确认;等待消息 idle 时间超过 1000 ms 后,worker-2 使用 XAUTOCLAIM 接管同一条 pending 消息,再执行一次业务动作,最后才确认。
set -euo pipefail

redis-cli DEL orders charge-count:9001 >/dev/null
redis-cli XGROUP CREATE orders order-workers '$' MKSTREAM >/dev/null

MESSAGE_ID=$(redis-cli --raw XADD orders '*' order_id 9001 action charge amount 100)
echo "message-id=$MESSAGE_ID"

# 第一次投递给 worker-1,业务成功后故意不执行 XACK。
redis-cli --raw XREADGROUP GROUP order-workers worker-1 COUNT 1 STREAMS orders '>' >/dev/null
FIRST_COUNT=$(redis-cli --raw INCR charge-count:9001)
OWNER_BEFORE=$(redis-cli --raw XPENDING orders order-workers "$MESSAGE_ID" "$MESSAGE_ID" 1 | sed -n '2p')
echo "after-first-business=$FIRST_COUNT"
echo "owner-before-claim=$OWNER_BEFORE"

# min-idle-time 为 1000 ms,因此先等待超过阈值再认领。
sleep 2
CLAIMED=$(redis-cli --raw XAUTOCLAIM orders order-workers worker-2 1000 0-0 COUNT 10)
echo "$CLAIMED" | grep -F "$MESSAGE_ID" >/dev/null

OWNER_AFTER=$(redis-cli --raw XPENDING orders order-workers "$MESSAGE_ID" "$MESSAGE_ID" 1 | sed -n '2p')
SECOND_COUNT=$(redis-cli --raw INCR charge-count:9001)
ACKED=$(redis-cli --raw XACK orders order-workers "$MESSAGE_ID")
FINAL_COUNT=$(redis-cli --raw GET charge-count:9001)
PENDING_COUNT=$(redis-cli --raw XPENDING orders order-workers | head -n 1)

echo "owner-after-claim=$OWNER_AFTER"
echo "after-second-business=$SECOND_COUNT"
echo "acked=$ACKED"
echo "final-count=$FINAL_COUNT"
echo "pending-after-ack=$PENDING_COUNT"
预期输出
message-id=<MESSAGE_ID>
after-first-business=1
owner-before-claim=worker-1
owner-after-claim=worker-2
after-second-business=2
acked=1
final-count=2
pending-after-ack=0
<MESSAGE_ID> 会随实际运行变化。第一次 INCR 返回 1,说明业务已经成功一次,但消息仍属于 worker-1 的 pending。等待 2 秒后,1000 ms 的 min-idle-time 条件成立,XAUTOCLAIM 才会把它转给 worker-2。第二次处理后计数变成 2,证明恢复未确认消息时可能产生重复副作用。
为什么交换确认顺序仍有风险
如果先执行业务再 XACK,故障发生在两者之间时可能重复处理;如果反过来先 XACK 再执行业务,故障会变成消息已经确认,但业务实际上没有完成。单纯交换两个调用的顺序,只是在“可能重复”和“可能丢失”之间移动风险。
因此,恢复逻辑的目标不是幻想 Redis 与业务系统天然具备原子提交,而是接受未确认消息可能再次到达,并让重复执行后的最终业务状态仍然正确。
用幂等收敛重复副作用
可靠消费者应围绕业务唯一键设计幂等,例如订单号、支付请求号或事件 ID。处理消息时先判断该业务键是否已经成功;只有第一次合法请求执行副作用并记录完成状态,后续重复消息直接复用已有结果或安全跳过。
对订单 9001 来说,“又收到一次消息”不能等价为“允许再扣一次款”。更稳妥的做法是让业务存储对幂等键建立唯一约束,或使用受约束的状态迁移,使重复请求无法再次产生有效副作用。
排查重复处理时,可以沿着“消息是否进入 PEL → 业务成功后是否遗漏 XACK → pending 是否达到认领阈值 → 是否发生重读或重新认领”这条链路定位。只要业务副作用发生在确认之前,重复执行就是必须设计和验证的正常故障场景。