
Redis 与缓存 / 系统课时
处理高峰流量
处理高峰流量
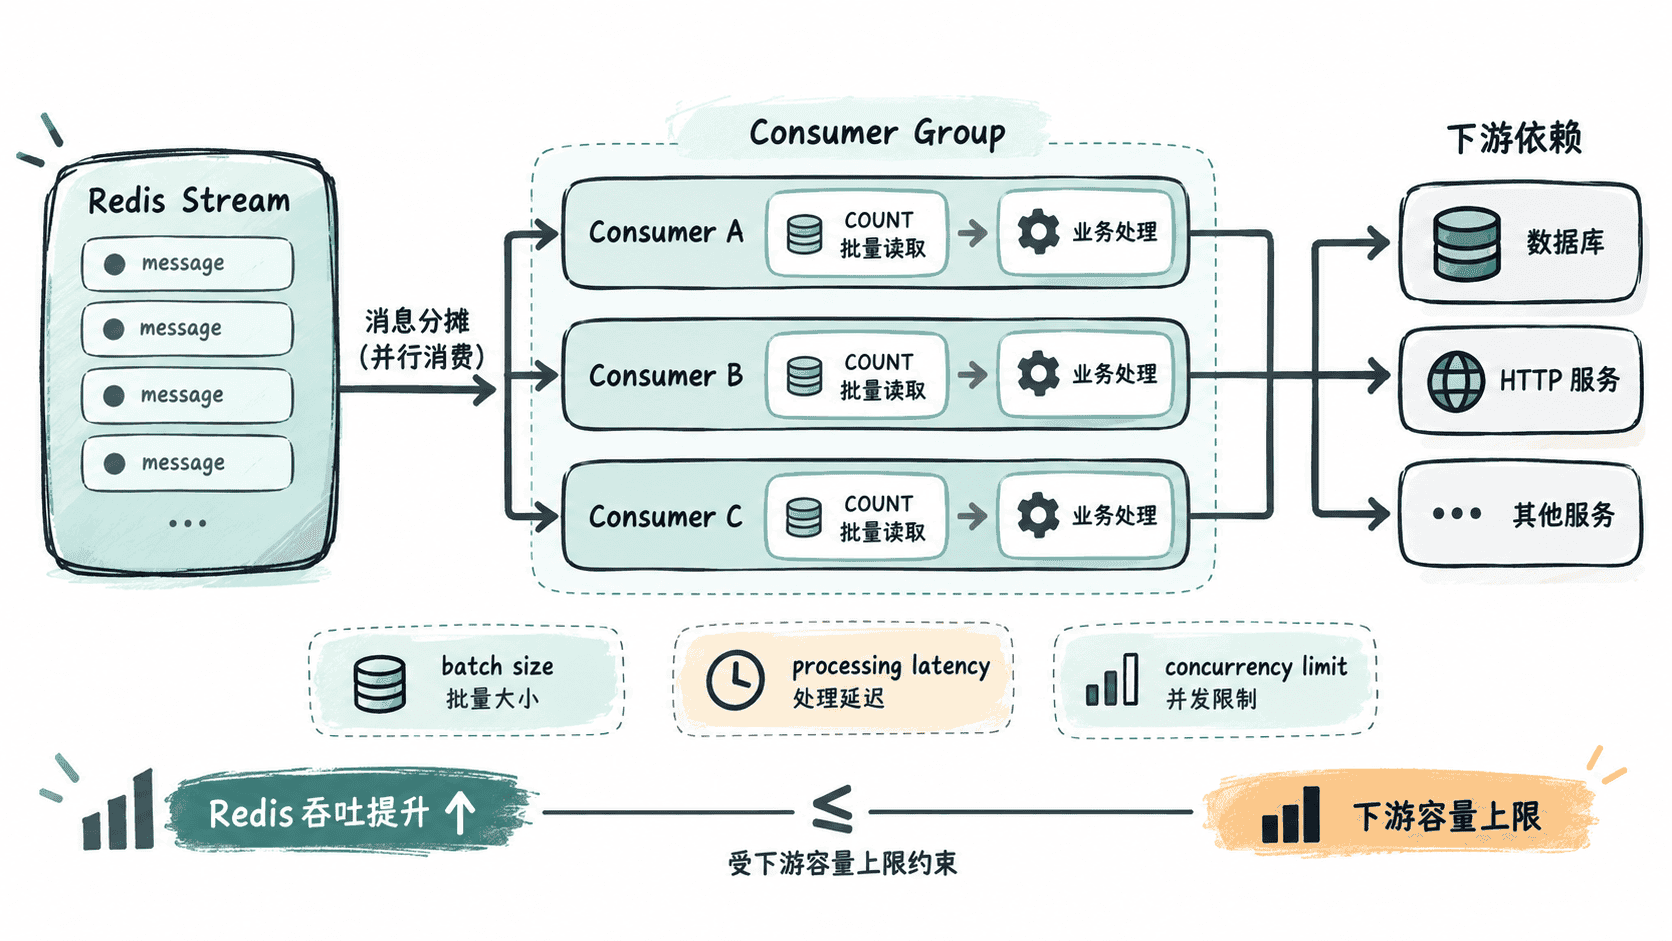
本课解决 Redis Streams 在流量突增时“读得慢、处理堆积、下游被打满”的问题。重点不是无限增加消费者,而是用批量读取、并行消费和明确的在途上限,让消息处理速度与下游可承载能力保持一致。
学习目标
- 能用消费组批量读取降低单条消息的固定开销
- 能区分 Stream 新消息、PEL 与下游依赖三处可能的瓶颈
- 能根据处理耗时和下游容量设置批量大小与并发上限
先确认积压在哪里
高峰期出现积压时,先区分三个位置:Stream 中尚未被消费组领取的新消息、已经交给消费者但尚未确认的 PEL,以及数据库或 HTTP 服务等下游依赖。前两者说明“消息排队在哪里”,下游延迟则决定“还能不能继续提速”。
如果下游已经接近连接池、限流或写入吞吐上限,继续增加消费者只会让更多消息更快进入 PEL,并放大超时、重试和锁竞争。治理目标应是稳定地消化积压,而不是不惜代价把 lag 立即压到零。
批量读取与并发分别解决什么
XREADGROUP 的 COUNT 可以一次返回多条消息,减少网络往返和调度的固定开销;读取新消息时使用 >,表示领取该消费组中尚未投递过的新消息。COUNT 只是返回数量上限,实际返回数量可以更少。
同一消费组可以运行多个消费者,新消息会分配给其中一个消费者。若单条处理平均耗时为 20ms,单个串行处理单元的理想吞吐约为 条/秒;增加消费者或单实例并发能够提高理论吞吐,但最终仍受 Redis、CPU、网络和下游容量中最窄的一环限制。
用真实消费循环限制在途并发
下面的主示例会真正连接本机 Redis,重建演示 Stream 和消费组,写入 40 条消息,再用 XREADGROUP 分批领取新消息。每批消息交给固定大小的线程池处理,成功后执行 XACK,直到没有新的消息可读。运行前需要已安装 redis Python 包,并确保 Redis 可通过 127.0.0.1:6379 访问。
import time
from concurrent.futures import ThreadPoolExecutor
from redis import Redis

STREAM = "orders-stream-demo"
GROUP = "orders-g"
CONSUMER = "consumer-a"
BATCH_SIZE = 16
MAX_IN_FLIGHT = 8

client = Redis(host="127.0.0.1", port=6379, decode_responses=True)
client.ping()

# 仅清理演示键,保证脚本可重复运行;生产环境不要这样重置 Stream。
client.delete(STREAM)
client.xgroup_create(STREAM, GROUP, id="0-0", mkstream=True)

for order_id in range(1, 41):
    client.xadd(STREAM, {"orderId": str(order_id)})

def process_one(entry):
    message_id, fields = entry
    # 用 20ms 模拟一次受下游容量约束的业务处理。
    time.sleep(0.02)
    return message_id

received = 0
acked_total = 0

with ThreadPoolExecutor(max_workers=MAX_IN_FLIGHT) as executor:
    while True:
        result = client.xreadgroup(
            GROUP,
            CONSUMER,
            streams={STREAM: ">"},
            count=BATCH_SIZE,
            block=200,
        )
        if not result:
            break

        messages = result[0][1]
        received += len(messages)

        successful_ids = list(executor.map(process_one, messages))
        if successful_ids:
            acked_total += client.xack(STREAM, GROUP, *successful_ids)

pending = client.xpending(STREAM, GROUP)["pending"]

print(f"received={received} acked={acked_total}")
print(f"batch_size={BATCH_SIZE} max_in_flight={MAX_IN_FLIGHT} pending={pending}")
预期输出
received=40 acked=40
batch_size=16 max_in_flight=8 pending=0
这里 BATCH_SIZE=16 表示一次最多领取 16 条,而线程池同时真正执行的任务最多只有 8 条。被 XREADGROUP 返回的消息会先进入 PEL,因此批量大小仍会影响单批未确认消息的规模;真实业务还应只确认成功消息,让失败消息保留在 PEL 中等待重试或后续接管。
从下游倒推安全上限
并发预算应从下游倒推,而不是从 Redis 能读多快倒推。假设每条消息恰好产生一次数据库写入,数据库可稳定承载约 500 次写入/秒,单条处理平均 20ms,则平均同时在途的写入约为 。如果部署 5 个消费者实例,这个预算应在实例之间共享,还要为在线请求和短时抖动保留余量。
当积压持续增长时,先观察单条处理耗时和下游延迟;下游健康且 Redis 资源充足时,再逐步增加消费者或单实例并发。若错误率、连接池占用或响应时间明显上升,应先降低总并发,再按需要缩小批量,让新增压力留在 Stream 中排队。
高峰流量治理的核心是让批量读取降低固定开销,让多个消费者分摊工作,再用总并发上限保护下游。只要最窄容量环节没有被击穿,短期积压可以逐步恢复;为了快速清空积压而压垮下游,反而会进入更难收敛的超时与重试循环。