
Redis 与缓存 / 系统课时
理解 Stream Entry 与 ID
理解 Stream Entry 与 ID
本节聚焦 Redis Streams 最基本的消息单位 Entry 与它的 ID。理解 ID 的组成、生成规则和排序语义后,你就能正确判断消息位置,并为后续的范围读取、消费进度与消息回放建立准确的坐标概念。
学习目标
- 看懂 Stream Entry 的字段结构与 ID 格式
- 掌握自动生成 ID 与显式 ID 的顺序约束
- 理解 Entry ID 如何参与范围读取和消费进度定位
Entry 与 ID 的结构
Stream 中每条消息都是一个 Entry,由唯一 ID和一组字段值组成。例如订单事件可以包含 event=order-created、order_id=1001。Redis 保存字段和值,具体业务语义由生产者与消费者共同约定。
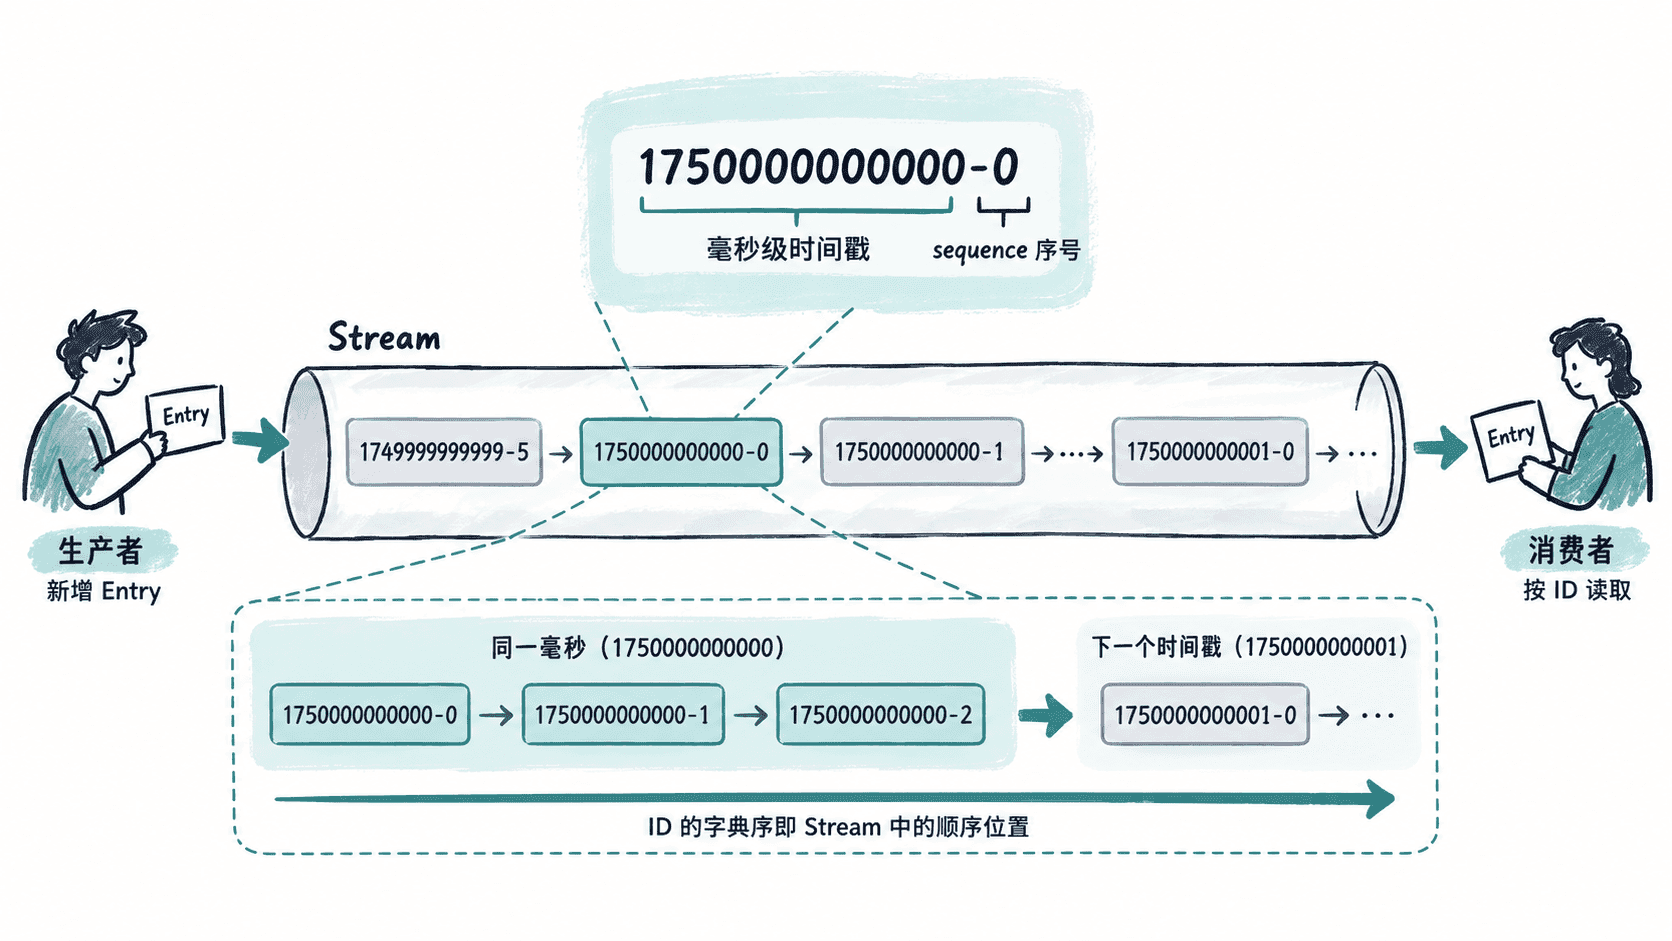
Entry ID 通常写成 milliseconds-sequence,例如 1750000000000-0。前半部分是毫秒时间部分,后半部分是序号;比较两个 ID 时,Redis 先比较毫秒部分,再比较序号,因此同一毫秒内的多条 Entry 也有确定顺序。
自动生成与显式 ID
生产消息时最常见的是把 ID 写成 *,让 Redis 自动生成新 ID。通常服务器当前毫秒时间大于 Stream 最大 ID 的毫秒部分时,新 ID 的序号从 0 开始;如果处于同一毫秒,或服务器时间落后于 Stream 已有最大 ID,Redis 会保证新 ID 仍严格大于当前最大 ID。命令行中的 '*' 使用引号包裹,可避免 Bash 把星号展开为当前目录文件名。
下面清空实验 Stream,写入一条订单事件,再用 XREVRANGE 读取最新一条。读取命令使用 --json,便于稳定观察 RESP 返回值的嵌套层级,而不是依赖终端的编号和缩进样式。
redis-cli DEL orders >/dev/null
ENTRY_ID=$(redis-cli --raw XADD orders '*' event order-created order_id 1001)
printf '%s\n' "$ENTRY_ID"
redis-cli --json XREVRANGE orders + - COUNT 1
预期输出
<ID>
[["<ID>",["event","order-created","order_id","1001"]]]
<ID> 是动态值;在这个没有并发写入的实验中,两处 ID 应相同。XREVRANGE 的 JSON 结构是“Entry 列表 → 单个 Entry 的 ID 与字段数组”:最外层数组包含若干 Entry,每个 Entry 是 [ID, 字段数组],字段数组再按“字段、值”交替排列。因此示例中只有一个 Entry,也只会出现一个用于该 Entry 的 ID。
如果显式指定完整 ID,例如 1750000000000-1,它必须严格大于当前 Stream 的最大 ID;对于新建 Stream,也不能使用 0-0。不满足顺序约束时,XADD 会报错。显式 ID 更适合迁移、历史导入等需要控制消息位置的场景,普通在线生产者通常应优先使用 *,避免自行维护顺序。
ID 如何定位消息
Entry ID 不只是消息编号,也是 Stream 中的位置坐标。XRANGE、XREVRANGE 等命令用 ID 表达读取边界;在消费组中,组会保存已投递位置,而 Pending Entries List 会按 Entry ID 记录已经交付但尚未确认的消息。
因此,看到 1750000000000-1 时,应把它理解成一个可排序、可定位的 Stream 位置。序号 1 表示它排在相同毫秒部分下较小序号之后,这种顺序语义正是范围读取、消费状态追踪和消息回放的基础。
时间部分不是业务事件时间
ID 的毫秒部分不能替代业务事件真正发生的时间。自动 ID 会参考 Redis 服务器时间,但 Redis 的首要约束是生成的新 ID 必须保持单调递增;显式 ID 的毫秒部分则可以由调用方决定。
如果业务需要记录订单创建时间、设备采集时间等领域时间,应把 created_at、event_time 等字段单独写入 Entry。这样 Stream ID 负责排序和定位,业务时间负责表达领域事实,两者职责不会混淆。