
Redis 与缓存 / 系统课时
处理异常消息风暴
处理异常消息风暴
本课把“单条坏消息反复失败”转化为可控的隔离链路:先判断失败是否值得重试,再限制重新投递次数,超过上限后写入死信流并确认原 Pending。这样既保护正常消费,也保留调查与人工重放所需的证据。
学习目标
- 能区分临时失败与不可恢复的毒消息,并设置明确的重试边界
- 能基于 Pending 投递次数判断是否继续自动重试
- 能设计死信隔离与人工重放流程,避免异常消息持续冲击主链路
先判断失败是否值得重试
异常消息风暴通常不是单纯的“消费者太慢”,而是某类消息持续失败并被反复重新交付。下游接口短暂超时、限流等故障通常可以有限重试;字段格式永久错误、业务状态非法或依赖数据长期缺失时,继续重试只会放大压力。
判断重点不是“是否失败过”,而是“失败是否仍有恢复可能”。应用至少应保留原 Stream、消息 ID、失败原因和业务侧最终处理状态。Redis 记录的投递次数可以辅助判断,但它不等价于业务重试策略本身。
用 Pending 投递次数设置上限
XPENDING 的详细形式会返回消息 ID、当前消费者、空闲时间和投递次数。投递次数包含首次投递,因此如果策略规定“首次处理失败后最多再重新投递 3 次”,那么当 delivery count 达到 4 时,就应停止继续自动重试。
下面是片段示例:假定 orders Stream、group-orders 消费组已经存在,consumer-a 当前持有 <ID>,并且应用已判定它超过自动重试上限。先检查 Pending,再写入死信流,最后确认原消息。
# 查看 consumer-a 当前持有消息的投递次数
redis-cli XPENDING orders group-orders - + 10 consumer-a

# 先保存隔离记录;成功后再从原消费组 Pending 中确认
redis-cli XADD orders-dlq '*' source_stream orders source_id "<ID>" reason "<REASON>" delivery_count 4 failed_at "<TIME>" raw_payload "<PAYLOAD>"
redis-cli XACK orders group-orders "<ID>"
预期结果
1) 1) "<ID_1>"
   2) "consumer-a"
   3) (integer) <IDLE_MS_1>
   4) (integer) 1
2) 1) "<ID>"
   2) "consumer-a"
   3) (integer) <IDLE_MS_2>
   4) (integer) 4
"<DLQ_ID>"
(integer) 1<IDLE_MS_1>、<IDLE_MS_2>、<TIME>、<PAYLOAD> 和新生成的 <DLQ_ID> 会随运行而变化。delivery count 是 Redis 记录的投递次数,不等价于应用代码中的局部重试计数,因此生产环境仍应把业务状态与最终处置结果持久化。
隔离顺序要保护证据
死信流建议使用独立 Stream,例如 orders-dlq。写入时不要只复制业务字段,还应保存来源和故障上下文,如 source_stream、source_id、reason、delivery_count、failed_at 与关键业务标识;必要时保留原始载荷或足够的信息用于还原。
正确顺序是先写死信流,再执行 XACK。XACK 只会把消息从该消费组的 Pending Entries List 中移除,不会删除 orders Stream 的原始记录。不过原 Stream 之后仍可能因修剪策略删除旧消息,因此死信记录应具备足够的独立调查信息。
还要注意,XADD orders-dlq 与 XACK orders ... 是两个独立步骤。如果进程在两条命令之间崩溃,恢复后可能再次写入同一条死信记录。可以把 source_stream + source_id 作为幂等键,在应用或同一 Redis 内建立去重机制;仅把这个键写成 Stream 字段并不会自动获得唯一性约束。
让重试与死信形成受控状态流
异常消息处理可以拆成三个状态:正常消息继续主流程;可恢复失败进入受控重试;达到上限或明确不可恢复的消息进入死信流。重试必须同时限制次数、频率和并发,否则只是把风暴从消费者转移到下游服务。
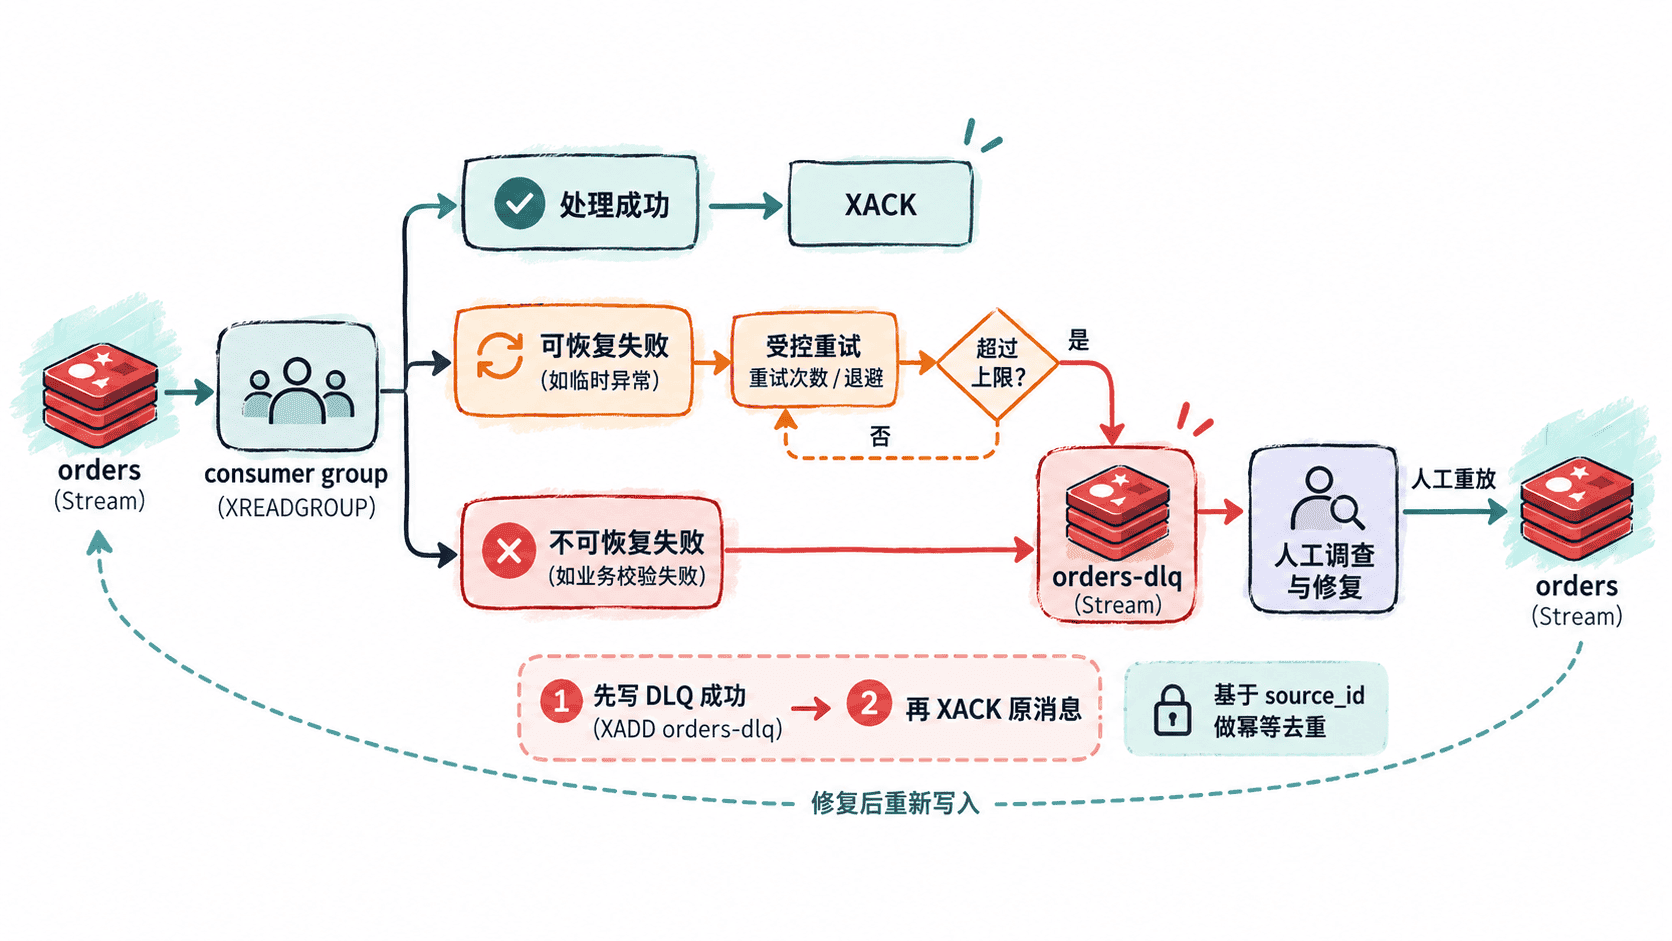
对于需要延迟重试的场景,不要让消费者立即高频地反复处理同一消息。可以由应用维护下一次重试时间,或使用独立重试 Stream 配合调度逻辑重新投递。Redis Streams 负责消息持久化和消费组协调,退避间隔、最大次数和最终隔离条件仍由业务策略决定。
把死信流做成人工介入入口
死信流不是垃圾桶,而是可运营的调查入口。每条记录至少要能回答:原消息是什么、失败了多少次、最后一次为什么失败,以及当前是否允许重放。人工修复根因后,再把业务数据重新投递到正常 Stream,并记录操作者、重放时间和重放结果。
异常消息风暴治理的关键不是保证所有消息无限重试到成功,而是建立清晰边界:正常消息持续前进,临时失败有限重试,毒消息及时隔离,人工能够基于完整上下文决定后续动作。