
Redis 与缓存 / 系统课时
实现消费者接管
实现消费者接管
消费者宕机后,已投递但未确认的消息会继续留在消费组的 Pending Entries List(PEL)中。本课建立一条安全恢复路径:识别真正超时的 Pending,用 XCLAIM 或 XAUTOCLAIM 接管并直接处理其返回消息,业务成功后再 XACK。
学习目标
- 能根据 PEL 空闲时间和消费者状态判断是否需要接管。
- 能正确使用
XCLAIM与XAUTOCLAIM,直接处理命令返回的已接管消息。 - 能通过合理阈值、有限批量和业务幂等降低误抢占与重复处理风险。
先判断哪些 Pending 值得接管
Pending 只表示消息已经投递但尚未确认,不等于原消费者已经故障。XPENDING 明细会给出消息 ID、当前关联消费者、空闲毫秒数和投递次数;只有空闲时间明显超过正常处理窗口,并且原消费者确实不可用或长期无进展时,才适合接管。
下面用一个独立 Stream 建立可重复场景。两个消息先投递给 worker-a,但故意不确认;sleep 2 让它们进入超过 1 秒的空闲状态。
redis-cli DEL orders-takeover-demo >/dev/null
redis-cli XADD orders-takeover-demo 1000-0 order_id order-1001 status paid >/dev/null
redis-cli XADD orders-takeover-demo 1001-0 order_id order-1002 status paid >/dev/null
redis-cli XGROUP CREATE orders-takeover-demo order-workers 0 >/dev/null
redis-cli XREADGROUP GROUP order-workers worker-a COUNT 2 STREAMS orders-takeover-demo ">"
sleep 2
预期输出
1) 1) "orders-takeover-demo"
   2) 1) 1) "1000-0"
         2) 1) "order_id"
            2) "order-1001"
            3) "status"
            4) "paid"
      2) 1) "1001-0"
         2) 1) "order_id"
            2) "order-1002"
            3) "status"
            4) "paid"
再查看最多 10 条 Pending 明细:
redis-cli XPENDING orders-takeover-demo order-workers - + 10预期输出
1) 1) "1000-0"
   2) "worker-a"
   3) (integer) <IDLE_MS>
   4) (integer) 1
2) 1) "1001-0"
   2) "worker-a"
   3) (integer) <IDLE_MS>
   4) (integer) 1
<IDLE_MS> 会随实际执行时机变化。生产环境的接管阈值应明显高于正常处理耗时的高分位数,并为网络抖动、GC 暂停等情况留出余量。
用 XCLAIM 精确接管已知消息
XCLAIM 适合已经通过 XPENDING 拿到明确消息 ID 的场景。下面把 1000-0 接管给 worker-c,仅当它已经至少空闲 1000 毫秒时才会成功:
redis-cli XCLAIM orders-takeover-demo order-workers worker-c 1000 1000-0预期输出
1) 1) "1000-0"
   2) 1) "order_id"
      2) "order-1001"
      3) "status"
      4) "paid"
默认返回值就是成功接管的完整 Stream entry,因此应直接把这条返回消息交给业务处理函数,不需要再执行 XREADGROUP ... 0 才能“取回”消息。只有显式使用 JUSTID 时,XCLAIM 才只返回 ID;普通接管还会更新 PEL 中的消费者关联、重置空闲时间,并增加投递计数。
如果消息实际空闲时间不足阈值,或者已经被确认,它不会出现在返回结果中。接管只是改变 PEL 责任归属,不代表业务已经完成,也不会撤销旧消费者已经产生的副作用。
用 XAUTOCLAIM 批量扫描并接管
Pending 较多时,XAUTOCLAIM 可以从给定游标开始扫描 PEL,并接管达到最小空闲时间的消息。上一节的 1000-0 刚被接管,空闲时间已经重置,因此下面这一轮会跳过它并接管仍然超时的 1001-0:
redis-cli XAUTOCLAIM orders-takeover-demo order-workers worker-c 1000 0-0 COUNT 10预期结果(Redis 7.0 及以后)
1) "0-0"
2) 1) 1) "1001-0"
      2) 1) "order_id"
         2) "order-1002"
         3) "status"
         4) "paid"
3) (empty array)
第一个值是下一次扫描使用的游标;返回 0-0 表示本轮已经扫描到 PEL 末尾。第二个值就是成功接管的完整消息列表,应直接进入业务处理。Redis 7.0 起,第三个数组会列出那些 PEL 仍有记录、但对应 Stream entry 已经被删除或裁剪的 ID;XAUTOCLAIM 会同时把这些失效记录从 PEL 清理掉。
COUNT 用于限制单轮工作量,但实际成功接管数量可能更少,因为扫描过程中会跳过未达到空闲阈值的 Pending。一次扫描尚未返回 0-0 时应继续使用返回游标推进;周期性恢复任务在完成一轮后,之后仍可从 0-0 开始新一轮,因为其他 Pending 可能随后才达到阈值。
把接管做成安全的恢复循环
生产环境应把接管作为独立恢复流程:筛选或扫描超时 Pending,接管有限批量,直接处理 XCLAIM 或 XAUTOCLAIM 返回的 entry,执行幂等业务逻辑,只有成功后才确认;失败则保留 Pending,交给既定重试或失败处理策略。
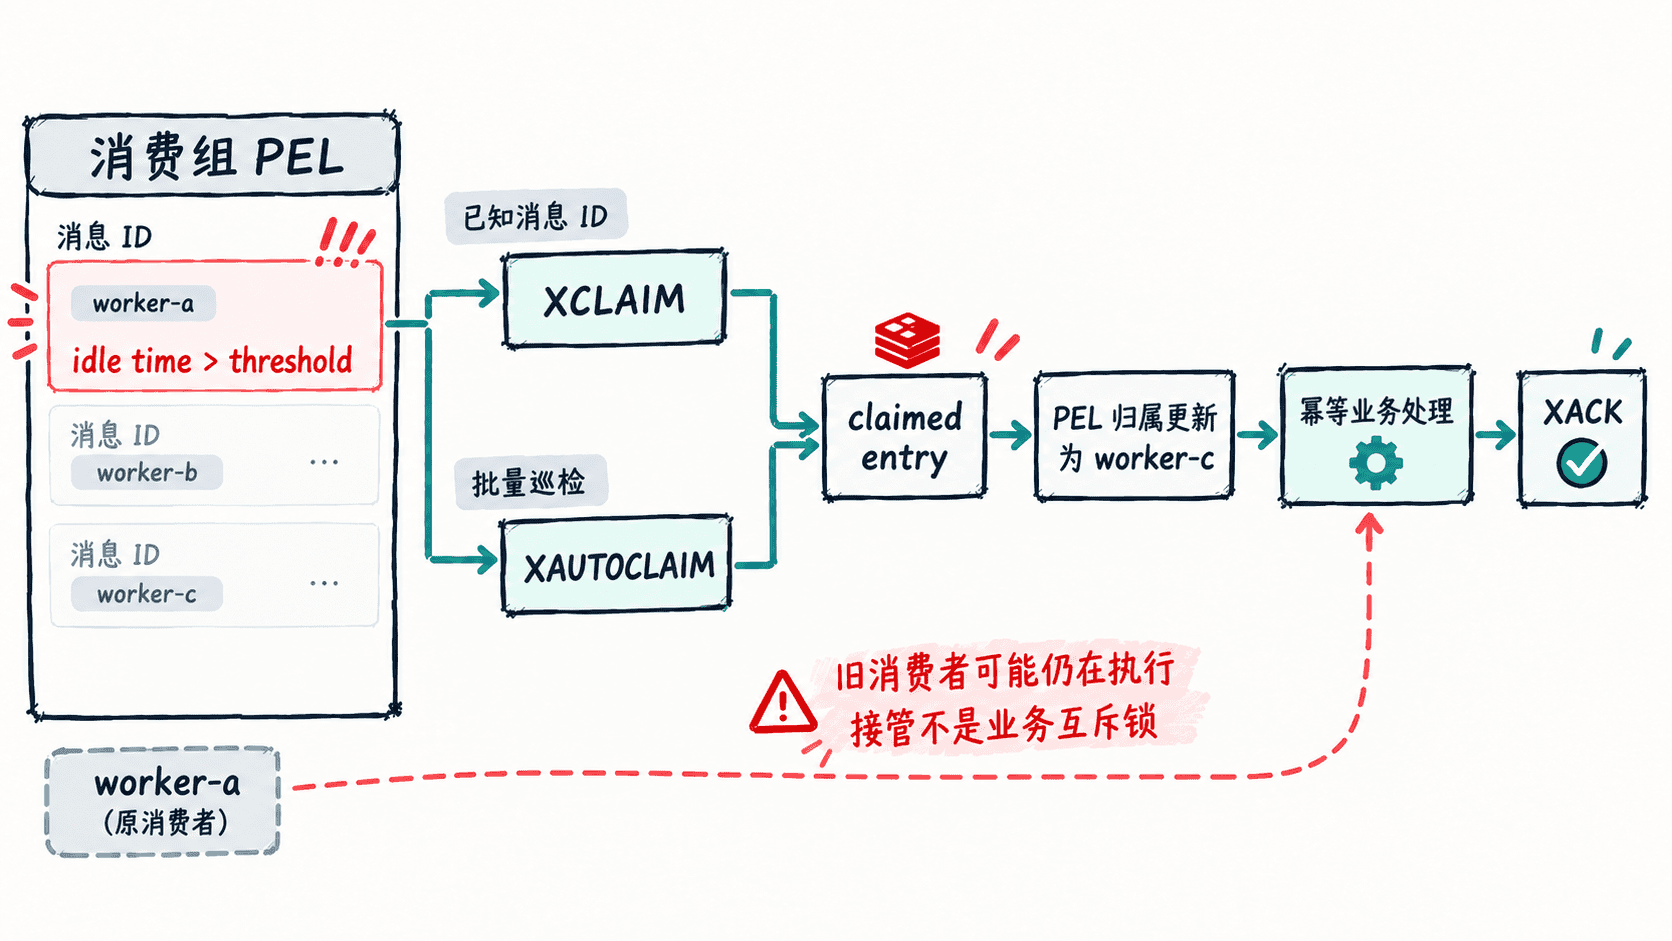
在本示例中,假设两条业务处理都已经成功,再一次性确认:
redis-cli XACK orders-takeover-demo order-workers 1000-0 1001-0预期输出
(integer) 2XREADGROUP ... 0 仍有独立用途:它可以读取“当前消费者自己 PEL 中尚未确认的历史消息”,例如进程重启后继续处理自己此前的 Pending。但它不是 XCLAIM 或 XAUTOCLAIM 之后获取消息内容的必经步骤,因为这两个接管命令本身已经返回成功接管的消息。恢复设计真正要控制的是接管阈值、单轮批量、重试次数与业务幂等,而不是增加一次重复读取。