
Redis 与缓存 / 系统课时
处理消费失败消息
处理消费失败消息
本课解决消费组处理失败消息时最容易出现的两个问题:失败后被过早确认,或同一条坏消息被无限重试。你将把失败分类与 Pending 状态结合起来,明确何时重试、何时确认,以及达到重试上限后如何安全转移消息。
学习目标
- 能区分业务异常、临时故障和永久失败,并判断消息是否值得重试
- 能围绕 Pending 消息设计确认、受控重试和失败转移动作
- 能为消息设置最大重试次数和重试间隔,避免无条件
XACK或无限重试造成处理机会丢失与消费风暴
先判断失败是否值得重试
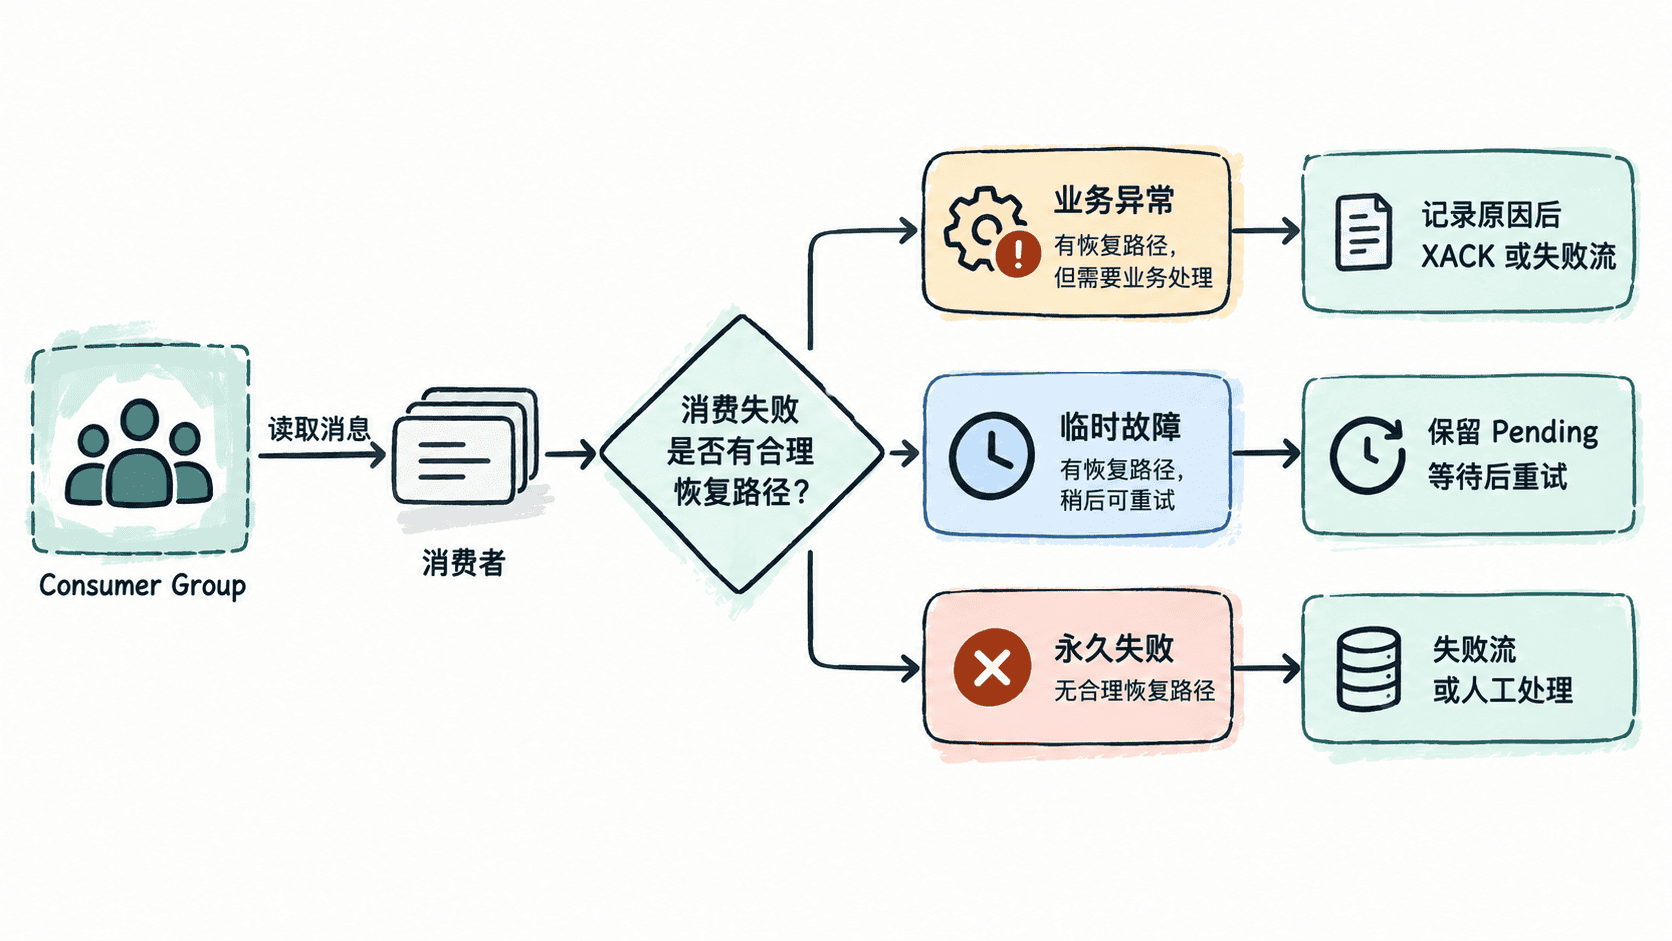
不要看到消费异常就直接 XACK,也不要遇到异常就不断重试。真正需要判断的是:同一条消息在条件恢复后,再次执行是否有合理机会成功。
业务异常通常表示消息触发了明确的业务拒绝,例如库存不足、订单状态不允许。若拒绝结果已经被完整记录并符合业务契约,可以把它视为已处理;继续重试通常不会改变结果。
临时故障通常来自外部依赖或运行环境,例如下游连接超时、数据库瞬时不可用、网络抖动。这类问题有恢复可能,应暂不确认,让消息保留在 Pending 中,并按退避策略受控重试。
永久失败表示继续执行已经没有合理恢复路径,例如消息格式损坏、必要引用永久不存在。此时应停止自动重试,将消息及失败上下文转入失败流或人工处置通道。
| 失败类型 | 常见例子 | 默认动作 |
|---|---|---|
| 业务异常 | 库存不足、状态不允许 | 记录业务结果,完成处置后确认 |
| 临时故障 | 超时、连接失败、短暂不可用 | 暂不确认,延迟并限制重试次数 |
| 永久失败 | 数据损坏、不可恢复引用 | 转失败流,转移成功后确认 |
为什么不能无条件确认
Redis Streams 消费组通过 Pending Entries List(PEL)记录已经投递给消费者但尚未确认的消息。执行 XACK 后,消息会从当前消费组的 PEL 中移除。
这并不等于立即删除 Stream 中的原始条目,但消费组已经把它视为处理完成,不会再把它作为待恢复的 Pending 消息处理。因此,业务动作尚未完成时提前确认,会丢失该消费组依靠 Pending 状态继续恢复处理的机会。
下面用一个主示例观察消息从读取、进入 Pending,到失败转移成功后再确认的状态变化。<ID>、<IDLE_MS> 等是动态值,实际输出会不同。
redis-cli DEL demo:orders demo:orders:failed
redis-cli XGROUP CREATE demo:orders order-workers 0 MKSTREAM

ID=$(redis-cli --raw XADD demo:orders '*' order_id 1001 status paid)
redis-cli --raw XREADGROUP GROUP order-workers worker-1 COUNT 1 STREAMS demo:orders '>'

redis-cli --raw XPENDING demo:orders order-workers - + 10

redis-cli --raw XADD demo:orders:failed '*'   source_stream demo:orders   source_id "$ID"   failure_type permanent   reason invalid_payload   attempts 5

redis-cli XACK demo:orders order-workers "$ID"
redis-cli XPENDING demo:orders order-workers
预期结果
(integer) <VALUE>
OK
demo:orders
<ID>
order_id
1001
status
paid
<ID>
worker-1
<IDLE_MS>
1
<FAILED_ID>
(integer) 1
1) (integer) 0
2) (nil)
3) (nil)
4) (nil)
这个示例的关键不是具体输出格式,而是顺序:消息读取后进入 Pending;失败流写入成功后才执行 XACK;确认成功后,该消息才从当前消费组的 PEL 中消失。XACK 不会删除原 Stream 条目,如需清理原始数据应使用独立的保留与裁剪策略。
为重试设置明确上限
临时故障可以重试,但必须为每条消息同时设置最大重试次数和重试间隔。例如最多尝试 5 次,并采用逐步增加的退避时间;达到上限后停止自动重试并进入失败处置,否则单条坏消息可能长期占用消费者处理能力,甚至形成重试风暴。
Redis Streams 不会自动提供完整的延迟重试调度。生产环境通常由消费者记录累计尝试次数和下次允许执行的时间,并在消息空闲达到阈值后使用 XAUTOCLAIM 等机制接管长期未完成的 Pending 消息。XAUTOCLAIM 负责重新分配消息,不应被当作无间隔循环重试器。
重试计数也不能只存在进程内存中。消费者重启后仍应能判断一条消息已经尝试了多少次,否则每次重启都可能从零开始计数,使所谓的重试上限失效。可以把尝试次数写入独立状态存储,或在失败处置记录中持续更新,并保证同一消息的判定依据可恢复。
失败转移要先成功再确认
当消息达到最大重试次数,或已经被判定为永久失败时,应先把原消息标识和失败上下文写入失败流、死信流或其他可靠存储,再确认原消息。顺序不能反过来:如果先 XACK,随后失败流写入失败,就会失去稳定的自动恢复入口。
失败流至少应保存源 Stream、原消息 ID、失败类型、错误原因和累计尝试次数。是否保存完整原始字段,应根据消息大小、审计要求以及能否通过原消息 ID 回查决定。
如果失败流与原 Stream 位于同一 Redis 实例,可以使用 Lua 脚本把“写入失败流”和“确认原消息”组合为一个原子操作;如果跨系统转移,则不能依赖 Redis 单机原子性,需要通过幂等写入、事务消息或补偿机制保证转移结果可恢复。
失败消息要留下可判断的证据
仅保存“失败了”不足以支持后续恢复。至少应记录消息 ID、失败类型、错误原因、首次失败时间、最近一次尝试时间、累计重试次数以及当前处置状态。这样才能区分偶发故障与持续失败,并判断消息是否已经超过重试边界。
最终原则是:失败消息必须有分类、有状态、有重试上限、有终点。业务拒绝避免无意义重跑,临时故障保留恢复机会,超过最大重试次数或确认不可恢复的消息及时转移;这样 Pending 才是可恢复的处理中状态,而不是无限堆积的重试队列。