
单片机与物联网 / 系统课时
用指标判断 Broker 瓶颈
用指标判断 Broker 瓶颈
当设备连接增多、下行延迟升高或 Broker 内存持续上涨时,单看 CPU 使用率无法判断问题发生在接入、订阅扇出还是下行交付。本篇以 Mosquitto 的 $SYS 计数器配合主机资源和客户端确认延迟,建立一套可复测的瓶颈定位顺序。
学习目标
- 识别连接、入站发布、下行分发、排队与丢弃的指标口径。
- 通过同一时间窗口的计数器差值判断压力位置。
- 把指标异常关联到具体优化动作,并设计复测条件。
先采集同一窗口的关键指标
Mosquitto 可通过 $SYS/broker/ 发布运行状态;多数动态指标按 sys_interval 更新,默认间隔为 10 秒,配置为 0 则停止发布。普通 Topic 订阅 # 不会自动匹配 $SYS,需要显式订阅并为监控账号配置读取权限。
在安装了命令行客户端、可访问本地测试 Broker 的机器上运行:
# 在同一观察窗口采集连接、吞吐和队列指标
mosquitto_sub -h 127.0.0.1 -p 1883 \
  -t '$SYS/broker/clients/connected' \
  -t '$SYS/broker/clients/disconnected' \
  -t '$SYS/broker/mqtt/publish/received' \
  -t '$SYS/broker/mqtt/publish/sent' \
  -t '$SYS/broker/mqtt/publish/dropped' \
  -t '$SYS/broker/store/messages/count' \
  -t '$SYS/broker/packet/out/count' \
  -v -W 30
预期输出(指标格式节选;数值与接收顺序并不固定):
$SYS/broker/clients/connected <COUNT>
$SYS/broker/clients/disconnected <COUNT>
$SYS/broker/mqtt/publish/received <COUNT>
$SYS/broker/mqtt/publish/sent <COUNT>
$SYS/broker/mqtt/publish/dropped <COUNT>
$SYS/broker/store/messages/count <COUNT>
$SYS/broker/packet/out/count <COUNT>
其中 publish/received、publish/sent 和 publish/dropped 为累计量;store/messages/count 与 packet/out/count 是当前量。前者包含保留消息和持久会话待发消息,后者是跨客户端等待网络发出的报文数量,不能把两者相加当作统一积压深度。指标定义以 Mosquitto Broker Status 文档 为准,不同版本可能有增减。
用增量还原吞吐与订阅扇出
每隔 60 秒保存一次累计计数器,速率等于两次差值除以 60。假设入站 publish/received 从 120000 增至 132000,得到 200 条/秒;出站 publish/sent 从 540000 增至 594000,得到 900 条/秒。下行与上行的比值约为 4.5,可能来自一条消息匹配多个订阅者,不能直接称作消息重复或异常。
每次计算都要使用相同时间窗口,特别是与网络发送字节、CPU 和客户端延迟对齐。Broker 重启可能导致累计计数器归零;出现计数回退,应重置速率计算而不是记为负吞吐。比较 publish/sent 时还需考虑重传、消息大小及订阅者数量,不能单凭条数估算网卡负载。
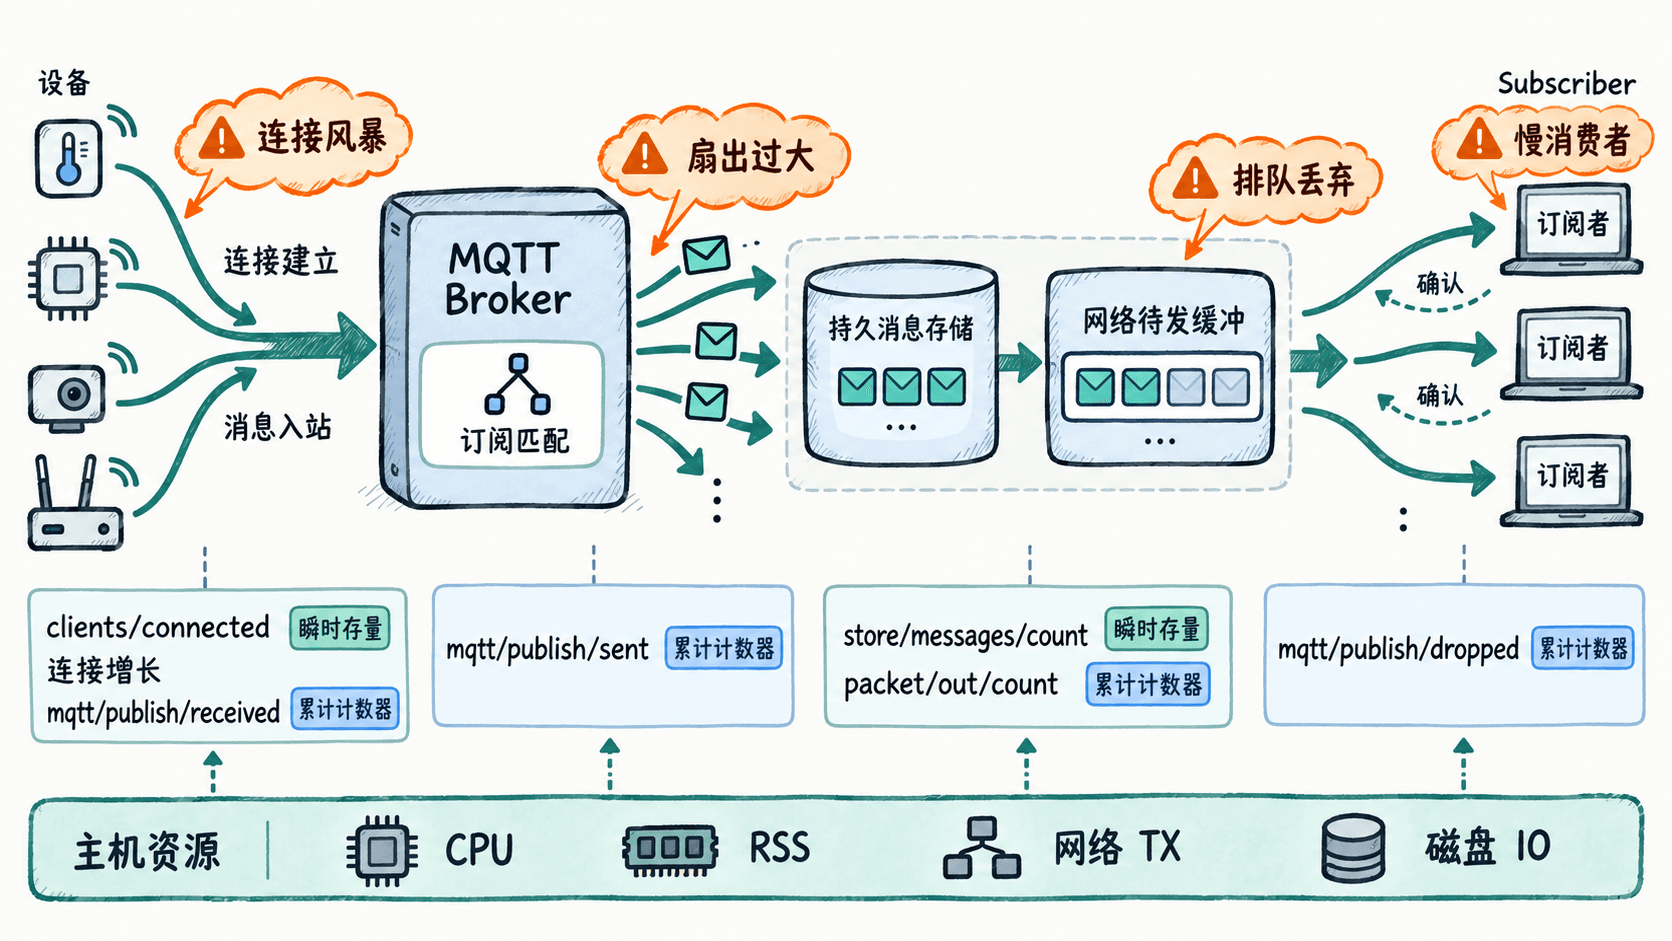
用异常组合缩小瓶颈范围
| 同一窗口的现象 | 优先排查方向 |
|---|---|
clients/connected 频繁波动,连接速率和 CPU 同时升高 |
设备批量重连、TLS 握手、认证负载 |
| 入站速率稳定、出站速率远高于入站,网络发送带宽逼近上限 | 宽泛订阅、消息扇出、下行带宽 |
clients/disconnected 和 store/messages/count 同涨 |
持久会话离线堆积;须排除保留消息变化 |
packet/out/count 持续上升,在线客户端确认变慢 |
下游网络拥塞或慢消费者 |
mqtt/publish/dropped 累计值持续增加 |
队列或 in-flight 限制;核对相关配置及客户端 |
这些现象是定位线索,不是单指标定责。例如出站远大于入站可能完全符合四个订阅者同时消费一条遥测的设计;而 store/messages/count 上升也可能是新增 Retained 消息。必须把 Topic 命中量、会话数量、客户端日志和实际消息到达时间一起核查。
用主机资源验证推断
在 Linux 主机上,可先读取 Mosquitto 进程的 CPU 与常驻内存,配合监控平台查看网卡发送速率、文件描述符数量、磁盘写入和端到端延迟。
# 读取 Linux 上 Broker 进程的 CPU 和常驻内存
ps -C mosquitto -o pid,%cpu,rss,etime预期输出(数值为动态占位,RSS 单位为 KiB):
  PID %CPU   RSS     ELAPSED
 <ID> <CPU> <RSS> <TIME>
如果 CPU 升高但出站带宽仍低,继续核查连接认证频率、订阅匹配与消息处理成本;如果网络 TX 已接近链路能力且 packet/out/count 增长,应优先压缩载荷、减少扇出或扩展下行容量。若内存和持久消息存储同时上涨,则按客户端队列限额与离线会话分析,不能靠重启清空积压冒充修复。
建立告警与复测标准
设置告警时使用连续窗口而不是单个尖峰:例如丢弃累计计数在连续 3 次采样中增加、消息存储量持续增长 5 分钟且未回落、连接速率明显超出正常基线。CPU 80% 或延迟 500 毫秒只能作为示例阈值,应按机器规格与业务时限校准。
一次可重复的验收是:在测试环境稳定输入 200 条/秒,安排 4 个匹配订阅者,记录理论下行约 800 条/秒的扇出规模;持续 5 分钟,同时检查实际客户端收到的消息、QoS 确认延迟、出站字节和丢弃计数。通过标准可以定为丢弃计数不增加、客户端处理速率跟上、队列回到基线且关键消息端到端延迟满足业务目标。只有这些条件同时满足,才能认为对应瓶颈已缓解。