
游戏 AI / 系统课时
上线前核对容量隐私与成本
上线前核对容量隐私与成本
NPC 对话功能即使在开发环境可用,也可能在活动高峰耗尽模型速率额度,或因日志记录原始聊天和密钥造成数据泄露。本课用具体峰值假设估算请求量、Token 和费用,再落实服务端限流、隐私检查与降级验收。
学习目标
- 根据在线人数、对话频率和耗时估算 RPM、TPM 与在途并发。
- 核对日志留存、玩家数据处理和服务端密钥权限。
- 为超额、异常和预算耗尽准备可验证的告警与降级开关。
从在线人数推算峰值容量
假设活动期间同时在线 4000 人,每分钟约有 15% 的玩家各发起一轮 NPC 对话,则需求是每分钟 600 次请求,即平均 10 RPS。若一次调用平均输入 1100 Token、输出 200 Token,那么基础需求是 780000 TPM,不是只看请求次数就能确定的额度。
再给突发和波动留出 30% 余量,目标至少覆盖 780 RPM 与 1014000 TPM。假设平均在途耗时 2.5 秒,按每秒 10 次请求估算约有 25 个未完成请求;算上同样的余量约需容纳 33 个。这个并发数是基于平均值的容量起点,排队和长尾仍要通过压测验证。
上线前必须从实际供应商控制台核对所用模型、组织和项目的 RPM、TPM、并发及账户预算限制;不同模型或账户不一定共用额度。多次重试、摘要记忆调用、工具调用后的二次生成,以及缓存未命中,都可能放大实际用量。
这里的 15% 代表每分钟发起一轮对话的玩家比例。如果部分玩家每分钟连续追问两三次,就要按实际请求轮次重新估算;同时在线人数本身不能直接等于模型并发请求数。
用脚本核算容量和费用
保存下面程序为 capacity.py,使用 Python 3 运行。价格 2.0 和 8.0 只是用于展示算法的假设美元单价,单位是每百万输入与输出 Token;不代表任何供应商的当前报价。
from math import ceil

online = 4000
turns_per_player_per_min = 0.15
input_tokens, output_tokens = 1100, 200
input_usd_per_million = 2.0
output_usd_per_million = 8.0
headroom = 1.30
average_latency_sec = 2.5

# 同时检查按请求计数和按Token计数的两个容量维度
rpm = online * turns_per_player_per_min
tpm = rpm * (input_tokens + output_tokens)
inflight = ceil(rpm / 60 * average_latency_sec * headroom)

# 按全部请求均未命中缓存、且没有额外重试估算峰值费用
hour_usd = rpm * 60 * (
    input_tokens * input_usd_per_million
    + output_tokens * output_usd_per_million
) / 1_000_000

print(f'峰值需求: {rpm:.0f} RPM')
print(f'预留后额度: {ceil(rpm * headroom)} RPM / {ceil(tpm * headroom)} TPM')
print(f'估计在途请求: {inflight}')
print(f'峰值每小时模型费: ${hour_usd:.2f}')
预期输出:
峰值需求: 600 RPM
预留后额度: 780 RPM / 1014000 TPM
估计在途请求: 33
峰值每小时模型费: $136.80
这笔费用对应持续一小时都处于估计峰值的场景,未包含检索、存储、网络、重试和额外生成等支出。生产预算要使用实际合同单价和计费使用量重算,并分别观察日费用、单轮费用和版本费用,避免流量增加时误判为单轮成本回归。
如果使用缓存,需把缓存命中率、未命中请求的 Token 分布以及缓存自身费用单独纳入计算。对于长对话,平均 Token 也可能掩盖特别长的上下文,应同时检查高分位输入长度,防止少量大请求触发 TPM 限制。
把限流和降级放在可信后端
客户端不能直接持有模型密钥,也不能自行决定请求是否具有游戏动作权限。请求先经过游戏后端身份校验、每玩家并发限制和按项目统计的 RPM/TPM 额度控制,再进入有长度与等待上限的队列。示例可限制同一玩家仅有 1 个在途 NPC 请求,队列等待超过 2 秒即返回固定的稍后再试台词。
供应商返回限流或暂时不可用时,可对可安全重放的请求执行一次带随机退避的重试;必须检查请求标识与重复副作用风险,防止重复扣费或重复提交动作。持续超额时关闭新模型调用,改用预审的静态对白或受限菜单;回退响应不得修改任务、货币或玩家关系。所有实际游戏动作仍走服务端授权校验。
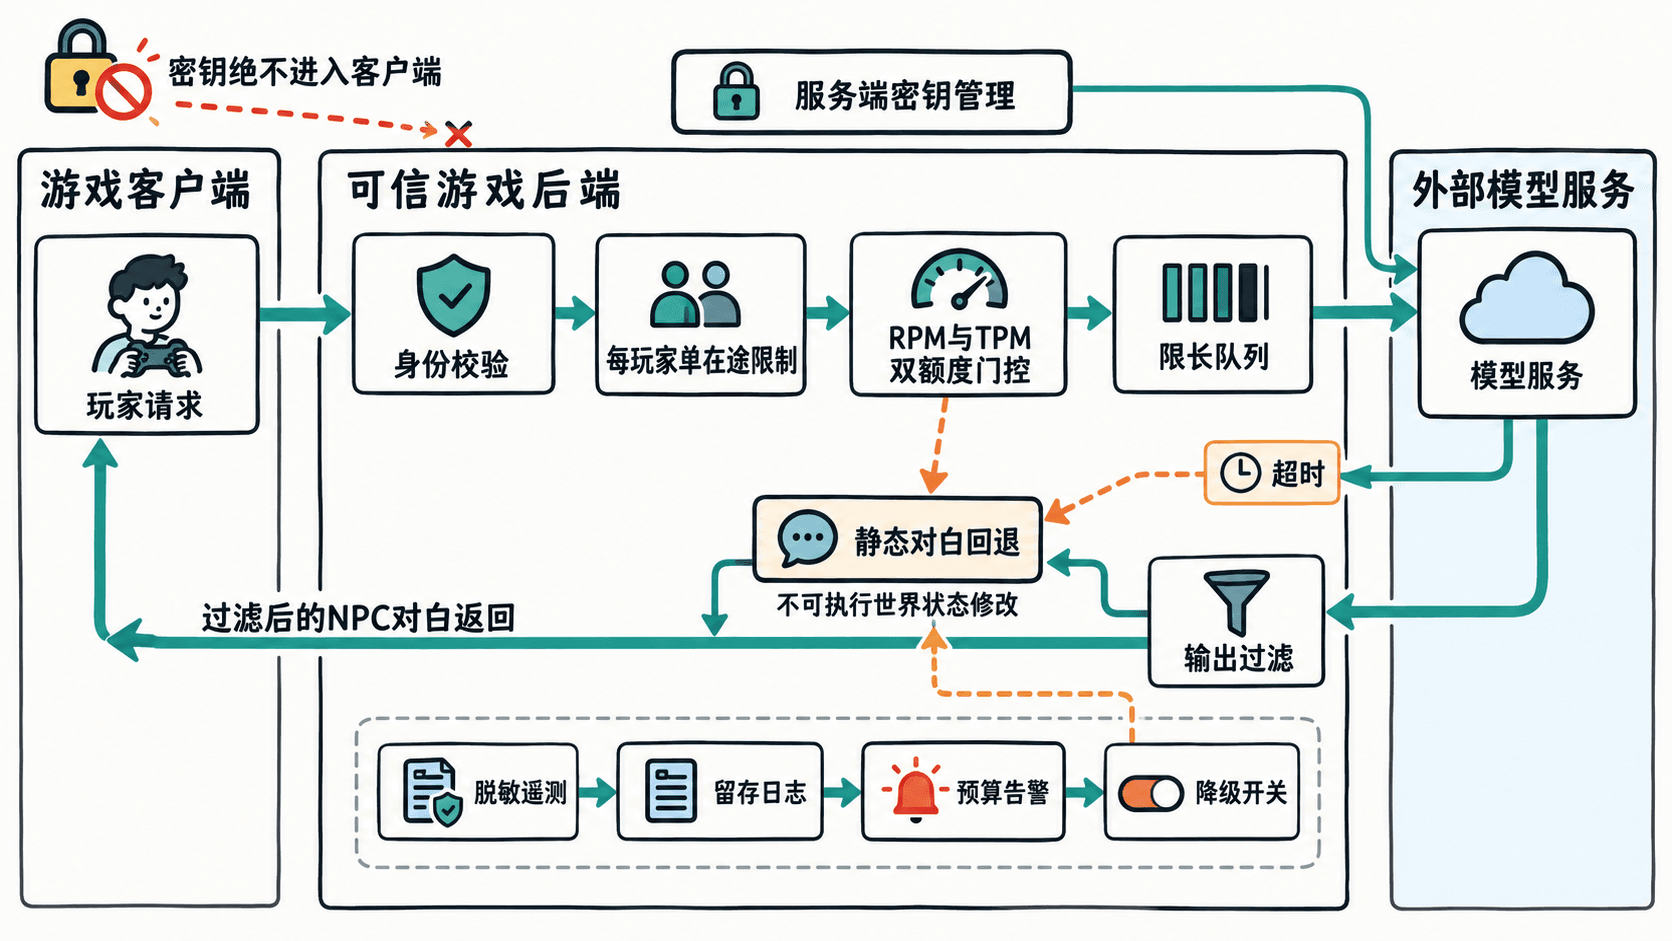
故障时要记录因限额回退、因超时回退、因预算回退三个不同原因,便于判断是容量不足、网络问题还是主动止损。降级开关应由服务端配置控制,并具有审计记录,不依赖重新发布客户端。
容量保护也要考虑排队公平性。不能让一个高频玩家占满全部请求槽位;可以按玩家或会话实施配额,并为关键剧情对话设置独立的受控容量,但不应以绕过供应商额度限制的方式保证优先级。
核对隐私、留存和密钥
日志默认只保存排障所需字段,例如 requestId、NPC 标识、脱敏会话标识、模型与提示版本、结果状态、延迟、Token 用量和降级原因。玩家自由输入、私聊内容、设备标识、完整记忆、鉴权凭据及请求头中的密钥不应进入常规日志。需要短期采样原始内容时,应另有权限、目的、脱敏和删除流程。
与团队确认玩家数据的用途、告知与合法处理依据、供应商处理条款、跨境传输、删除请求和备份清理机制。日志保留 14 天可以作为待评审的内部示例值,不是自动满足隐私法规的期限;应由实际业务政策决定,并通过删除演练验证原始记录和索引会按期消除。
模型凭据只放在服务端密钥管理设施中,使用最小项目权限,限制访问密钥的服务身份,配置轮换与泄露撤销路径。测试一次客户端抓包、日志检索、错误追踪检查:三处都不应出现凭据或未经批准的玩家原文。
NPC 长期记忆还要与诊断日志区别管理。玩家关系、任务事件等应以权威业务记录为来源,按照玩家身份和 NPC 作用域隔离访问。删除玩家数据时,不能只删除聊天 UI 的展示内容,还应检查持久记忆、检索索引及允许保留的审计记录是否符合已确定的处理规则。
验证预算告警和上线止损
把成本告警绑到实际计费用量上,而不只依赖预估。示例策略是在当日预算使用达到 80% 时通知值班人员;达到 100% 时暂停新 LLM 请求并启用静态对白。错误率超过 2% 且持续 5 分钟,或端到端 P95 超过 2500 ms 且持续 5 分钟时,停止扩量并检查队列、供应商限流和重试放大。
上线演练应按顺序覆盖:
- 使用模拟上游在预发布环境施加等效 600 RPM 的压力,确认队列不无限增长、每玩家在途上限生效,且 RPM/TPM 触顶时有确定的回退。
- 注入限流、超时和鉴权失败,验证重试次数上限、错误分类、静态对白与告警到达情况;鉴权失败不可无条件重试。
- 触发测试预算阈值和远程降级开关,检查新请求不再调用模型,同时已确认的任务状态保持不变。
- 抽查日志与密钥轮换记录,再将降级开关恢复,确认恢复后费用、延迟和错误率回到可接受范围。
预算控制要考虑供应商费用数据的上报延迟。仅依赖每日账单可能在报警前已经发生超支,因此最好同时用实时 Token 消耗估算费用,并预留正在处理的请求所需预算。触发硬限额时,应明确在途请求是允许完成还是主动取消,避免重复提交或无响应界面。
验收记录至少附上峰值请求与 Token 估算、实际账户额度、压测 P95 和错误率、预算阈值、数据保留审批、密钥权限核查和降级演练结果。任一项没有责任人或没有验证证据,都不应以功能已跑通代替上线放行。