
游戏 AI / 系统课时
缩短上下文并控制 Token 成本
缩短上下文并控制 Token 成本
NPC 如果每轮都带上全部聊天记录、完整世界设定和大量检索片段,既会拉长首字等待,也会重复支付输入 Token 费用,甚至淹没当前任务事实。本课从每类上下文的用量台账入手,建立裁剪顺序、输入预算和输出上限,再验证成本下降是否影响对话正确性。
学习目标
- 按角色规则、状态、历史、记忆、检索与封装开销拆分输入 Token。
- 在不丢失权威事实的前提下限制检索片段与回复长度。
- 用可执行预算器估算成本,并通过对照样本检查质量退化。
给每类上下文单独记账
计数对象是最终送给模型的消息内容,而不是源文档字符数。先用目标模型适配的 tokenizer 计算各片段 Token,再用响应返回的实际输入、输出用量核对总账;消息边界、工具定义、缓存或模型额外输出会使分项估算与最终计费值不同。
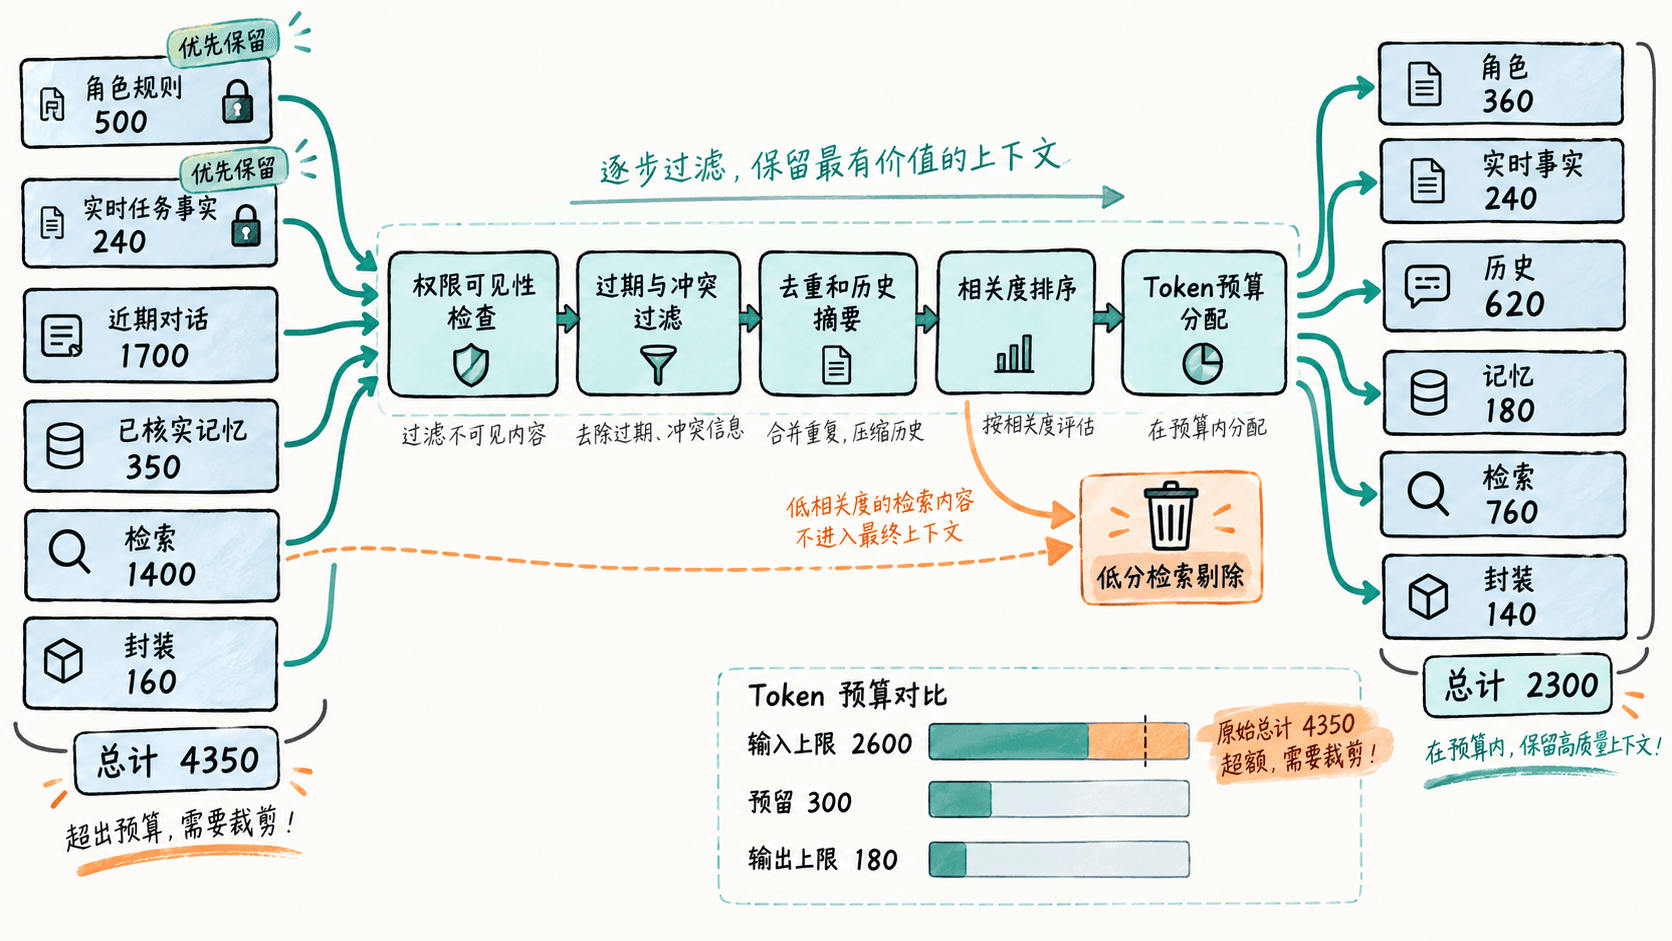
以下是一轮对话的教学假设数据,单位均为 Token,不是接口实测值:
| 输入组成 | 裁剪前 | 裁剪后 |
|---|---|---|
| 角色规则 | 500 | 360 |
| 实时任务事实 | 240 | 240 |
| 近期对话 | 1700 | 620 |
| 已核实长期记忆 | 350 | 180 |
| 检索片段 | 1400 | 760 |
| 消息封装开销 | 160 | 140 |
| 输入合计 | 4350 | 2300 |
例如给单轮输入设置 2600 Token 的业务上限,其中保留 300 Token 作为格式与计数余量,可分配给已知片段的预算就是 2300 Token。输出另设 180 Token 上限,并确认输入、输出及其他模型开销都满足所选模型的上下文限制;不能把 Token 上限理解为字符数。
按可信度和价值裁剪
- 必须保留:服务端权威任务状态、玩家可见的当前事实、禁止越权的规则。规则能去重改写,但不能为了省 Token 删除约束。
- 压缩重复信息:角色档案只保留本轮需要的身份、语气和行为边界;近期历史保留最后几轮原文,较早对话转成已核实事实摘要,保留关联事件 ID 便于回查。
- 筛选检索结果:先按玩家权限、NPC 知识边界和有效期过滤,再按相关度排序;例如最多取两段,合计不超过 760 Token。过期事实和互相冲突的片段不应因为分数高就混入提示。
- 约束输出:按场景限定台词篇幅并配置模型实际支持的输出上限;若还需结构化意图,必须给字段保留空间,不要靠截断输出制造不完整 JSON。
用预算器限制检索并计算成本
下面的各分类数值视为已经完成 tokenizer 测量的结果。检索候选也假定已通过权限与时效检查;代码再做相关度、总量筛选。价格仅为计算演示的假设:输入每百万 Token 2 美元、输出每百万 Token 8 美元,并非当前服务商报价。
before = {"角色规则": 500, "实时任务事实": 240, "近期对话": 1700,
          "长期记忆": 350, "检索片段": 1400, "封装": 160}
base = {"角色规则": 360, "实时任务事实": 240, "近期对话": 620,
        "长期记忆": 180, "封装": 140}
candidates = [("门禁钥匙", 0.94, 340),
              ("守卫轮班", 0.87, 420),
              ("低相关旧线索", 0.49, 620)]
input_cap, reserve = 2600, 300
usable = input_cap - reserve
used = sum(base.values())
selected = []

# 候选必须先在业务层通过权限、时效和事实来源检查
for name, score, tokens in sorted(candidates, key=lambda x: x[1], reverse=True):
    if score < 0.70 or used + tokens > usable:
        continue
    selected.append(name)
    used += tokens

def estimate_usd(input_tokens, output_tokens):
    # 以下单价只是教学假设,实际以服务商计费记录为准
    return (input_tokens * 2 + output_tokens * 8) / 1_000_000

assert used <= usable
print(f"入选检索:{'、'.join(selected)}")
print(f"输入占用:{used}/{usable} tokens(另留 {reserve})")
print(f"每轮估算:${estimate_usd(sum(before.values()), 260):.6f} → "
      f"${estimate_usd(used, 180):.6f}")
预期输出:
入选检索:门禁钥匙、守卫轮班
输入占用:2300/2300 tokens(另留 300)
每轮估算:$0.010780 → $0.006040
这笔估算只对照同样的教学假设单价与输出量。正式成本应按接口实际 usage、缓存计费规则和失败重试量汇总,不能把预算器的预测数字直接当作账单。
检查省 Token 后的答复质量
固定一组覆盖普通闲聊、任务推进、玩家试探越权、记忆冲突和检索无命中场景的测试对话,分别跑裁剪前与裁剪后的提示。每组保持相同的输入事实及评分规则,记录输入与输出 Token、首字 P95、完整回复 P95、事实错误、漏答和越权意图比例。
如果成本下降却出现 NPC 忘记任务阶段、把过期线索说成事实、或者意图字段缺失,先检查被删除的来源和摘要证据,再局部增加对应预算;不要直接恢复整段历史。只有当费用、延迟和业务正确率一起满足验收线,才能把新预算用于线上默认配置。