
游戏 AI / 系统课时
串起任务记忆检索与动作闭环
串起任务记忆检索与动作闭环
玩家向药师 NPC 提出领取任务奖励时,系统需要同时读取任务进度、召回相关记忆、检索奖励规则,再让模型生成回应。若满足领取条件,还要由游戏服务完成奖励结算。本课把这些环节接成一条可运行链路,并通过重复请求验证状态一致性与动作幂等。
学习目标
- 设计玩家输入、权威任务状态、NPC 记忆和世界知识的端到端数据流。
- 将模型生成的台词与动作意图交给服务端校验和执行。
- 验证奖励结算、重复请求、状态变化和异常回退的行为。
明确一轮对话的输入输出契约
假设玩家已经采集三株草药,正在与村庄药师交谈。玩家输入“我要领取奖励”,系统需要判断任务是否完成、是否已经领奖,并决定是否发放十枚金币。
客户端只负责发送对话请求,不负责声明任务已经完成。一次请求至少需要以下信息:
| 字段 | 来源与用途 |
|---|---|
requestId |
区分一次对话请求,处理重试和重复提交 |
playerId |
从服务端已认证会话确定玩家身份 |
npcId |
标识当前交互的 NPC,服务端检查交互权限 |
text |
玩家原始输入,长度和内容必须校验 |
客户端可以携带用于关联的标识,但服务端必须校验它与登录会话、当前交互对象是否一致。背包数量、金币余额、任务进度和奖励领取记录均从游戏服务读取,不能采用客户端自报值。
模型只生成两个业务字段:line 是候选台词,intent 是候选动作。允许的动作包括 none 和 claim_reward。即使模型输出 claim_reward,也不代表奖励已经到账。
动作完成后,后端返回经审核的 NPC 台词、动作执行结果和更新后的权威状态。客户端根据结果展示台词、金币变化或失败提示,而不是直接相信模型声称的执行结果。
在服务端合并三类上下文
一轮 NPC 对话通常需要三种信息来源,它们具有不同的时效、可信度和访问约束。
权威任务快照来自游戏服务,包含当前采集数量、领取状态和玩家身份。它用于判断客观事实,也是后续动作授权的依据。
长期记忆来自已经确认的玩家事件。例如玩家曾帮助药师找回药箱,可以影响 NPC 的称呼和语气。读取时需要按 playerId、npcId 以及验证状态过滤,不能把其他玩家的记忆混进当前会话。
世界知识来自可检索的设定文档,例如“三株草药可兑换十枚金币”。检索结果还必须经过区域、可见性和权限过滤。未解锁任务、隐藏仓库和管理员资料即使语义相关,也不能加入模型上下文。
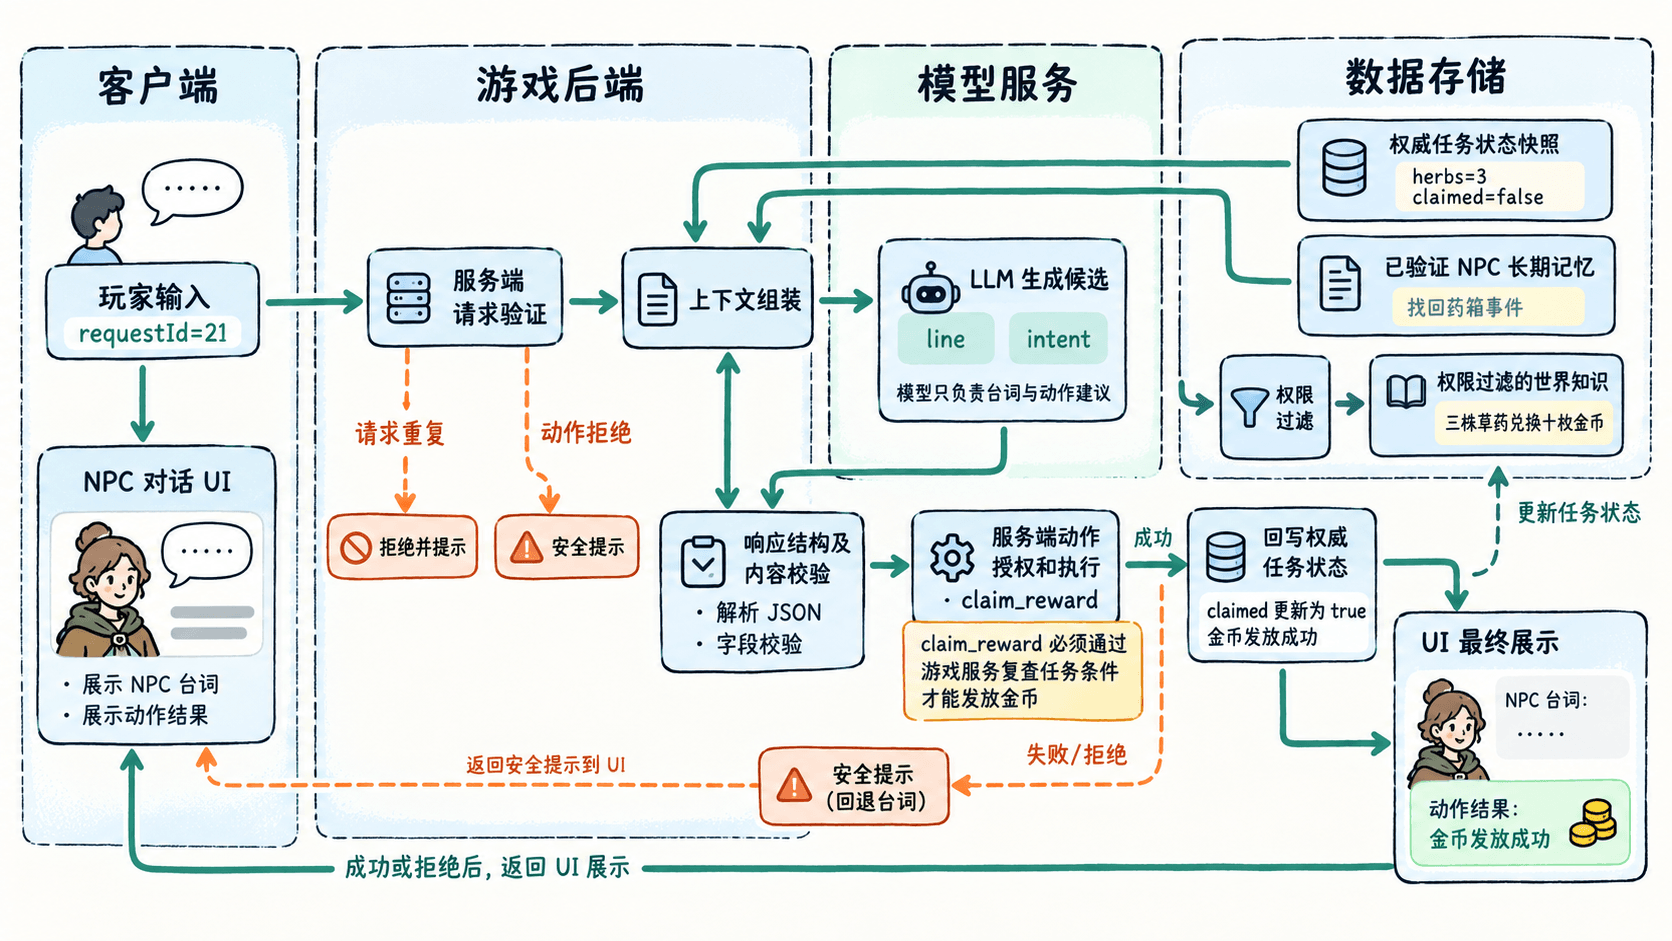
执行顺序应保持明确:
- 服务端验证请求和玩家身份,获取当前 NPC 的交互上下文。
- 读取任务权威快照,并按玩家和 NPC 范围召回已验证的记忆。
- 根据玩家问题检索世界知识,过滤不可见内容并限制返回数量。
- 将三类上下文与角色规则组装为模型输入,得到结构化候选响应。
- 校验候选台词、动作枚举和业务权限,随后重新检查权威状态并执行动作。
- 将已确认的执行结果发送到 UI,必要时异步写入经过验证的新记忆。
模型输出不能直接写入长期记忆。只有经过业务校验的事件,例如奖励确实发放成功,才可以作为后续记忆的可信来源。
用可运行样例打通闭环
下面的 Python 示例使用标准库构造一个最小药师 NPC。model_adapter 是本地模拟模型适配器,返回与真实模型约定一致的 line 和 intent,因此无需 API Key 就能验证完整业务路径。
示例初始状态为采集草药数量 3、金币 0、尚未领奖。第一次请求可以成功领取奖励;相同请求编号重复发送时直接返回缓存结果;使用新请求编号再次领取时,系统发现奖励已经领取。
from dataclasses import dataclass

@dataclass
class World:
    player_id: str
    herbs: int
    claimed: bool = False
    coins: int = 0

world = World(player_id='demo-player', herbs=3)

memory_rows = [
    {
        'player_id': 'demo-player',
        'npc_id': 'herbalist',
        'verified': True,
        'fact': '上次找回药箱'
    }
]

knowledge_rows = [
    {'zone': 'village', 'visibility': 'public', 'text': '三株草药可兑换十枚金币。'},
    {'zone': 'village', 'visibility': 'private', 'text': '隐藏仓库位置。'}
]

handled = {}

def model_adapter(question, snapshot, memories, facts):
    # 模拟模型只提出回复和动作意图,不修改游戏状态。
    prefix = f'我记得你{memories[0]}。' if memories else ''
    if '领取' not in question:
        return {
            'line': prefix + (facts[0] if facts else '想聊些什么?'),
            'intent': 'none'
        }
    if snapshot['claimed']:
        return {'line': prefix + '奖励已经领取过了。', 'intent': 'none'}
    if snapshot['herbs'] < 3:
        missing = 3 - snapshot['herbs']
        return {'line': prefix + f'还差{missing}株草药。', 'intent': 'none'}
    return {
        'line': prefix + (facts[0] if facts else '我来核对奖励。'),
        'intent': 'claim_reward'
    }

def handle(player_id, npc_id, request_id, question):
    key = (player_id, request_id)
    if key in handled:
        return handled[key]
    if player_id != world.player_id or npc_id != 'herbalist':
        return '访问拒绝'
    if not (1 <= len(question.strip()) <= 120):
        return '输入无效'

    snapshot = {'herbs': world.herbs, 'claimed': world.claimed}
    memories = [
        row['fact'] for row in memory_rows
        if row['player_id'] == player_id
        and row['npc_id'] == npc_id and row['verified']
    ][:2]
    facts = [
        row['text'] for row in knowledge_rows
        if row['zone'] == 'village' and row['visibility'] == 'public'
    ][:2]

    candidate = model_adapter(question, snapshot, memories, facts)
    if (not isinstance(candidate.get('line'), str)
            or candidate.get('intent') not in {'none', 'claim_reward'}):
        return '回复校验失败'

    action = '无动作'
    if candidate['intent'] == 'claim_reward':
        # 执行动作时重新检查权威状态,不能只相信旧快照。
        if world.herbs >= 3 and not world.claimed:
            world.claimed = True
            world.coins += 10
            action = '奖励到账'
        else:
            action = '动作拒绝'

    # 动作提交后才构造最终展示结果。
    line = candidate['line'] if action != '动作拒绝' else '任务状态有变化,请重试。'
    result = f'台词={line} | 动作={action} | 金币={world.coins}'
    handled[key] = result
    return result

for request_id in ('turn-a', 'turn-a', 'turn-b'):
    result = handle('demo-player', 'herbalist', request_id, '我要领取奖励')
    print(f'{request_id}: {result}')
预期输出:
turn-a: 台词=我记得你上次找回药箱。三株草药可兑换十枚金币。 | 动作=奖励到账 | 金币=10
turn-a: 台词=我记得你上次找回药箱。三株草药可兑换十枚金币。 | 动作=奖励到账 | 金币=10
turn-b: 台词=我记得你上次找回药箱。奖励已经领取过了。 | 动作=无动作 | 金币=10
输出中前两行相同,是因为重复的 turn-a 请求返回了已经保存的响应,并没有再次执行奖励。第三行使用新的请求编号,模型适配器读取到 claimed=True,因此只返回已领取的台词,不再申请奖励。
本例的知识记录包含一条私有文档,但检索过滤只返回 visibility=public 的内容。记忆读取也只接受对应玩家、对应 NPC 且已经验证的记录。可以修改这两组数据进行检查,确认不匹配的信息不会出现在候选台词中。
验证重试、并发与失败回退
本地示例使用内存字典 handled 模拟幂等记录,适合学习链路但不适合直接作为分布式生产实现。进程重启会丢失记录,多实例并发请求也可能同时看到奖励尚未领取。
生产环境应把领取条件检查、奖励发放、领取状态修改和幂等记录写入同一个可靠事务。幂等键至少关联玩家身份与 requestId,还要校验同一键重试时的请求内容一致,避免不同操作误用同一编号。
建议完成以下验收:
- 任务未完成:将初始草药数量改为 2,确认 NPC 提示还差一株,金币不增加,领取状态保持未完成。
- 重复领取:用相同请求编号以及不同请求编号分别重试,确认奖励只发放一次。
- 检索权限:加入其他玩家的记忆和私有知识,确认它们不会进入当前 NPC 的模型上下文。
- 动作冲突:模拟生成候选回复之后,另一个请求已经领取奖励。执行阶段必须重新检查状态,并把失败结果转换成安全提示。
- 模型或网络失败:让模型适配器抛出异常或返回非法结构,服务端应捕获错误、记录请求关联信息并返回固定回退结果,不得沿用未经验证的候选台词。
接入真实 LLM 时,可以将本例的 model_adapter 替换为后端模型调用,并增加超时控制、结构化响应解析和内容审核。任务状态、记忆权限、知识可见性、动作授权和幂等事务仍然由游戏服务掌控。
最终验收应同时检查两类结果:玩家看到的台词是否符合当前事实,以及游戏状态是否只发生被授权且可追踪的一次变更。只要两者来自同一次经过验证的请求,就能在模型生成与实际游戏规则之间保持明确的执行边界。