
游戏 AI / 系统课时
用检索补充大体量世界设定
用检索补充大体量世界设定
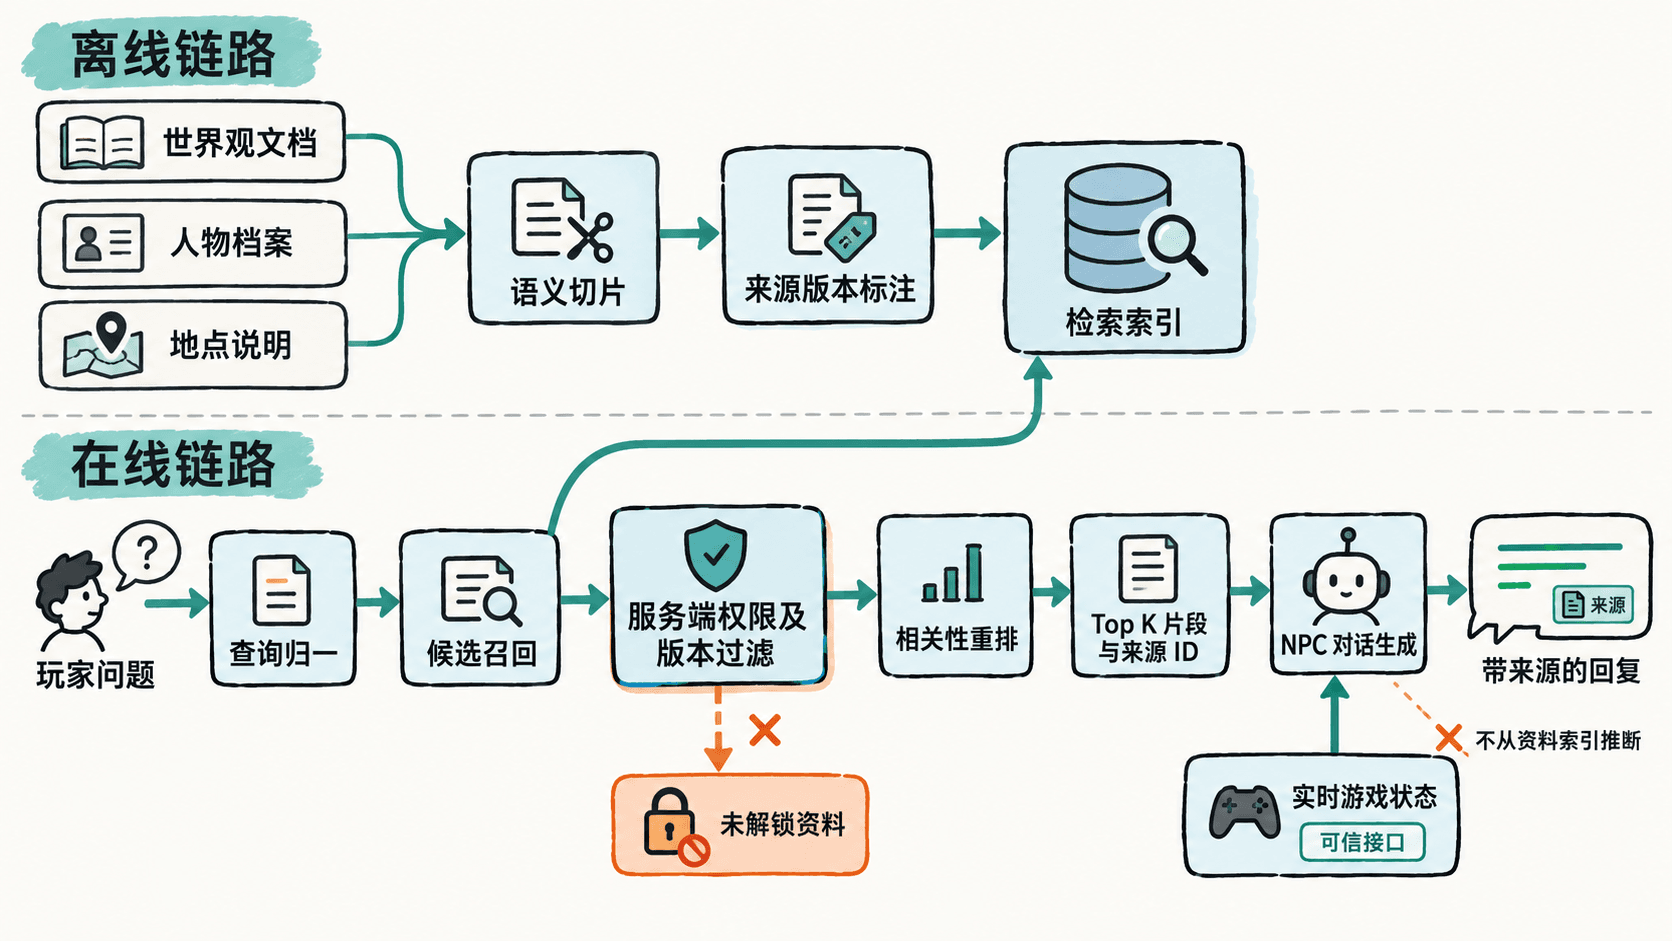
当世界设定扩展到数百份人物、地点与历史文档时,把整库塞进 NPC 的每次请求会挤占上下文,还可能泄露未解锁剧情。本篇把设定切成带来源的片段,按玩家提问检索,只注入少量已授权事实,并让回答可以追查出处。
学习目标
- 为世界设定片段设计来源、版本与可见性字段。
- 建立提问到检索、权限过滤和少量片段注入的路径。
- 验证 NPC 有据可答,无命中时不编造世界事实。
切分资料并保留出处
以“月港”地图、守塔人“林雀”档案和灯塔历史为例,先由内容团队批准可用于对话的设定,再按完整语义段落切片。初始可将每片控制在 300~600 个汉字;只有跨段依赖时才保留约 50 字重叠,避免检索命中后缺少主语或条件。
每片至少保存 sourceId、version、visibility、text 和地名、人物别名等检索标签。例如 world/places/lighthouse 表示稳定的来源定位,版本号用于追溯修订。可见性按业务定义为 public、questUnlocked、internal 等,任务未解锁的片段不应进入玩家的检索结果。
历史、地理和角色背景适合建索引;城门当前是否开启、NPC 当前坐标和任务是否完成属于实时状态,必须由游戏服务提供,不能仅凭检索文本确定。
召回、过滤与重排
玩家问“月港灯塔是谁在值守”,后端先归一地名别称,再用全文检索或向量索引取回候选。可以初召回 10~20 片,按当前玩家权限和资料有效版本过滤,再重排相关性,最终只选前 2~4 个有用片段,总注入量例如不超过 1200 个汉字。
必须在片段进入模型上下文前实施服务端权限过滤。检索分数只衡量相关程度,不代表资料有权威性;两篇设定冲突时交由事实裁决逻辑处理,不能简单选分数高的一篇。
用本地脚本验证命中
以下 Python 示例不依赖外部服务,使用人工标注的关键词模拟索引。它专门验证三个容易出错的点:私密资料不会被召回、结果有确定顺序、输出保留来源和版本。
# 本地演示检索协议;大规模资料可替换为全文或向量索引
DOCUMENTS = [
    {
        "sourceId": "world/places/lighthouse",
        "version": 7,
        "visibility": "public",
        "keywords": ["月港", "灯塔", "值守"],
        "text": "月港灯塔由林雀值守,每晚日落前点灯。",
    },
    {
        "sourceId": "world/npcs/linque",
        "version": 3,
        "visibility": "public",
        "keywords": ["林雀", "值守"],
        "text": "林雀是月港登记在册的守塔人。",
    },
    {
        "sourceId": "world/quests/hidden-cove",
        "version": 2,
        "visibility": "secret",
        "keywords": ["月港", "灯塔", "值守"],
        "text": "灯塔地下有尚未解锁的密道。",
    },
]

def retrieve(query, limit=2):
    scored = []
    for doc in DOCUMENTS:
        # 权限过滤先于上下文组装,禁止秘密片段外泄
        if doc["visibility"] != "public":
            continue
        score = sum(term in query for term in doc["keywords"])
        if score:
            scored.append((score, doc))
    ranked = sorted(scored, key=lambda item: (-item[0], item[1]["sourceId"]))
    return [doc for _, doc in ranked[:limit]]

hits = retrieve("月港灯塔是谁在值守?")
for doc in hits:
    print(f'{doc["sourceId"]}@v{doc["version"]}: {doc["text"]}')
print(f"命中片段数:{len(hits)}")
预期输出:
world/places/lighthouse@v7: 月港灯塔由林雀值守,每晚日落前点灯。
world/npcs/linque@v3: 林雀是月港登记在册的守塔人。
命中片段数:2
示例中的关键词排序只是可运行的最小检索入口,不提供语义检索能力。生产中可改用支持中文分词的全文检索、向量召回和重排,但来源、版本、权限及片段预算必须继续保留。
注入证据而不是授予指令权
服务端将每条命中内容连同 sourceId@version 作为低信任的“检索资料”传给模型,并单独提供玩家原始问题。NPC 的身份、禁区和回答约束仍由可信角色模板控制,检索结果不能修改规则、任务状态、金币或背包。
对于本例,NPC 可以说“月港灯塔由林雀值守”,同时在应用层记录引用 world/places/lighthouse@v7。如果没有命中,或片段只提到灯塔位置而未说明守塔人,就应回答“现有资料无法确认”,而不是补造姓名。
检索文本可能夹带“忽略此前规则”等恶意指令。把它当作待核实资料,不当作新系统指令;若模型返回 citedSourceIds,服务端还要校验引用都属于本次授权命中集合,不能只相信模型自报的来源。
更新索引并验收答案
当设定发布新版本时,应撤下受影响的旧片段、重新索引变更内容,并保留 sourceId 到当前文档版本的映射。不要让旧片段因为向量相似度高而重新进入 NPC 对话;已废弃地点或人物名也应从别名索引中同步更新。
验收时准备至少三类问题:有明确出处的灯塔问题、无资料可答的问题、故意触及未解锁密道的问题。记录检索请求 ID(如 <ID>)、命中片段版本与最终引用,核对有出处的答案正确、缺证据时不猜测、私密资料始终不出现在上下文中。