
游戏 AI / 系统课时
选择云端 API 与本地推理边界
选择云端 API 与本地推理边界
NPC 对话在开发机上跑通后,真正影响上线体验的是网络延迟、并发费用、设备算力和数据边界。这里把“本地推理”拆成私有服务器推理与玩家设备推理,比较三种部署位置,并用一段可运行的路由策略确定每种情形的接入方式。
学习目标
- 区分云端 API、自托管服务器与端侧推理的适用边界。
- 明确客户端、中转服务和推理后端的安全职责。
- 用可执行的选路示例验证正常调用与故障降级。
区分三种模型部署位置
| 方案 | 推理发生地 | 适用条件 | 主要代价 |
|---|---|---|---|
| 云端 API | 外部模型服务 | 快速验证、流量波动、可联网 | 按量费用、外网依赖、数据传输要求 |
| 自托管推理 | 开发者管理的 GPU 服务器 | 可控数据边界、稳定负载、定制模型 | 显存、容量规划、运维和升级 |
| 端侧推理 | 玩家电脑或移动设备 | 非关键离线闲聊、端侧硬件充足 | 安装体积、机型差异、性能与质量波动 |
“自托管”不一定离线;玩家通常仍需通过网络访问游戏服务器。“端侧”也不等于可信:即使模型运行在玩家设备上,金币、背包、任务完成等状态仍必须由权威游戏服务判定。
开发阶段通常先通过服务端中转调用云端模型,以便快速更换模型并记录指标;上线是否迁往自托管或端侧,应由目标机型和真实流量测试决定,而不是只看一次对话的主观效果。
固定客户端与模型之间的安全边界
联网游戏推荐让客户端只调用游戏后端的 NPC 对话接口。后端验证玩家身份、读取允许暴露的世界状态、裁剪提示内容、选择模型后端,并校验生成结果。云端 API 密钥保存在服务器的密钥管理或环境变量中,不打包到客户端。
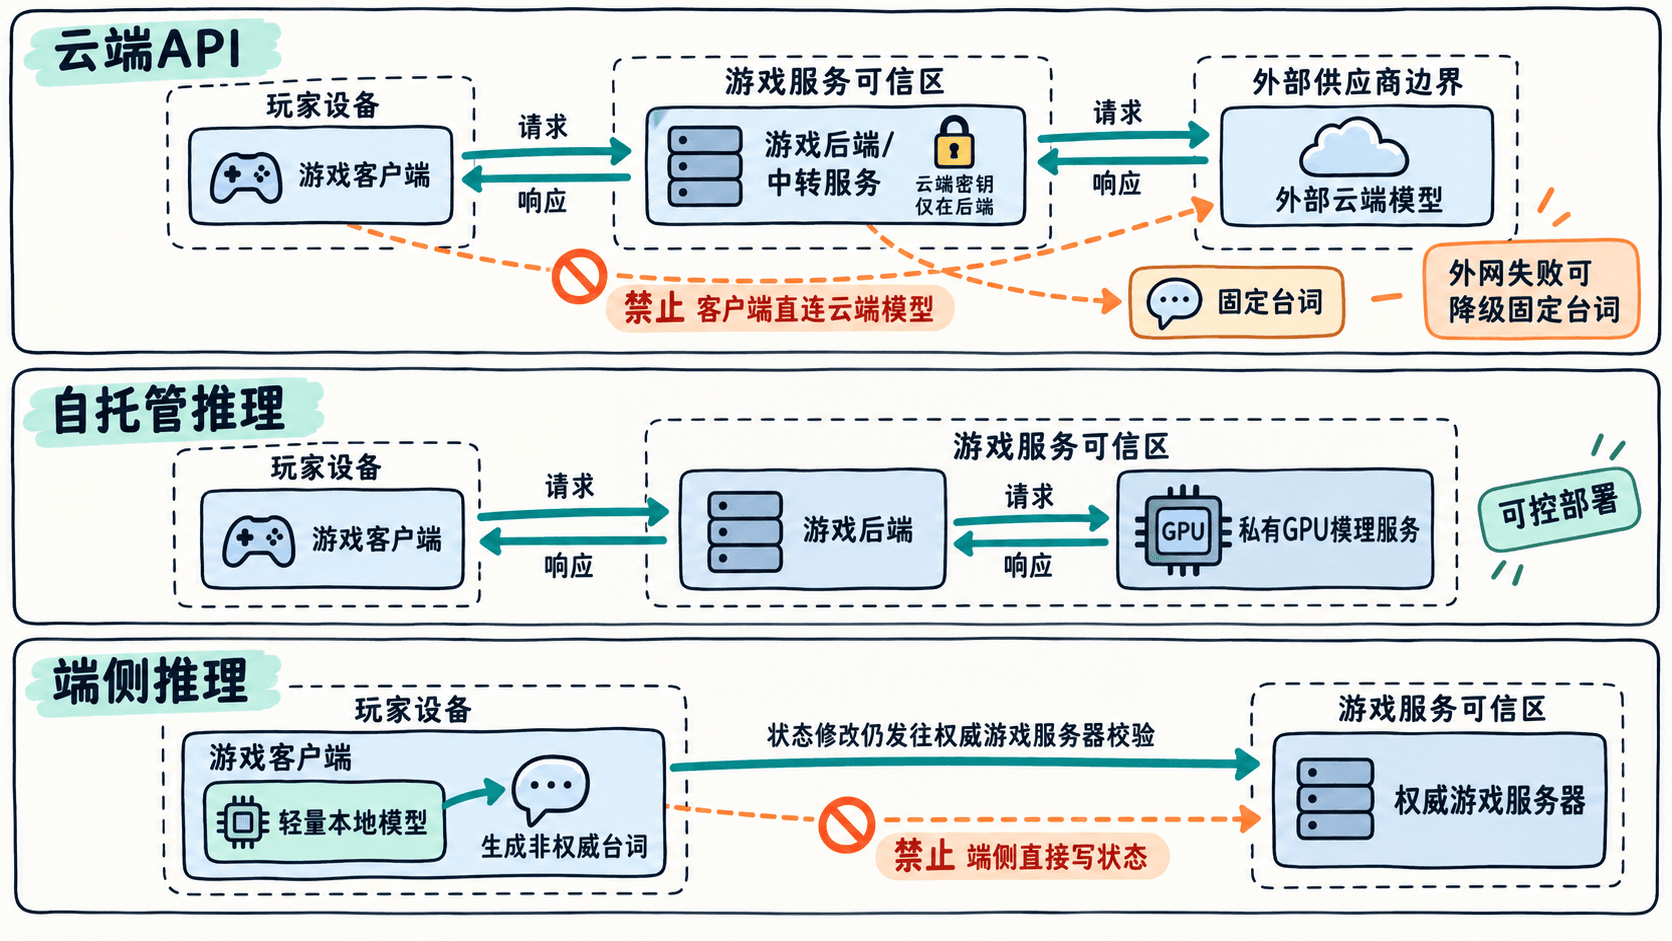
中转层还需要限流、超时、取消请求、日志脱敏与失败兜底。不要把完整聊天记录和所有任务变量默认发送给模型;例如问路只需当前地点、可公开的目的地名称和 NPC 知识范围。敏感信息是否能送往外部服务,应先按项目的数据政策决定。
用流量和响应预算筛选方案
假设游戏每天产生 2000 次 NPC 请求,平均每次输入 600 Token、输出 150 Token,按 30 天计算就是约 60000 次请求、3600 万输入 Token 和 900 万输出 Token。云端费用需要分别乘以供应商实际的输入、输出单价;自托管则要估算 GPU 占用、峰值排队、运维和冗余成本,不能只比较单次生成价格。
为游戏内短对话可先设置一组可测试的验收门槛:20 路并发时完整回复的 P95 不超过 3 秒,单次请求 4 秒超时,超时后使用固定 NPC 文案。这些是项目示例目标,不是模型厂商保证值;应按地区、终端硬件和实际场景重测。
若剧情数据禁止外传,就优先评估私有推理;若玩家必须离线,评估端侧模型的包体、内存与低端设备表现;若用户峰值波动大且可联网,云端更便于先验证需求。
用统一路由策略避免前端绑死后端
以下完整 Python 示例只演示游戏后端的选路决策,不伪造任何模型供应商 API 调用。四种输出分别代表云端、自托管、端侧和固定模板;端侧只用于不影响权威状态的闲聊。
from dataclasses import dataclass

@dataclass(frozen=True)
class Context:
    cloud_ok: bool
    private_server_ok: bool
    device_model_ok: bool
    external_allowed: bool
    cosmetic_only: bool

def select_backend(ctx: Context) -> str:
    # 端侧仅用于不会触发道具、金币或任务变化的闲聊。
    if ctx.cosmetic_only and ctx.device_model_ok:
        return "on_device"
    if ctx.private_server_ok:
        return "self_hosted"
    # 外发许可与云端可达必须同时满足。
    if ctx.external_allowed and ctx.cloud_ok:
        return "cloud_api"
    return "template"

cases = {
    "开发联调": Context(True, False, False, True, False),
    "敏感剧情": Context(True, True, False, False, False),
    "离线闲聊": Context(False, False, True, False, True),
    "全部不可用": Context(False, False, False, False, False),
}
for name, context in cases.items():
    print(f"{name}: {select_backend(context)}")
预期输出:
开发联调: cloud_api
敏感剧情: self_hosted
离线闲聊: on_device
全部不可用: template
cloud_ok 等条件应来自实际健康检查和项目策略,而非由客户端自由声明。真正接入时,四种分支要实现同一请求与响应契约,使游戏逻辑不感知供应商差异;模型输出的动作意图仍需统一经过规则校验。
用故障演练决定上线边界
分别测量首字延迟、完整响应 P50/P95、超时率、Token 消耗、峰值排队时间和不同设备的内存峰值。对于自托管,还应压测 GPU 并发与模型加载;对于端侧,要覆盖最低支持机型;对于云端,要模拟限流和外网断开。
最后验收一条硬规则:任意模型不可用时 NPC 可以返回保底台词,但不能凭失败、重试或端侧生成结果直接修改玩家状态。这样开发期能保持接入简单,上线时也能依据真实负载调整部署,而不必重写游戏规则。