
游戏 AI / 系统课时
设定首字和完整回复延迟预算
设定首字和完整回复延迟预算
玩家与 NPC 交谈时,首字迟迟不出现会被认为“没响应”,而回复开始后迟迟不结束又会阻塞后续操作。只统计接口总耗时无法定位问题。本课把一次请求拆成可观测阶段,为不同对话场景设定预算,再用分位数检查实际体验。
学习目标
- 区分后端排队、首字到达、完整回复和 UI 展示时间。
- 使用 P50、P95 为闲聊与任务对话验收延迟预算。
- 根据超时所在阶段选择降级与取消策略。
把请求拆成可测量的时间段
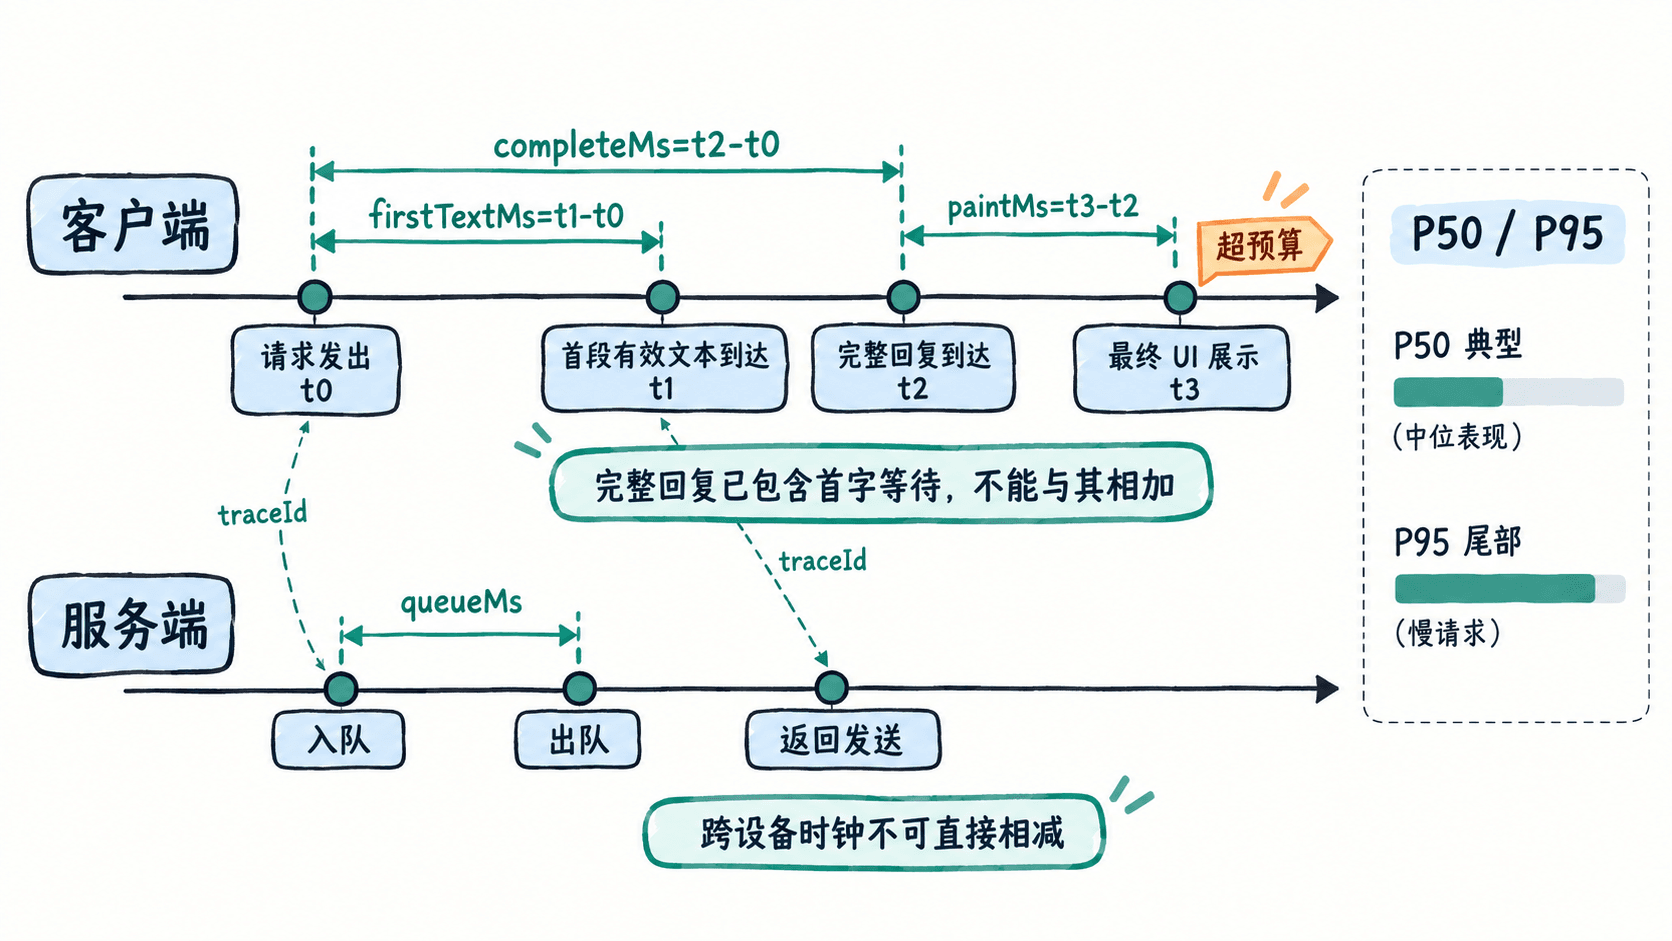
每轮分配唯一的 traceId。客户端用单调时钟记录发送请求、收到首段非空文本、收到完成事件、最终文本展示;后端另外记录入队与出队。首字只认可展示的文本增量,不把连接成功、空事件或工具调用当成 NPC 开口。
queueMs:服务端出队时间减入队时间,衡量排队。firstTextMs:客户端发起请求到收到首段有效文本的时间,包括网络、排队及模型处理。completeMs:客户端发起请求到接收完整回复的时间;首字后的传输与生成耗时可近似写为completeMs - firstTextMs。paintMs:客户端接收完成事件到最终文本完成画面提交的时间;总完成体验约为completeMs + paintMs。
这些差值必须各自在同一时钟域内计算。不能把服务端时间戳直接减去客户端时间戳;通过 traceId 合并两端统计即可。还应单独埋点首字实际可见的时间,避免流已经到达但 UI 未刷新。
为不同交互场景设预算
下面是可用于原型验收的示例目标,并非服务商保证。应在真实设备、目标网络和实际请求长度下测量后调整。
| 场景 | 首字 P95 | 完整回复 P95 | 触发兜底 |
|---|---|---|---|
| 路过闲聊 | ≤1000 ms | ≤3200 ms | 2 秒无字提示正在回应;5 秒未完成则取消并显示预设台词 |
| 任务关键对话 | ≤1800 ms | ≤6000 ms | 3 秒无字显示等待;8 秒未完成则取消并提供重试入口 |
客户端 UI 的最终展示阶段可先设 P95 ≤80 ms(闲聊)或 ≤100 ms(任务)。P95 表示至少约 95% 的样本不超过该值,不能代替单次硬超时。首字、完整回复分别计目标;若整个响应不支持流式输出,首字时间通常会接近完整回复时间,必须按非流式场景另设预期。
任务状态和奖励仍由游戏服务端决定。超时取消时要失效当前请求标识,阻止迟到结果覆盖新一轮台词;已展示部分文字的请求,不应直接自动重试并把两次内容拼在一起。
用请求样本计算 P95
下例使用 20 条固定演示记录:queue 来自服务端独立计时,其余三个字段由客户端分别测得,单位均为毫秒。程序采用最近秩法计算 P50、P95,并对照闲聊目标。
from math import ceil

samples = [
    {"queue": 20 + 5 * i, "first": 300 + 50 * i,
     "complete": 1000 + 110 * i, "paint": 20 + 2 * i}
    for i in range(20)
]
budgets = {"queue": 150, "first": 1000, "complete": 3200, "paint": 80}
labels = {"queue": "服务端排队", "first": "首字到达",
          "complete": "完整回复", "paint": "UI 展示"}

def percentile(values, percentage):
    values = sorted(values)
    # 最近秩法:P95 在 20 条样本中取第 19 个数
    index = ceil(len(values) * percentage / 100) - 1
    return values[index]

for field, limit in budgets.items():
    values = [item[field] for item in samples]
    p50, p95 = percentile(values, 50), percentile(values, 95)
    result = "达标" if p95 <= limit else "超标"
    print(f"{labels[field]} P50={p50}ms P95={p95}ms / 预算={limit}ms:{result}")
预期输出:
服务端排队 P50=65ms P95=110ms / 预算=150ms:达标
首字到达 P50=750ms P95=1200ms / 预算=1000ms:超标
完整回复 P50=1990ms P95=2980ms / 预算=3200ms:达标
UI 展示 P50=38ms P95=56ms / 预算=80ms:达标
这里的数值由公式生成,只用于验证计算,不代表线上性能。正式验收应持续收集足够多的请求,按场景、设备、网络和模型版本分别统计,并同时报告超时率、错误率与取消率,避免只计算成功请求造成偏差。
根据超标阶段修复问题
- 排队 P95 升高:检查并发限制、请求积压和优先级;优先为近距离交互 NPC 留出容量,而不是无限重试。
- 首字慢但尾段正常:检查过长的输入上下文、检索等待、连接建立及模型首段生成;确认客户端确实在收到文本增量时刷新。
- 首字快但完整回复慢:限制可说的台词长度与输出 Token 预算,减少重复叙述;结构化回复应完整校验后再用于游戏动作,不可截断半份 JSON 当成功结果。
- 后端正常而 UI 慢:检查主线程布局、逐字动画和频繁重排,考虑按 30~60 ms 的间隔合并文本刷新,同时保证首段及时呈现。
线上日志只需关联 traceId、场景、阶段耗时、Token 用量与错误类别,避免记录玩家隐私或完整提示内容。若只对完整回复设超时,玩家可能长时间面对空白对话框;因此每轮至少要同时检查首字预算与完整回复预算。