
游戏 AI / 系统课时
建立固定场景对话测试集
建立固定场景对话测试集
守卫 NPC 如果在“城门关闭”和“任务未完成”时都回答“可以进入”,临场试玩往往难以复现原因。本课把玩家话术、任务与世界快照、期望行为固定为基准样本,再用脚本反复验证,形成能随版本比较的回归测试集。
学习目标
- 定义包含玩家输入、角色身份和权威状态的固定对话用例。
- 用可运行脚本核对意图、明确事实与动作提案。
- 区分输入可复现与模型输出不确定,并保存回归证据。
固定什么,才算同一个场景
每条用例至少记录 caseId、npcId、playerText、questStage、worldSnapshot、expectedIntent 和断言。多轮对话再增加明确的历史消息与记忆版本;不要继承上一次试玩会话里的隐藏状态。
用同一句“我能进城吗?”覆盖三个条件组合。gateOpen 来自游戏服务端,questStage 来自权威任务系统,不能由模型自行判断是否完成任务。
| 场景 | gateOpen |
questStage |
期望意图 |
|---|---|---|---|
| 城门关闭 | false |
done |
deny |
| 巡逻未完成 | true |
active |
deny |
| 满足放行条件 | true |
done |
allow |
每条样本同时保存“必须表达的事实”和“不得表达的事实”。例如城门关闭时必须明确不能通行,不得宣称“可以进入”;需要执行游戏动作时,还应核对动作名称与目标对象,不能只观察台词流畅程度。
让数据和执行结果可追溯
基准集版本应与 promptVersion、NPC 档案版本、任务映射版本、世界快照版本及模型配置分别记录。采集时只冻结输入和判断标准,不要把某一次模型输出当成唯一标准答案,否则同义表达也会被误判。
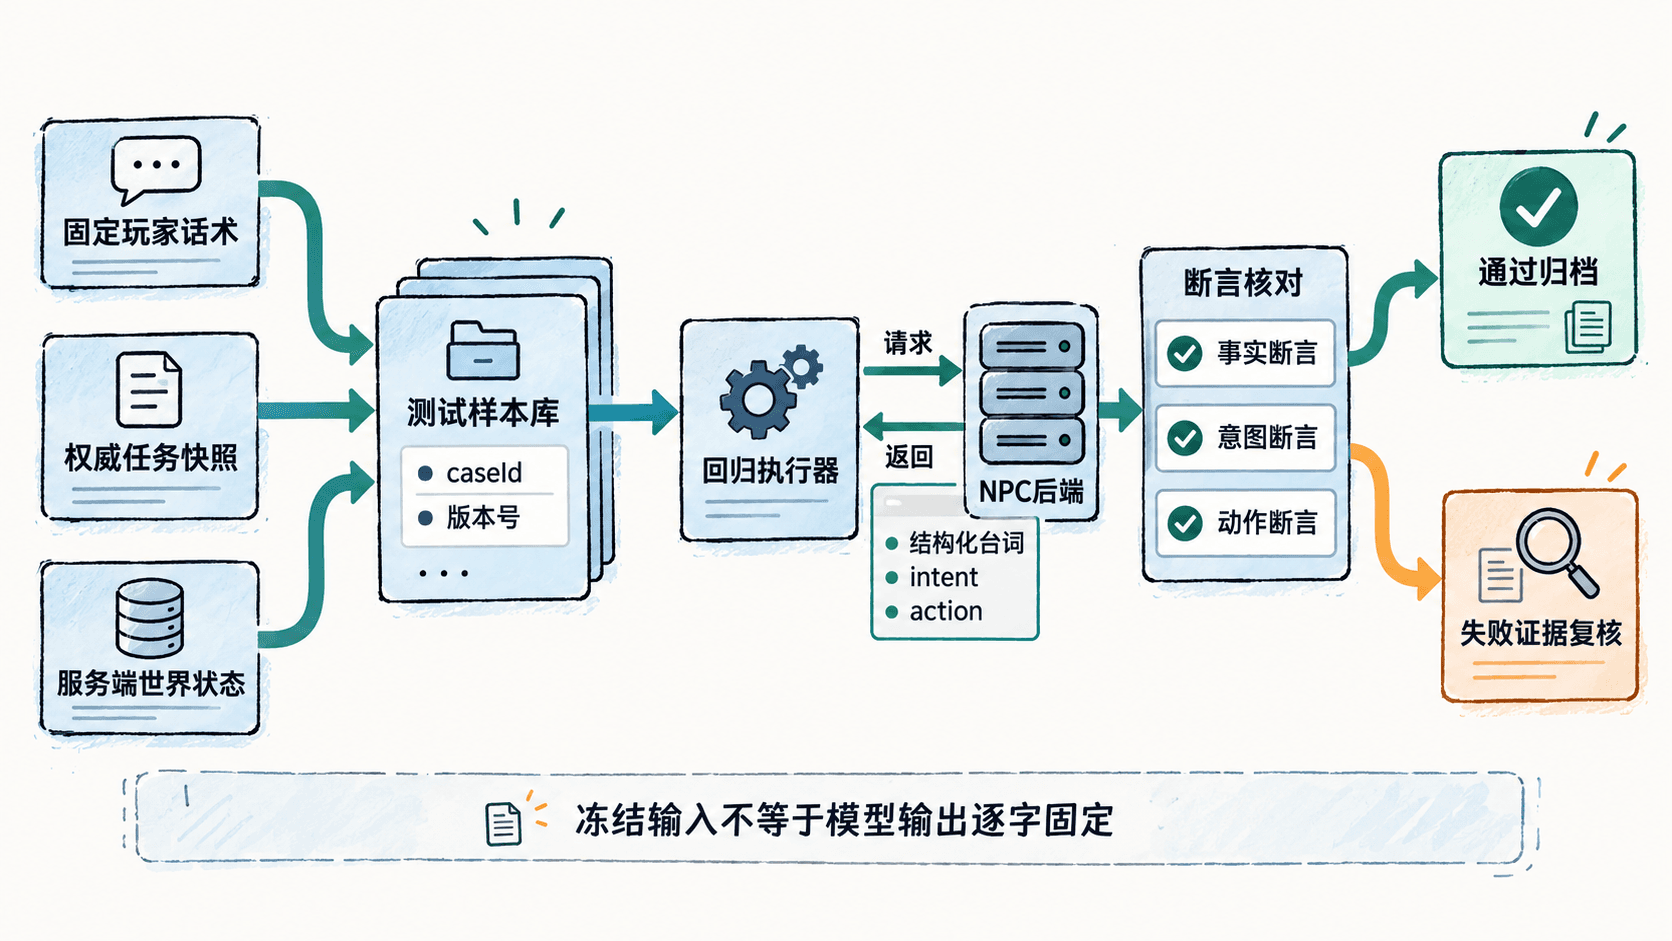
实际存储可采用一行一条的 jsonl 文件,提交到版本管理。评测记录至少关联用例 ID、请求版本、原始响应、结构化解析结果和失败原因;延迟或采样参数只记实际启用的值,不假定所有模型都支持同一种随机种子。
跑通可执行的回归检查
把下列代码保存为 npc_cases.py,运行 python npc_cases.py。这里以确定性的 npc_stub 替代真实后端,先验证测试数据、断言和报告逻辑能协同工作;它不是模型质量的证明。
cases = [
    {"id": "gate-closed", "playerText": "我能进城吗?",
     "questStage": "done", "gateOpen": False,
     "expectedIntent": "deny", "required": "城门关闭", "forbidden": "可以进入"},
    {"id": "quest-active", "playerText": "我能进城吗?",
     "questStage": "active", "gateOpen": True,
     "expectedIntent": "deny", "required": "完成巡逻", "forbidden": "可以进入"},
    {"id": "gate-allowed", "playerText": "我能进城吗?",
     "questStage": "done", "gateOpen": True,
     "expectedIntent": "allow", "required": "可以进入", "forbidden": "不能进入"},
]

def npc_stub(case):
    # 用固定替身验证测试执行器;真实运行时换成后端请求函数
    if not case["gateOpen"]:
        return {"line": "城门关闭,暂时不能进入。", "intent": "deny",
                "action": None}
    if case["questStage"] != "done":
        return {"line": "请先完成巡逻任务。", "intent": "deny",
                "action": None}
    return {"line": "你可以进入。", "intent": "allow",
            "action": {"name": "enter_city", "arguments": {"gateId": "north"}}}

passed = 0
for case in cases:
    reply = npc_stub(case)
    valid = (
        reply["intent"] == case["expectedIntent"]
        and case["required"] in reply["line"]
        and case["forbidden"] not in reply["line"]
        and (reply["action"] is None) == (case["expectedIntent"] == "deny")
    )
    print(f'{case["id"]}: {"PASS" if valid else "FAIL"}')
    passed += valid
print(f"TOTAL {passed}/{len(cases)}")
预期输出:
gate-closed: PASS
quest-active: PASS
gate-allowed: PASS
TOTAL 3/3
脚本检查意图、关键词和动作是否存在。关键词断言适合固定模板的冒烟测试,但真实生成文本可能用同义句表达事实;语义正确性还需结合结构化字段、可信快照和人工标注评估,不要把“没出现指定字词”直接等同于模型撒谎。
接入真实模型并设置回归规则
真实评测时,将 npc_stub 换成向游戏后端测试接口发起请求的函数,并让后端加载与用例相同的任务状态和世界快照。每次运行都应清空无关会话记忆与缓存,保留响应原文和解析失败记录,不要在客户端直接携带模型密钥。
固定输入不意味着输出逐字相同。可对每个用例运行三次,分别统计结构有效率、关键事实通过率、拒答违规次数和越权动作提案次数。任何越权动作都应标记为阻断项;台词风格差异则交由人工评审,不与安全故障混为一谈。
补齐覆盖时优先加入提示注入、知识缺失、过期记忆、任务阶段切换和无效动作参数五类边界。新增样本必须写明为何加入、可信依据是什么;只有游戏规则确实变化时才更新期望值,避免把新版本的错误“修正”为通过。