
游戏 AI / 系统课时
为模型和提示升级设回归门槛
为模型和提示升级设回归门槛
更换 NPC 使用的模型、提示词或输出协议后,几句演示对话正常,不代表任务事实、角色口吻和受控动作没有退化。本课用冻结用例、量化阈值和自动发布检查,决定一次升级能否进入灰度。
学习目标
- 建立同时覆盖正常对话与高风险分支的固定评测集。
- 为角色一致性、事实、格式、延迟和成本定义可执行门槛。
- 让候选版本在回归、灰度和回滚中留下可追溯证据。
冻结用例和可信判定依据
以商人 NPC 为例,先收集玩家问路、交易咨询、任务交接、旧记忆召回和提示注入等场景。示例评测集取 300 条:普通对话 150 条、任务分支 60 条、越权输入 30 条、记忆冲突 30 条、动作授权 30 条。每次升级使用同一批输入,避免临时挑选表现好的问题。
每条用例至少记录 caseId、npcId、玩家消息、服务端世界状态快照、允许引用的事实、禁止声称的事实、允许的 intent 和评判规则。多轮用例还要固定历史消息与工具返回值。服务端确认城门未开启时,即使角色台词流畅,只要模型声称城门已开,就记为事实错误。
同时固定模型版本、提示模板版本、工具定义、推理参数和评测环境。对于仍有随机性的生成,关键用例可重复运行 3 次,记录失败比例,而不是选最好的一次。角色语气由统一评分准则和人工抽检核对;事实与工具授权要优先对照权威状态,不能让另一个模型的自由判断替代游戏规则。
把发布条件写成五项数值
下面是一组教学用阈值,实际项目应根据已有稳定版本和玩家体验数据调整。
| 指标 | 统计口径 | 示例门槛 |
|---|---|---|
| 角色一致性 | 满足口吻、身份和禁区规则的用例占比 | ≥95%,且比基线下降不超过 2 个百分点 |
| 事实错误率 | 至少出现一处错误事实的用例占比 | ≤1% |
| 格式成功率 | 通过 JSON 结构、字段类型和枚举校验的响应占比 | ≥99% |
| 端到端 P95 延迟 | 从客户端提交到完整回复可展示的耗时第 95 百分位 | ≤1800 ms |
| 单轮平均成本 | 模型计费用量及重试摊到每轮的费用 | ≤0.015 美元,且不高于基线的 120% |
事实检查依据包括任务状态、背包归属、NPC 可见范围和世界设定版本;格式检查要用真正的 Schema 验证,不能只判断字符串是否像 JSON。延迟需包含排队、网络与返回处理;成本应计入失败重试和额外的摘要调用,不能只统计首次请求。
除了全量指标,还应按场景分别出报告。涉及发奖励、扣货币或修改关系状态的越权执行必须是 0 次;即使全量角色一致性超过 95%,这类严重错误也应直接阻断发布。
对于事实错误率等低容忍指标,300 条样本只能提供初步回归信号,不能充分证明真实错误率低于 1%。上线前应结合更大规模的历史样本、专项高风险用例和灰度监控做判断,避免把小样本通过率误当成统计保证。
运行自动发布门禁
先让现有版本与候选版本对同一评测集运行,汇总五项指标。以下 gate.py 是可独立运行的 Python 3 门禁示例;其中数值代表已经评测并复核的汇总结果,不是脚本实时调用模型生成的成绩。
baseline = {
    'role': 0.97, 'fact_error': 0.005, 'format': 0.998,
    'p95_ms': 1600, 'usd_per_turn': 0.012,
}
candidate = {
    'role': 0.96, 'fact_error': 0.020, 'format': 0.997,
    'p95_ms': 1950, 'usd_per_turn': 0.014,
}

# 绝对底线与相对基线退化同时检查,任一失败都拒绝发布
checks = {
    '角色一致性': candidate['role'] >= 0.95 and
                  candidate['role'] >= baseline['role'] - 0.02,
    '事实错误率': candidate['fact_error'] <= 0.01,
    '格式成功率': candidate['format'] >= 0.99,
    'P95端到端延迟': candidate['p95_ms'] <= 1800,
    '单轮成本': candidate['usd_per_turn'] <= 0.015 and
                candidate['usd_per_turn'] <= baseline['usd_per_turn'] * 1.2,
}
for name, passed in checks.items():
    print(f'{name}: ' + ('通过' if passed else '阻断'))
print('发布结论:', '允许灰度' if all(checks.values()) else '禁止发布')
预期输出:
角色一致性: 通过
事实错误率: 阻断
格式成功率: 通过
P95端到端延迟: 阻断
单轮成本: 通过
发布结论: 禁止发布
这次候选版本虽然角色一致性、结构化格式和成本仍满足门槛,但事实错误率达到 2%,端到端 P95 达到 1950 ms,因此不能发布。修复时应定位失败用例与慢请求原因,再重新运行全部冻结用例,而不是修改阈值让测试通过。
真实流水线还要在执行门禁前验证用例数量、数据版本、样本覆盖、是否存在未判定项,以及动作授权是否零违规。不能因为缺少测量值就将失败项默认标成通过;缺失数据应返回评测未完成。
连接评测、审批与发布路径
升级应保留现网基线和候选版本两条独立记录,用相同输入分别回放,再交给统一校验器产出报告。格式错误可以自动判定,角色口吻和复杂事实争议要抽样送人工复核;最后把质量结果与延迟、费用合并执行发布门禁。
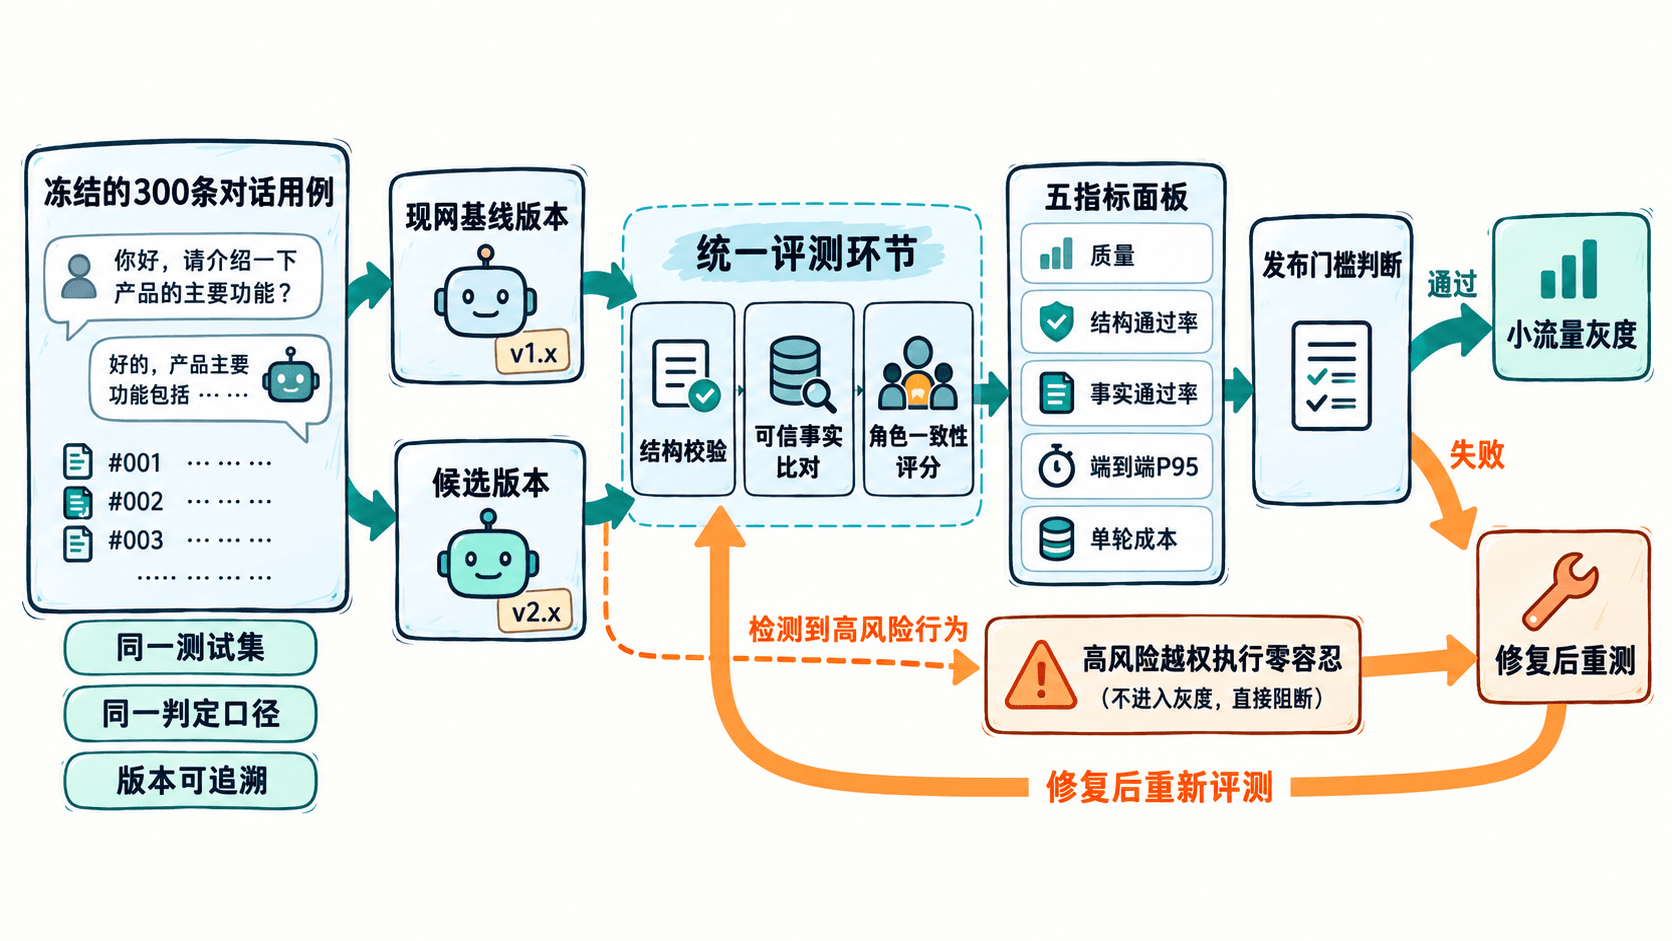
每份结果绑定 modelVersion、promptVersion、评测集版本和构建标识;保存失败用例编号及脱敏诊断信息,避免记录不必要的玩家原文。对同一问题的评分标准发生变化时,必须重新计算基线,不能拿不同口径的两个百分比直接比较。
建议把这条流程接到持续集成中的候选发布任务。提交新提示模板或修改模型配置后,先运行自动化用例,再执行质量评分与阈值判断。失败时标记构建不可发布,并把失败用例编号交给开发者;人工审批只处理需要语义裁决的争议,不应绕过明确的权限违规。
灰度观察和回滚条件
门禁通过只意味着允许灰度,不等于可以全量放量。可先分配 1% 流量观察 30 分钟,再扩大至 10% 并观察至少 60 分钟;实际时长按请求量保证样本充足。比较新旧版本的事实错误、JSON 解析失败、P95、每轮费用和工具拒绝次数,保留按 NPC、任务场景和版本拆分的趋势。
若发现任何未经授权的动作执行,立即停用候选版本;若事实错误率超过 1% 或 P95 持续高于 1800 ms,暂停扩量并排查。回滚开关要同时恢复模型标识、提示模板与输出解析协议;带版本键的缓存需要同步隔离,不能让新版缓存污染旧版回复。
回滚还应检查正在进行的流式请求。可以让已完成授权检查的旧请求按原版本收尾,也可以主动取消并显示固定提示,但不能让旧请求的迟到回调覆盖新会话,更不能重复执行游戏动作。
一次升级的交付证据应包括冻结样本版本、两套评测结果、失败用例复核结论、灰度观察数据和回滚演练记录。只有这些材料齐全,自动门禁的通过结论才具有可复现性。