
操作系统 / 系统课时
为 TCP 字节流设计消息边界
为 TCP 字节流设计消息边界
TCP 只保证按序传递字节,不保留应用层一次 send 对应一次 recv 的边界。本节用 4 字节长度前缀定义消息帧,并实现增量缓冲解析器,让任意分片、粘连和连续多消息都能被稳定还原。
学习目标
- 解释为什么半包和粘包不是 TCP 异常,而是字节流语义的正常结果
- 设计带长度前缀的消息帧,并处理长度合法性与缓冲上限
- 实现可重复调用的增量解析器,在任意
recv分片下恢复完整消息
TCP 为什么不能按 recv 次数分消息
发送端连续调用两次 send,接收端可能一次 recv 就拿到两条消息,也可能先拿到半条,再在后续调用中补齐。TCP 只维护一条有序字节流,分段、聚合和每次读取到多少字节都受发送缓冲、MSS、拥塞、调度和接收缓冲影响。
因此,应用层不能把“本次 recv 返回的字节数”当成消息长度。正确做法是把消息边界编码进字节流,再让接收端维护跨多次读取的解析状态。
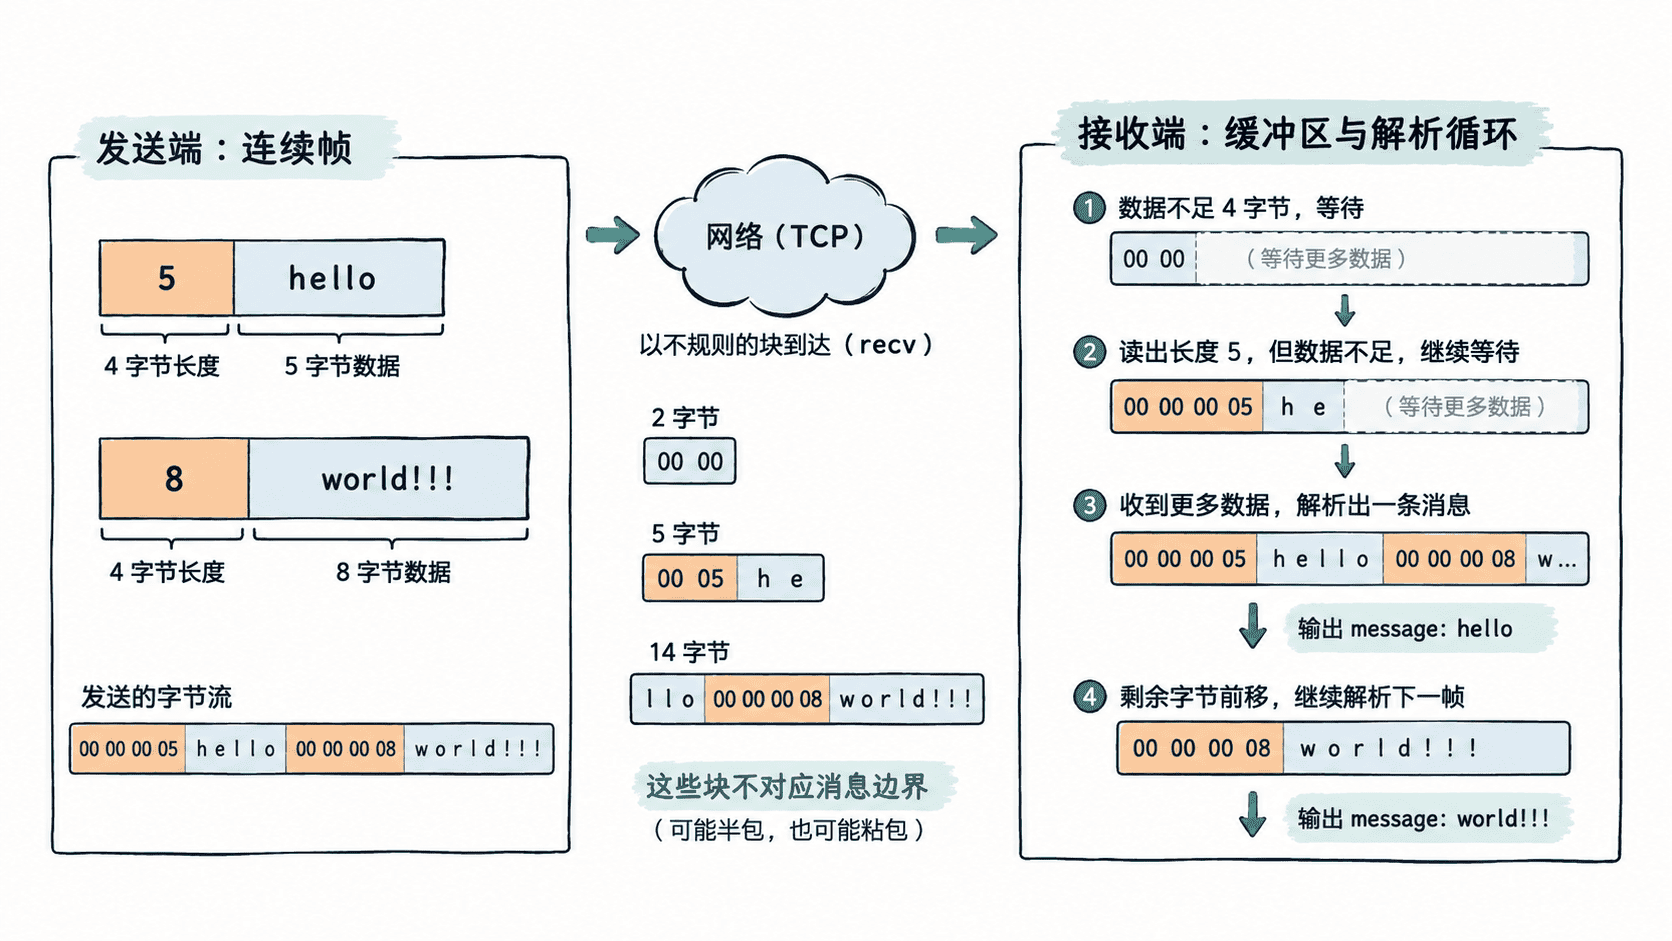
用长度前缀定义帧
一种常见格式是“4 字节无符号长度 + payload”。长度字段只描述 payload 字节数,并统一使用网络字节序。接收端先等待至少 4 字节,解析长度后再等待完整 payload;一旦完整,就交付一条消息,并继续检查缓冲区中是否还有下一帧。
协议必须同时规定最大 payload。否则攻击者只需发送一个极大的长度值,就可能诱导服务端申请巨量内存或长期等待永远不会到齐的数据。本例把最大消息限制为 1024 字节,实际服务应按业务上限配置。
实现增量缓冲解析器
下面的完整 C 程序先编码两条长度前缀消息,再故意按 2、5、14 字节喂给解析器。前两个块无法组成完整消息,最后一个块同时补齐第一条并携带第二条,正好覆盖半包与粘包场景。
#include <arpa/inet.h>
#include <stdint.h>
#include <stdio.h>
#include <string.h>

#define MAX_PAYLOAD 1024
#define BUF_CAP 4096

struct parser {
    unsigned char data[BUF_CAP];
    size_t used;
};

static int feed(struct parser *p, const unsigned char *chunk, size_t n) {
    if (p->used + n > BUF_CAP) {
        return -1;
    }

    memcpy(p->data + p->used, chunk, n);
    p->used += n;

    for (;;) {
        if (p->used < sizeof(uint32_t)) {
            return 0;
        }

        uint32_t net_len;
        memcpy(&net_len, p->data, sizeof(net_len));
        uint32_t payload_len = ntohl(net_len);
        if (payload_len > MAX_PAYLOAD) {
            return -2;
        }

        size_t frame_len = sizeof(uint32_t) + payload_len;
        if (p->used < frame_len) {
            return 0;
        }

        printf("message(len=%u): %.*s\n",
               (unsigned)payload_len,
               (int)payload_len,
               (char *)(p->data + sizeof(uint32_t)));

        memmove(p->data, p->data + frame_len, p->used - frame_len);
        p->used -= frame_len;
    }
}

static size_t append_frame(unsigned char *dst, const char *text) {
    uint32_t len = (uint32_t)strlen(text);
    uint32_t net_len = htonl(len);
    memcpy(dst, &net_len, sizeof(net_len));
    memcpy(dst + sizeof(net_len), text, len);
    return sizeof(net_len) + len;
}

int main(void) {
    unsigned char stream[64];
    size_t total = 0;
    total += append_frame(stream + total, "hello");
    total += append_frame(stream + total, "world!!!");

    const size_t chunks[] = {2, 5, 14};
    struct parser p = {0};
    size_t offset = 0;

    for (size_t i = 0; i < sizeof(chunks) / sizeof(chunks[0]); ++i) {
        size_t n = chunks[i];
        printf("feed %zu bytes\n", n);
        if (feed(&p, stream + offset, n) != 0) {
            fprintf(stderr, "parse error\n");
            return 1;
        }
        offset += n;
    }

    return offset == total && p.used == 0 ? 0 : 1;
}
预期输出
feed 2 bytes
feed 5 bytes
feed 14 bytes
message(len=5): hello
message(len=8): world!!!
把解析器接到真实 recv 循环
真实连接中,每次 recv 返回后只做两件事:把新字节追加到连接自己的缓冲区,然后反复尝试解析完整帧。解析器必须允许一次调用产出零条、一条或多条消息;零条表示数据还不完整,不是错误。
连接级缓冲区不能跨连接共享,因为每条 TCP 连接都有独立的字节序列和解析进度。非阻塞服务器还应在读到 EAGAIN 或 EWOULDBLOCK 后停止本轮读取,保留未完成帧,等待下一次可读事件再继续。
只要消息边界由应用协议明确编码,半包、粘包和一次到达多条消息就都变成同一个增量解析问题,而不需要猜测一次 recv 应该对应多少次 send。