
操作系统 / 系统课时
调整收发缓冲与流量窗口
调整收发缓冲与流量窗口
把 SO_SNDBUF、SO_RCVBUF 调大,可能减少短时突发造成的阻塞,也可能只是把数据积压得更深。本节通过一个慢消费者实验区分本地 socket 缓冲、对端接收窗口与拥塞窗口,并建立“先测量,再调参”的判断顺序。
学习目标
- 区分
SO_SNDBUF、SO_RCVBUF、接收窗口rwnd与拥塞窗口cwnd。 - 用慢消费者实验观察发送端出现
EAGAIN的过程。 - 判断何时应该增大缓冲,何时应该修复消费能力或背压。
缓冲区和流量窗口不是同一件事
SO_SNDBUF 是本机为 socket 发送数据准备的内存预算,应用写得比内核和网络发送得快时,数据会先排在这里。SO_RCVBUF 是接收侧内核暂存尚未被应用读取的数据空间。它们都属于端系统资源,不等同于 TCP 在网络上的“允许飞行字节数”。
TCP 接收方会通过 rwnd 告诉对端自己还能接收多少数据;发送方同时还受拥塞控制的 cwnd 约束。粗略看,未确认数据的上限受到 min(rwnd, cwnd) 限制,但实际发送还会受 MSS、已在途数据、内核调度和队列状态影响。
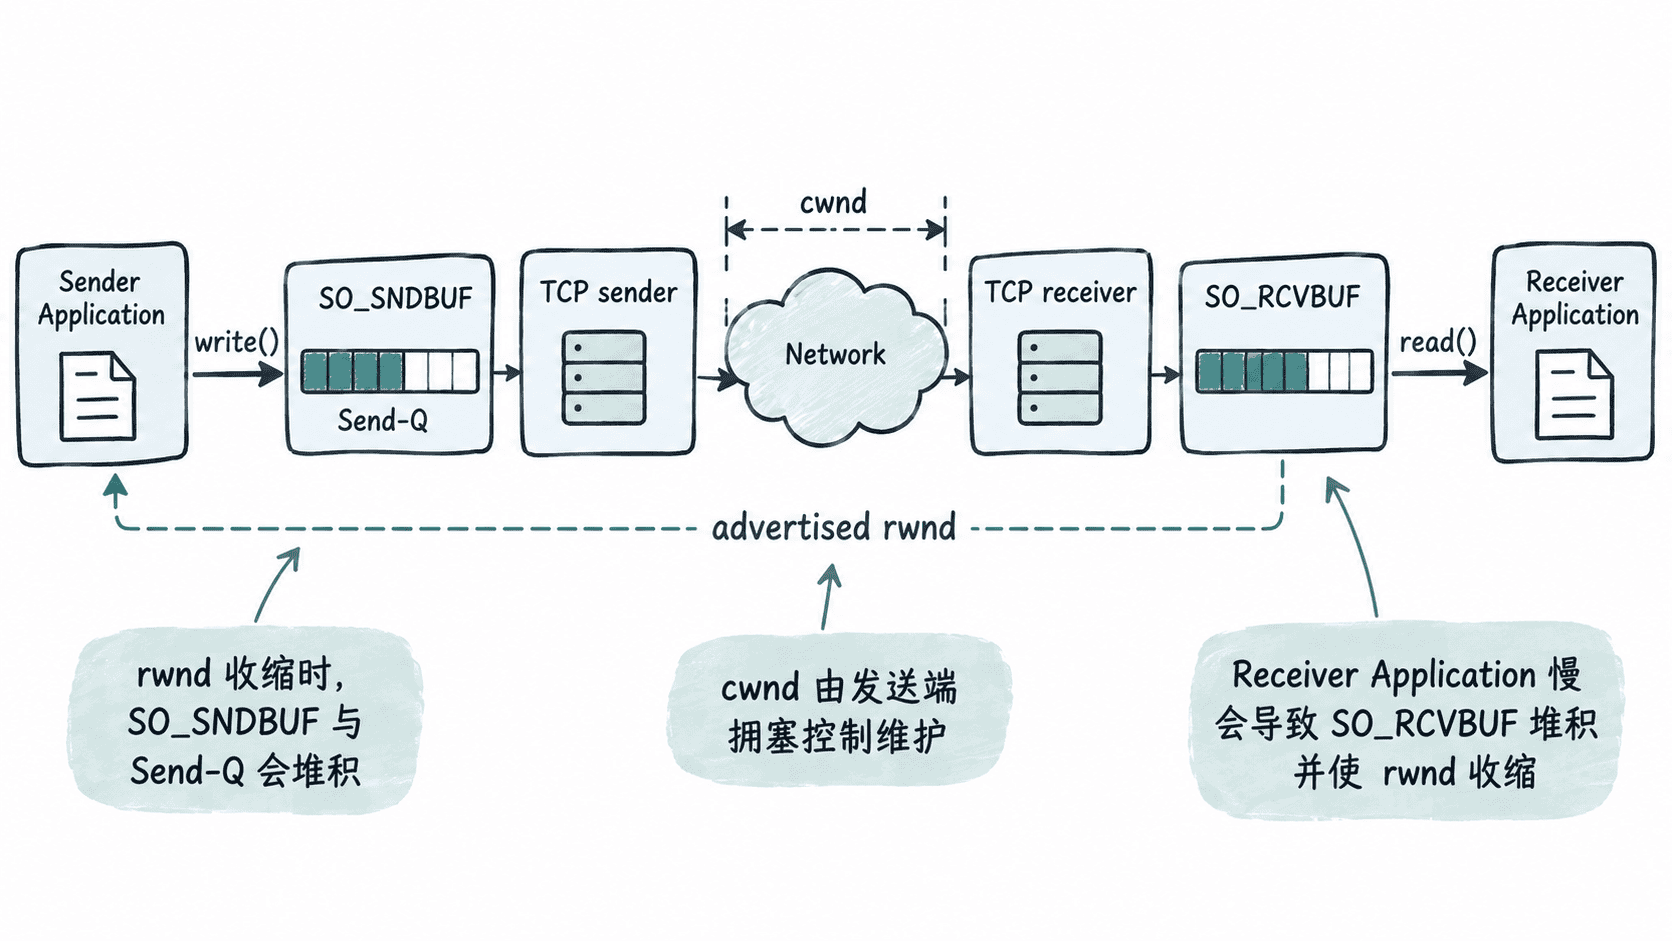
因此,“发送缓冲很大”不能突破对端的 rwnd,更不能绕过 cwnd。在高带宽高 RTT 链路上,过小缓冲可能限制吞吐;在慢消费者场景里,盲目加大缓冲则可能增加排队内存和尾延迟。
用慢消费者观察发送阻塞
下面的程序先把服务端接收缓冲设小,并故意暂停读取;客户端把发送缓冲设小后切到非阻塞模式,持续写入直到内核返回 EAGAIN。它演示的是背压出现的方向,不要求每台机器得到相同字节数。
import socket
import threading
import time

HOST = "127.0.0.1"
PORT = 19091
REQUESTED_BUF = 16 * 1024

def run_server(ready):
    with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as server:
        # 在 listen 前设置,确保监听 socket 的接收缓冲策略传给已接受连接。
        server.setsockopt(socket.SOL_SOCKET, socket.SO_RCVBUF, REQUESTED_BUF)
        server.bind((HOST, PORT))
        server.listen(1)
        print("server SO_RCVBUF=", server.getsockopt(
            socket.SOL_SOCKET, socket.SO_RCVBUF))
        ready.set()

        conn, _ = server.accept()
        with conn:
            # 模拟应用层慢消费者,让接收队列先积压。
            time.sleep(2)
            total = 0
            while True:
                chunk = conn.recv(65536)
                if not chunk:
                    break
                total += len(chunk)
            print("server drained=", total)

def main():
    ready = threading.Event()
    thread = threading.Thread(target=run_server, args=(ready,))
    thread.start()
    ready.wait()

    with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as client:
        client.setsockopt(socket.SOL_SOCKET, socket.SO_SNDBUF, REQUESTED_BUF)
        client.connect((HOST, PORT))
        actual = client.getsockopt(socket.SOL_SOCKET, socket.SO_SNDBUF)
        client.setblocking(False)

        payload = b"x" * 4096
        total = 0
        while True:
            try:
                sent = client.send(payload)
                if sent == 0:
                    break
                total += sent
            except BlockingIOError:
                break

        print("client SO_SNDBUF=", actual)
        print("client queued_before_eagain=", total)

    thread.join()

if __name__ == "__main__":
    main()
预期输出应呈现“缓冲有上限,慢消费者最终让发送端停止继续排队”的模式。Linux 通常会为 socket 记账而返回大于请求值的实际缓冲,具体数值受内核限制和版本影响,因此以下使用动态占位符。
server SO_RCVBUF= <BYTES>
client SO_SNDBUF= <BYTES>
client queued_before_eagain= <BYTES>
server drained= <BYTES>
queued_before_eagain 不等于 SO_SNDBUF:在客户端阻塞前,一部分数据可能已经被对端确认并移出本地发送队列,一部分仍在内核中,接收端也有自己的缓冲。因此不要用这个实验反推一个固定公式。
检查系统上限和实时队列
用户态设置还会受到系统级上下限与 TCP 自动调优影响。先查看当前内核参数,再决定是否需要改动。
sysctl net.core.wmem_max net.core.rmem_max net.ipv4.tcp_wmem net.ipv4.tcp_rmem net.ipv4.tcp_moderate_rcvbuf预期输出形态如下,数值因发行版和主机配置而异。
net.core.wmem_max = <BYTES>
net.core.rmem_max = <BYTES>
net.ipv4.tcp_wmem = <MIN> <DEFAULT> <MAX>
net.ipv4.tcp_rmem = <MIN> <DEFAULT> <MAX>
net.ipv4.tcp_moderate_rcvbuf = <0_OR_1>
调试正在运行的连接时,可以用 ss -tinm 查看 Send-Q、socket memory、RTT、拥塞控制和窗口相关信息。若 Send-Q 长时间增长,同时对端应用读取慢或 rwnd 收缩,问题通常不是“发送缓冲太小”,而是下游消费不足。
调参应该解决什么问题
需要提高缓冲时,先确认链路的带宽时延积较大,且应用和对端都能持续消费;这类场景中,过小缓冲可能让连接无法保有足够在途数据。调整后应同时比较吞吐、RTT、内存占用和尾延迟,而不是只看单一带宽数字。
若现象是消费者处理变慢、Send-Q 持续堆积、写调用阻塞或非阻塞 socket 频繁 EAGAIN,继续放大 SO_SNDBUF 只是延后暴露问题。更合理的修复是限制生产速率、建立应用级队列上限、传播背压,或提升消费者处理能力。