
操作系统 / 系统课时
排查文件描述符耗尽问题
排查文件描述符耗尽问题
文件描述符耗尽时,服务常表现为新连接突然失败,而已有连接仍能工作。本节用可复现的 EMFILE 场景建立排查顺序:先区分进程级与系统级上限,再确认是否存在连接或文件泄漏,最后把容量阈值变成可监控的基线。
学习目标
- 识别
EMFILE、ENFILE与进程、系统文件表之间的对应关系。 - 通过
/proc、sysctl和进程 FD 计数定位真正的耗尽层级。 - 建立文件描述符容量、增长趋势与
accept失败的告警基线。
先确认是哪一层耗尽
accept() 返回 EMFILE 时,含义是当前进程已经达到 RLIMIT_NOFILE;返回 ENFILE 时,才是系统范围的文件表接近或达到上限。只看到“Too many open files”就直接调大系统参数,往往会掩盖应用泄漏。
进程还会受到 fs.nr_open 约束,它决定单进程可设置的 RLIMIT_NOFILE 上限;系统范围的文件句柄容量则主要看 fs.file-max。因此应按“进程已用 FD → 进程软硬限制 → 单进程内核上限 → 系统文件表”的顺序检查。
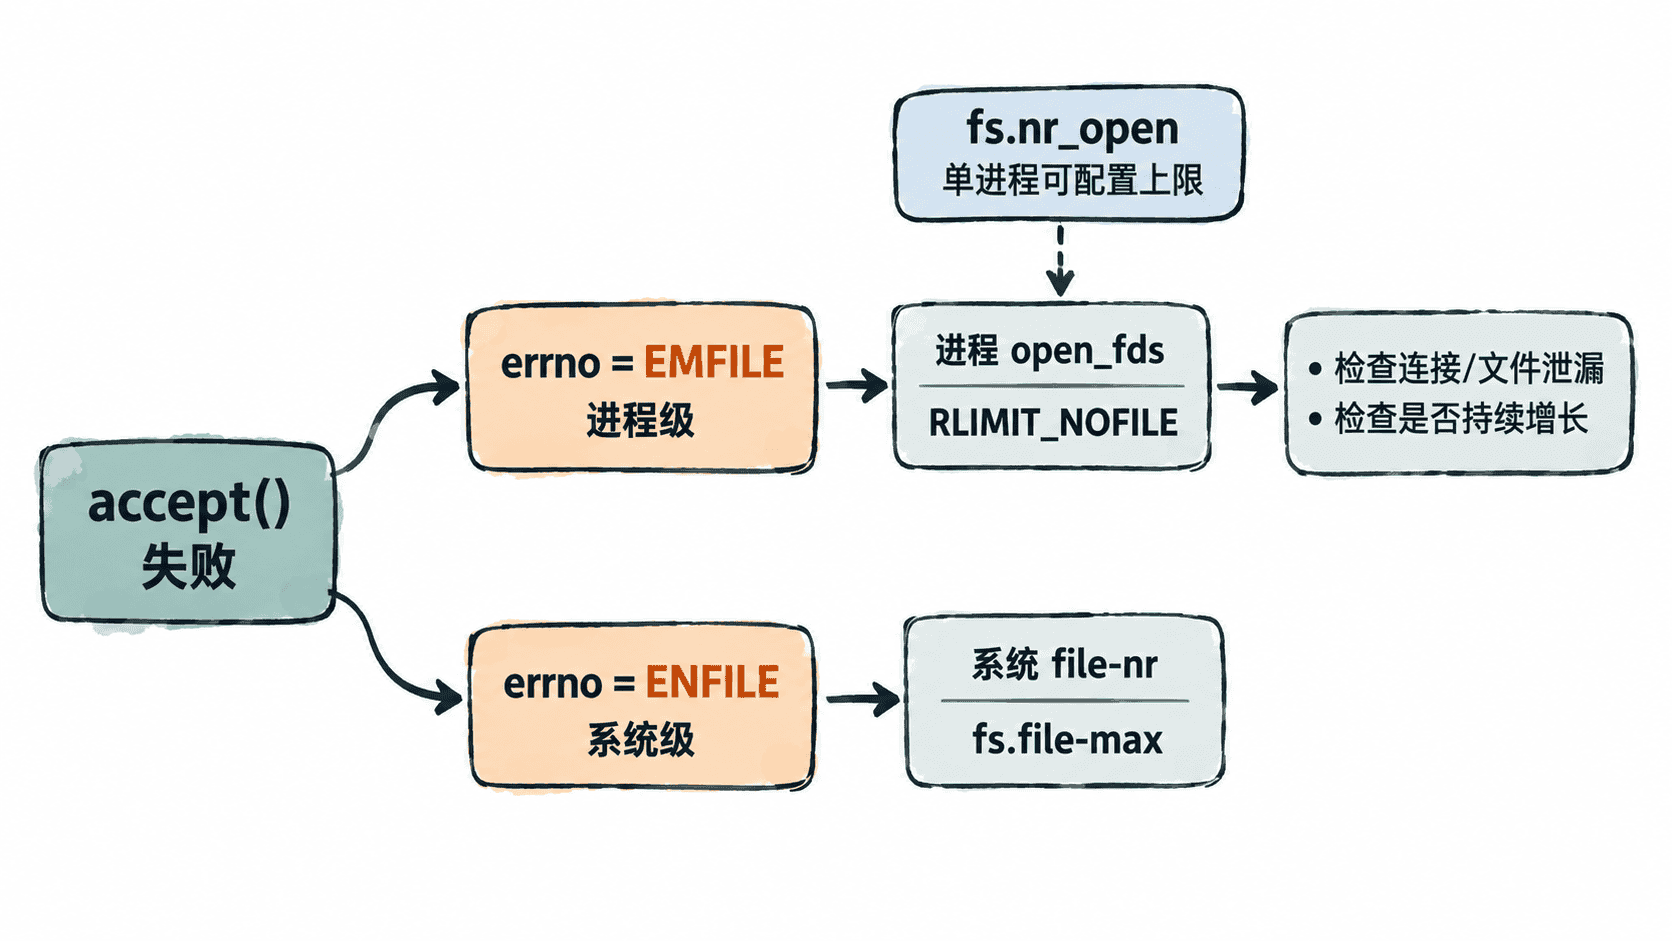
复现 accept 因 EMFILE 失败
下面的 Linux/Python 示例把当前进程的文件描述符限制降到 32,先创建监听 Socket 和一个待处理的回环连接,再故意打开 /dev/null 直到没有空闲 FD。此时 accept() 无法为新 Socket 分配描述符,因此稳定得到 EMFILE。
import errno
import resource
import socket

limit = 32
hard = resource.getrlimit(resource.RLIMIT_NOFILE)[1]
if hard != resource.RLIM_INFINITY and hard < limit:
    limit = hard
if limit < 8:
    raise RuntimeError("RLIMIT_NOFILE 过低,无法运行本示例")

# 仅降低当前示例进程的限制,不修改系统全局参数。
resource.setrlimit(resource.RLIMIT_NOFILE, (limit, limit))

server = socket.socket()
server.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
server.bind(("127.0.0.1", 0))
server.listen(1)

# 先在本进程建立一个待 accept 的回环连接,避免依赖外部客户端。
client = socket.socket()
client.connect(server.getsockname())

# 持续占用 FD,直到内核返回 EMFILE。
opened = []
while True:
    try:
        opened.append(open("/dev/null", "rb"))
    except OSError as exc:
        if exc.errno != errno.EMFILE:
            raise
        break

try:
    server.accept()
except OSError as exc:
    print(f"accept errno={exc.errno} name={errno.errorcode.get(exc.errno)}")

for fp in opened:
    fp.close()
client.close()
server.close()
预期输出:
accept errno=24 name=EMFILE这个复现说明:监听 Socket 本身还存在,并不代表还能接收新连接。accept() 每成功一次都需要为返回的新 Socket 分配一个文件描述符,进程没有可用槽位时就会失败。
从进程限制查到系统上限
先替换 <ID> 为服务实际 PID,再执行以下检查。动态数值会因机器和服务状态不同而变化。
pid=<ID>
grep -i "Max open files" /proc/$pid/limits
printf "open_fds="
ls -1 /proc/$pid/fd | wc -l
sysctl fs.nr_open fs.file-max
cat /proc/sys/fs/file-nr
预期结果形态:
Max open files            <SOFT_LIMIT>         <HARD_LIMIT>         files
open_fds=<COUNT>
fs.nr_open = <PER_PROCESS_MAX>
fs.file-max = <SYSTEM_MAX>
<ALLOCATED> 0 <SYSTEM_MAX>
如果 open_fds 已贴近 <SOFT_LIMIT>,而系统 <ALLOCATED> 远低于 <SYSTEM_MAX>,问题就在单进程侧。若很多进程同时增长并把系统文件表推高,则需要继续找出贡献最大的进程,而不是只给单个服务加额度。
判断是容量不足还是泄漏
容量不足通常与并发量同步:请求上升时 FD 增加,请求回落后 FD 也下降。泄漏则表现为 FD 长时间单调增长,业务负载回落后仍不释放。可以连续采样 /proc/<ID>/fd 数量,并用 ss -tanp、lsof -p <ID> 或 /proc/<ID>/fd 的符号链接判断增长的是 Socket、普通文件、管道还是其他对象。
特别注意,TIME_WAIT 是 TCP 状态,不等于服务进程仍持有一个 FD;已经 close() 的连接可以继续处于 TIME_WAIT。因此不能用 TIME_WAIT 数量直接代替进程 FD 数量。
修复顺序应是先关闭泄漏路径,再评估是否确实需要提高限制。由 systemd 启动的服务可在单元配置中设置 LimitNOFILE,但修改后必须重启服务并重新验证实际限制,不能只看配置文件。
片段示例,放入对应 systemd 服务的 [Service] 段:
LimitNOFILE=65536配置生效后,用实际服务名替换 <SERVICE> 验证:
systemctl show <SERVICE> -p LimitNOFILE预期结果:
LimitNOFILE=65536建立容量与告警基线
至少同时监控三类信号:进程 open_fds / soft_limit、系统 file-nr 已分配量与 fs.file-max 的比值,以及 accept() 的 EMFILE/ENFILE 错误计数。单点阈值只能发现“已经很满”,增长趋势才能提前发现泄漏。
可以把 70%~80% 作为容量预警区间,再结合业务峰值校准;接近 90% 时应升级告警级别。更关键的是增加“低流量时 FD 仍持续增长”的趋势告警,并为正常峰值保留安全余量。这样扩容参数与修复泄漏就能基于证据,而不是在事故现场盲目调大上限。