
操作系统 / 系统课时
压测吞吐并定位性能瓶颈
压测吞吐并定位性能瓶颈
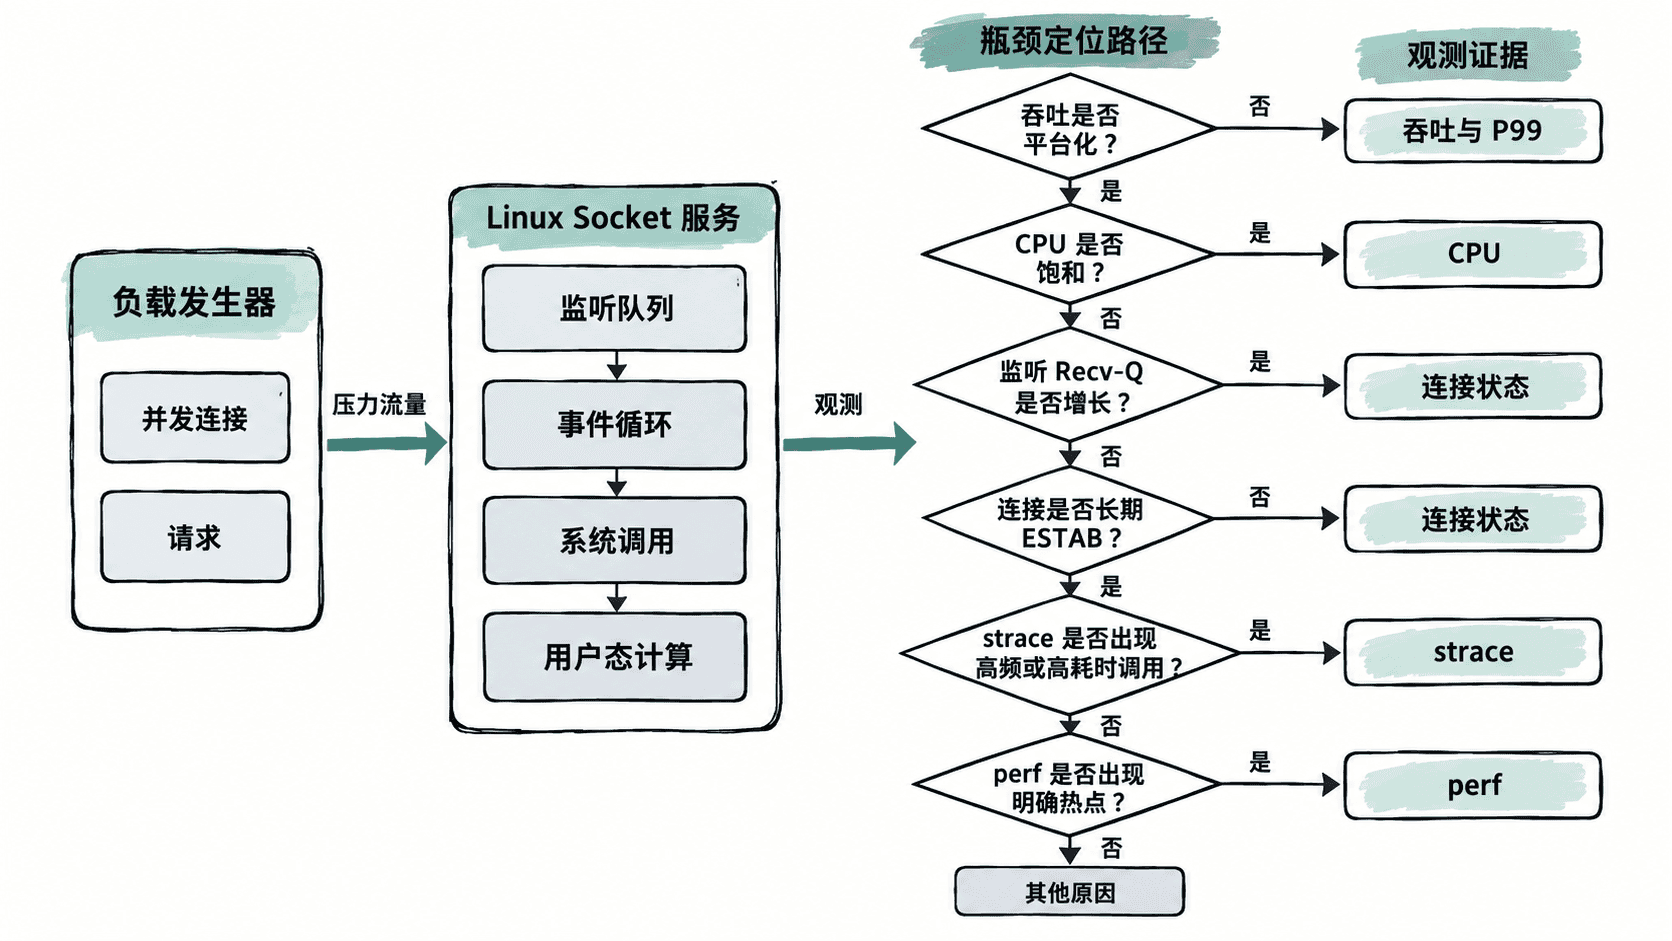
这一节把“服务慢”拆成可验证的证据:先固定并发与请求模型,记录吞吐、尾延迟、CPU 和连接状态,再用 ss、strace 与 perf 逐层判断瓶颈究竟在连接队列、系统调用、调度还是用户态计算。
学习目标
- 建立可重复的并发压测基线,并同时记录吞吐、尾延迟、CPU 与连接数。
- 能用
ss、strace和perf把“延迟升高”缩小到具体资源或代码路径。 - 根据多项证据区分 CPU 饱和、连接堆积、慢客户端与系统调用过密等问题。
先建立可重复的压测基线
压测前先固定服务版本、监听地址、请求内容和机器环境,不要一边改参数一边比较结果。至少记录 Requests/s、P99 延迟、服务进程 CPU、已建立连接数四项;只看平均延迟很容易掩盖尾部抖动。
下面假设被测服务提供 HTTP 接口,且已经安装 wrk 与 sysstat。把 <PID> 和 <PORT> 替换成实际进程号与监听端口。脚本让 pidstat 与 30 秒压测并行执行,并把原始结果保存在 /tmp,便于后续对照。
PID=<PID>
PORT=<PORT>
pidstat -p "$PID" 1 30 > /tmp/socket-pidstat.txt &
MONITOR_PID=$!
wrk -t4 -c200 -d30s --latency "http://127.0.0.1:$PORT/" | tee /tmp/socket-wrk.txt
wait "$MONITOR_PID"
tail -n 5 /tmp/socket-pidstat.txt
预期输出
Requests/sec: <RPS>
Latency Distribution
  99%    <P99_LATENCY>
Average: ... <PID> ... <CPU_PERCENT> ... <COMMAND><RPS>、<P99_LATENCY> 与 <CPU_PERCENT> 会随机器和实现变化。第一次运行只建立基线;随后每次只改变一个变量,例如连接数从 200 提到 400,才能判断吞吐是否已经进入平台区。
用连接状态判断是不是排队问题
吞吐不再增长时,先看连接是否在服务端堆积。ss 的监听队列和连接状态比“感觉连接很多”更有诊断价值:监听 socket 的 Recv-Q 持续升高,通常说明应用接受连接不够快;大量 ESTAB 长时间存在,则还要结合响应大小与写阻塞判断客户端是否读得过慢。
PORT=<PORT>
echo "listen:"
ss -ltn "sport = :$PORT"
echo "states:"
ss -H -tan "sport = :$PORT" | awk '{count[$1]++} END {for (s in count) print s, count[s]}'
预期输出
listen:
State  Recv-Q Send-Q Local Address:Port Peer Address:Port
LISTEN <RECV_Q> <SEND_Q> *:<PORT> *:*
states:
ESTAB <COUNT>
TIME-WAIT <COUNT>
<RECV_Q> 在持续压测下不断增大时,优先检查 accept 处理能力、事件循环是否被长任务阻塞以及监听 backlog;连接数很高但 CPU 不高时,不要直接把问题归咎于 CPU。
用系统调用与 CPU 采样缩小范围
strace -c 适合回答“时间花在哪类系统调用”,perf stat 适合回答“CPU 是否真的忙、上下文切换是否异常”。两者都会产生额外开销,所以应在复现问题后短时间采样,而不是从头到尾常驻压测。
PID=<PID>
sudo timeout 10s strace -f -c -p "$PID" -e trace=network,read,write,epoll_wait
sudo perf stat -p "$PID" -e task-clock,cycles,instructions,context-switches,cpu-migrations -- sleep 10
预期输出
% time  seconds  usecs/call  calls  errors  syscall
<PERCENT> <SECONDS> <USECS> <CALLS> <ERRORS> <SYSCALL>
Performance counter stats for process id '<PID>':
<COUNT> task-clock
<COUNT> cycles
<COUNT> instructions
<COUNT> context-switches
如果 CPU 已接近单核或多核上限,再用 perf record 找用户态热点;如果 CPU 很低而线程大量停在 epoll_wait,说明服务可能在等输入,并不能单凭这一项判定性能差。真正可疑的是多项证据同时指向同一方向。
PID=<PID>
sudo perf record -F 99 -g -p "$PID" -- sleep 10
sudo perf report --stdio --no-children | head -n 30
预期输出
Overhead  Command  Shared Object  Symbol
<PERCENT> <COMM>   <OBJECT>       <HOT_SYMBOL>
...
<HOT_SYMBOL> 若长期集中在序列化、拷贝、加解密或业务计算函数,说明瓶颈更接近用户态 CPU;若热点落在锁竞争或频繁调度相关路径,则应继续检查线程模型和共享资源。
把证据组合成结论
定位时不要依赖单个数字。更可靠的判断是看“吞吐曲线 + 延迟 + CPU + socket 状态 + 采样热点”是否形成一致证据链。
| 现象组合 | 更可能的瓶颈 | 下一步 |
|---|---|---|
吞吐平台化、P99 上升、CPU 接近上限、perf 有稳定热点 |
用户态计算或单线程事件循环饱和 | 优化热点、减少拷贝或扩展并行度 |
CPU 不高、监听 Recv-Q 持续增大 |
接受连接不及时或事件循环被阻塞 | 检查 accept、backlog 与长任务 |
ESTAB 很多、写相关调用频繁失败或阻塞 |
慢客户端导致发送侧背压 | 限制单连接缓冲并正确处理可写事件 |
| 上下文切换异常高、吞吐下降 | 线程过多、锁竞争或频繁唤醒 | 减少线程切换并检查共享锁 |
最终验收标准不是“某个工具看起来正常”,而是提高并发时能够解释吞吐为何增长、何时进入平台区,以及平台区对应的系统证据。压测工具负责制造稳定负载,ss 说明连接层现象,strace 说明系统调用行为,perf 才把问题进一步落到 CPU 与代码路径。