
操作系统 / 系统课时
配置 TCP Keepalive 探测死连接
配置 TCP Keepalive 探测死连接
TCP 连接如果对端断电、链路被黑洞或中间设备静默丢包,应用可能长时间收不到 FIN 或 RST。TCP Keepalive 通过“空闲一段时间后主动探测”让内核发现这类半开连接;关键是正确配置空闲时间、探测间隔和失败次数,并知道它不能替代业务心跳。
学习目标
- 配置 Linux TCP Keepalive 的启用开关、空闲时间、探测间隔和次数
- 根据三个参数估算死连接被发现的大致时间
- 区分 TCP Keepalive 与应用层心跳分别能证明什么
Keepalive 的三个计时参数
首先用 SO_KEEPALIVE 打开启用开关,然后在 Linux 上通过三个 TCP 级选项控制探测节奏。
| 选项 | 含义 | 示例值 |
|---|---|---|
TCP_KEEPIDLE |
连接连续空闲多久后开始第一轮保活探测 | 60 秒 |
TCP_KEEPINTVL |
未收到响应时,相邻探测之间等待多久 | 10 秒 |
TCP_KEEPCNT |
连续多少次探测失败后判定连接失效 | 3 次 |
在没有其他超时机制干预时,60/10/3 这组参数意味着:连接最后一次有效收发之后,先空闲约 60 秒,再进行失败探测;若始终没有响应,通常会在约 90 秒量级把连接判为失败。实际时刻会受内核调度、重传实现和其他 TCP 选项影响,因此应把这个结果理解为工程估算而不是绝对秒表值。
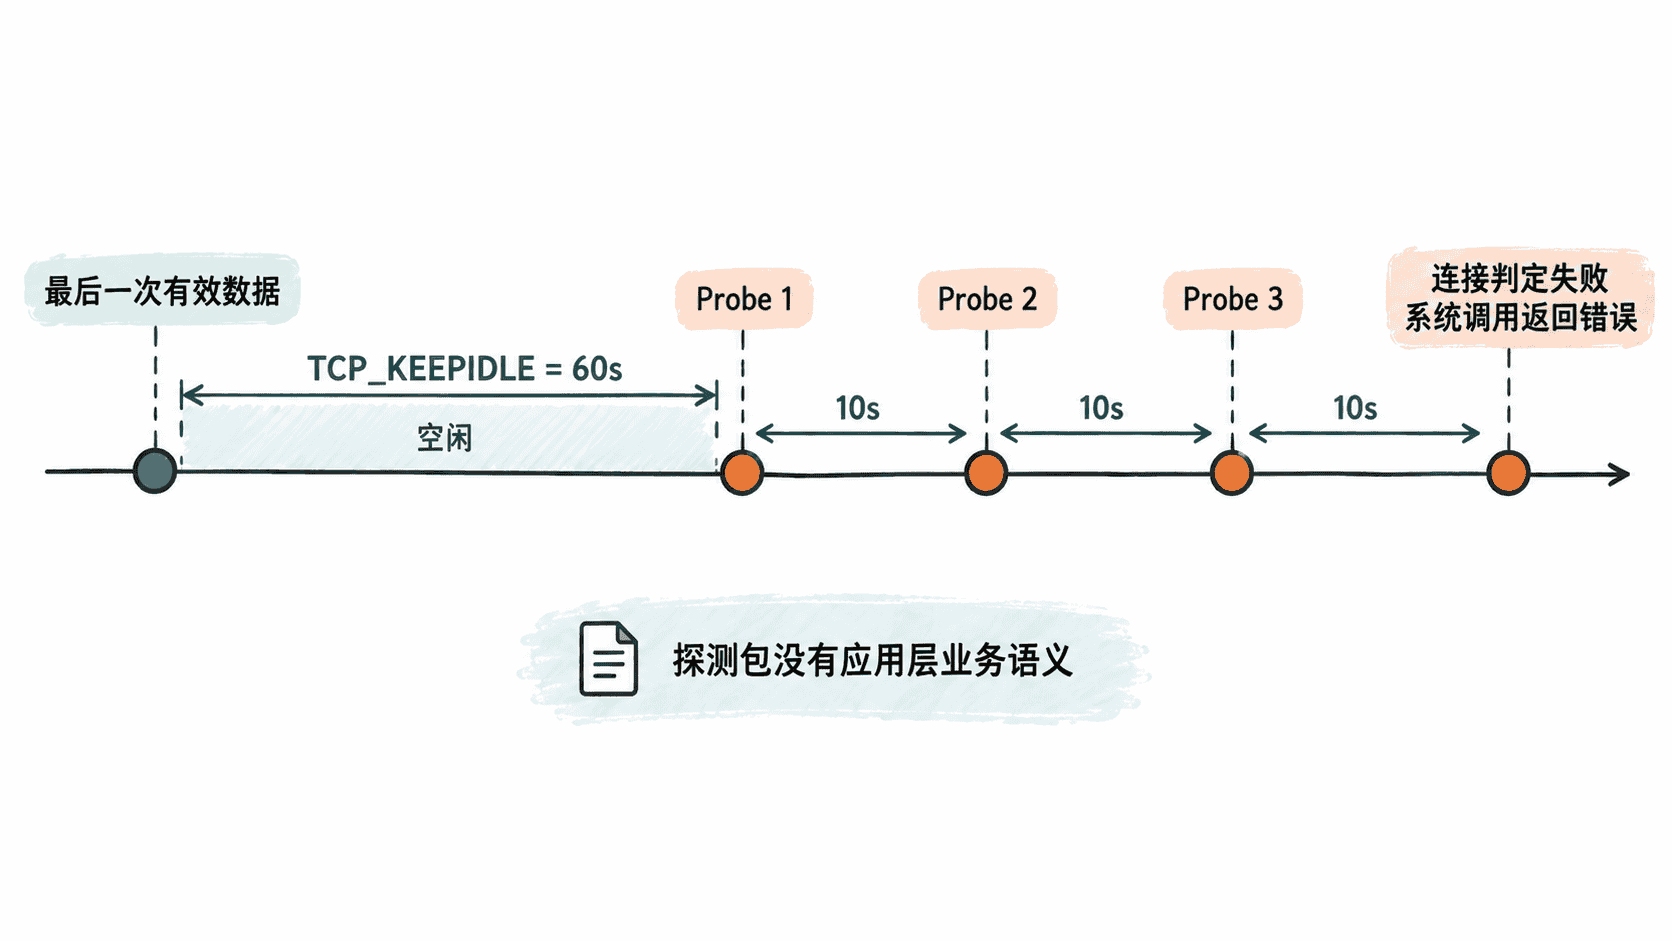
在单个 TCP 连接上配置
下面的程序完全在本机回环地址上建立一条 TCP 连接,然后对服务端已接受的 Socket 设置 Keepalive,并用 getsockopt() 读取回来。这样可以先确认配置确实落到了目标连接,而不需要等待真正的故障。
import socket

listener = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
listener.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
listener.bind(("127.0.0.1", 0))
listener.listen(1)

port = listener.getsockname()[1]
client = socket.create_connection(("127.0.0.1", port))
server_conn, _ = listener.accept()

# 对真正传输业务数据的已连接 Socket 配置保活。
server_conn.setsockopt(socket.SOL_SOCKET, socket.SO_KEEPALIVE, 1)
server_conn.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPIDLE, 60)
server_conn.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPINTVL, 10)
server_conn.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPCNT, 3)

print("SO_KEEPALIVE=", server_conn.getsockopt(socket.SOL_SOCKET, socket.SO_KEEPALIVE), sep="")
print("TCP_KEEPIDLE=", server_conn.getsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPIDLE), sep="")
print("TCP_KEEPINTVL=", server_conn.getsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPINTVL), sep="")
print("TCP_KEEPCNT=", server_conn.getsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPCNT), sep="")

server_conn.close()
client.close()
listener.close()
预期输出
SO_KEEPALIVE=1
TCP_KEEPIDLE=60
TCP_KEEPINTVL=10
TCP_KEEPCNT=3
服务端通常应在每个已接受连接上明确配置这些选项;客户端则在完成 connect() 后对自己的连接 Socket 配置。这样策略与具体连接绑定,不依赖机器级默认值,也不会误伤同机上需要不同保活周期的其他服务。
不要用优雅关闭测试死连接
如果对端正常 close(),内核会发送 FIN;如果进程异常退出但主机仍在线,内核通常也能用 RST 或正常关闭流程通知本端。这些都不是 Keepalive 要解决的“静默失联”。
要验证 Keepalive,测试环境应模拟包被持续丢弃但连接两端都收不到关闭信号的情况,例如在隔离的网络命名空间、测试防火墙规则或可控故障注入环境中临时丢弃该连接的报文。此时应用若阻塞在读操作上,最终应在 Keepalive 判定失败后得到超时或网络错误。不要直接在生产主机上修改防火墙来做这项实验。
Keepalive 不能替代应用心跳
TCP Keepalive 回答的是“内核还能不能通过这条 TCP 路径触达对端协议栈”。它不验证远端线程池是否卡死、业务进程是否还能处理请求,也不能携带诸如节点角色、租约、延迟或业务版本之类的状态。
应用心跳则可以定义明确的请求与响应,例如“10 秒内返回 PONG 并附带当前任期”。因此需要判断服务健康、故障转移资格或业务级超时时,应使用应用心跳;只是希望清理长期空闲的半开连接,并且不想频繁发送业务消息时,TCP Keepalive 更合适。
工程上常把两者叠加:应用心跳负责业务可用性,TCP Keepalive 负责兜底发现静默断链。这样既不会把“协议栈还活着”误判成“服务健康”,也能避免完全依赖高频业务心跳来清理死连接。