
操作系统 / 系统课时
比较进程与线程并发模型
比较进程与线程并发模型
阻塞式服务器常把每个连接交给一个子进程或线程处理,让单个连接的阻塞不再卡住整个服务。本节用同一份程序实现并比较两种模型,观察它们在地址空间、文件描述符、同步成本和连接规模上的差异。
学习目标
- 实现“一连接一进程”和“一连接一线程”两种阻塞并发服务器。
- 从地址空间、调度、同步与资源占用角度解释两种模型的核心差异。
- 判断何时阻塞并发仍足够简单可靠,何时应转向事件驱动模型。
两种模型到底隔离了什么
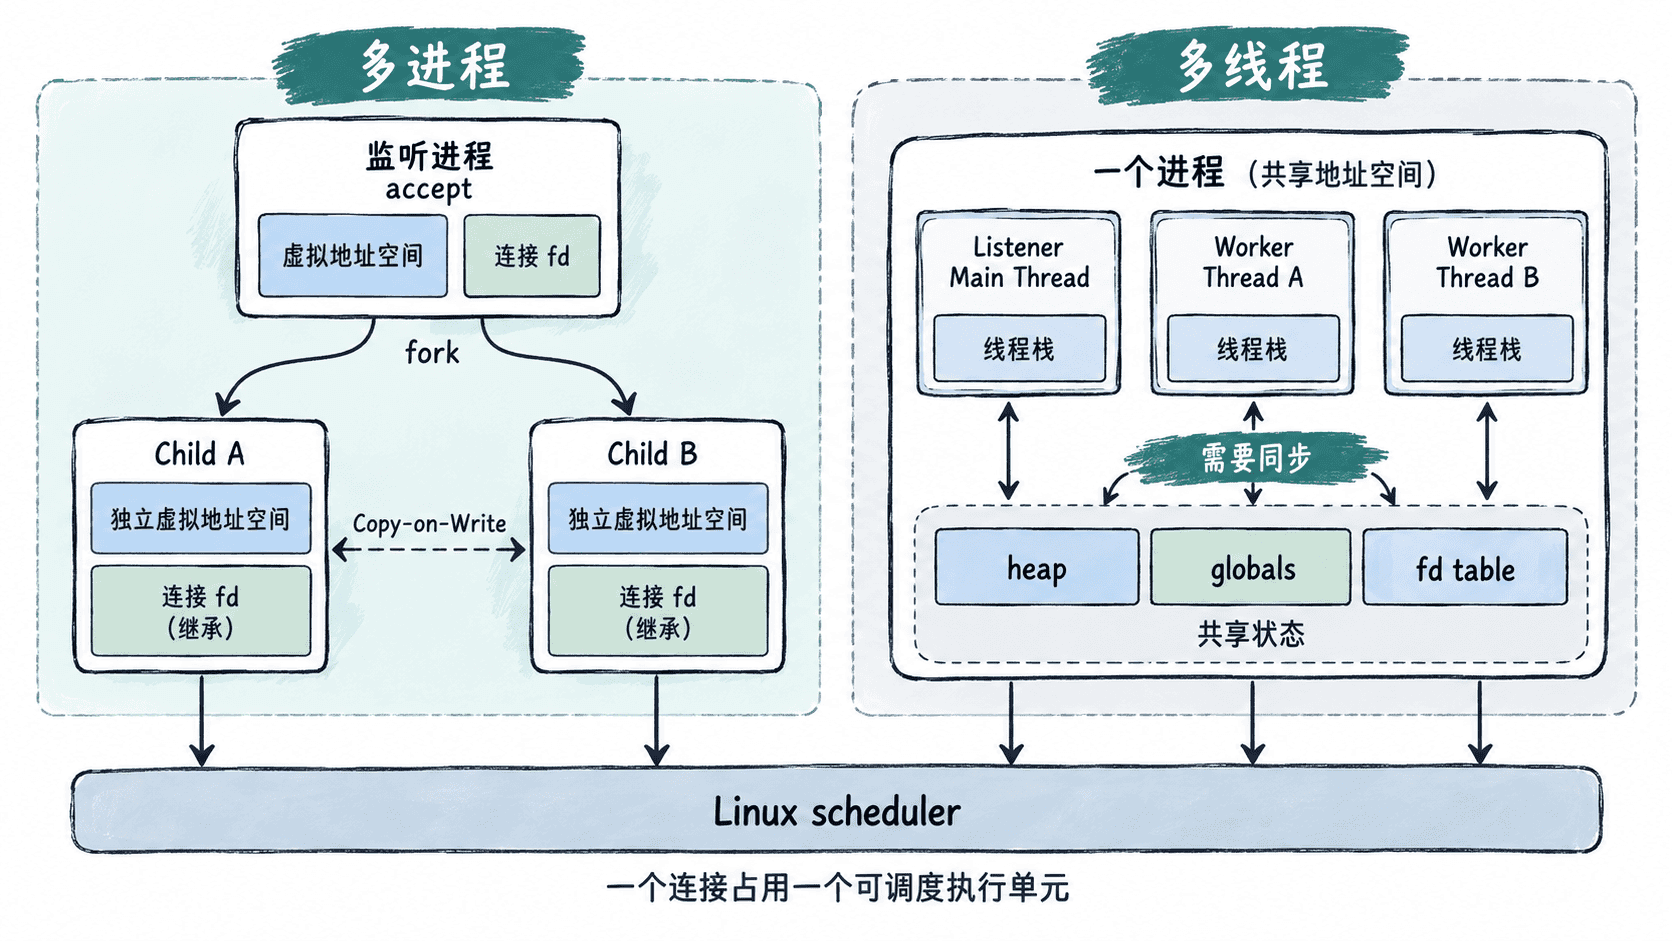
fork() 创建子进程后,父子进程拥有独立的虚拟地址空间;初始内存通常依赖写时复制,不会立刻把全部物理页复制一遍。已打开的文件描述符会被继承,因此父进程在把已连接 socket 交给子进程后,应关闭自己那份描述符。
线程则共享同一进程的地址空间和文件描述符表。创建线程通常比创建进程轻,但共享堆、全局变量和连接对象也意味着竞态条件更容易出现;多个线程修改同一状态时,需要互斥锁、原子操作或其他同步机制。
用一个程序切换 process 与 thread 模式
下面的程序固定接收两个客户端连接,process 模式对每个连接执行一次 fork(),thread 模式则创建一个 POSIX 线程。为了让差异直接可见,服务端把自己的进程 ID 和线程 ID 写进响应。
将代码保存为 blocking_server.c:
#include <arpa/inet.h>
#include <netinet/in.h>
#include <pthread.h>
#include <sys/socket.h>
#include <sys/wait.h>
#include <unistd.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

static void serve_one(int fd, int thread_mode) {
    char buf[128];
    ssize_t n = recv(fd, buf, sizeof(buf) - 1, 0);
    if (n <= 0) {
        return;
    }
    buf[n] = '\0';

    char out[256];
    if (thread_mode) {
        snprintf(out, sizeof(out), "model=thread pid=%ld tid=%lu echo=%s",
                 (long)getpid(), (unsigned long)pthread_self(), buf);
    } else {
        snprintf(out, sizeof(out), "model=process pid=%ld echo=%s",
                 (long)getpid(), buf);
    }
    send(fd, out, strlen(out), 0);
}

static void *thread_worker(void *arg) {
    int fd = *(int *)arg;
    serve_one(fd, 1);
    close(fd);
    return NULL;
}

int main(int argc, char **argv) {
    if (argc != 3 || (strcmp(argv[1], "process") != 0 &&
                      strcmp(argv[1], "thread") != 0)) {
        fprintf(stderr, "usage: %s process|thread PORT\n", argv[0]);
        return 2;
    }

    int thread_mode = strcmp(argv[1], "thread") == 0;
    int port = atoi(argv[2]);

    int listen_fd = socket(AF_INET, SOCK_STREAM, 0);
    if (listen_fd < 0) {
        perror("socket");
        return 1;
    }

    int yes = 1;
    setsockopt(listen_fd, SOL_SOCKET, SO_REUSEADDR, &yes, sizeof(yes));

    struct sockaddr_in addr = {0};
    addr.sin_family = AF_INET;
    addr.sin_addr.s_addr = htonl(INADDR_LOOPBACK);
    addr.sin_port = htons((unsigned short)port);

    if (bind(listen_fd, (struct sockaddr *)&addr, sizeof(addr)) < 0 ||
        listen(listen_fd, 16) < 0) {
        perror("bind/listen");
        close(listen_fd);
        return 1;
    }

    printf("listening mode=%s port=%d\n", argv[1], port);
    fflush(stdout);

    pthread_t tids[2];
    int client_fds[2];

    for (int i = 0; i < 2; ++i) {
        int client_fd = accept(listen_fd, NULL, NULL);
        if (client_fd < 0) {
            perror("accept");
            close(listen_fd);
            return 1;
        }

        if (thread_mode) {
            client_fds[i] = client_fd;
            int rc = pthread_create(&tids[i], NULL, thread_worker, &client_fds[i]);
            if (rc != 0) {
                fprintf(stderr, "pthread_create: %s\n", strerror(rc));
                close(client_fd);
                close(listen_fd);
                return 1;
            }
        } else {
            pid_t pid = fork();
            if (pid == 0) {
                close(listen_fd);
                serve_one(client_fd, 0);
                close(client_fd);
                _exit(0);
            }
            if (pid < 0) {
                perror("fork");
                close(client_fd);
                close(listen_fd);
                return 1;
            }
            close(client_fd);
        }
    }

    if (thread_mode) {
        pthread_join(tids[0], NULL);
        pthread_join(tids[1], NULL);
    } else {
        wait(NULL);
        wait(NULL);
    }

    close(listen_fd);
    return 0;
}
客户端并发发起两个连接。将下面内容保存为 client.py:
import socket
from concurrent.futures import ThreadPoolExecutor

def call(message: str) -> str:
    with socket.create_connection(("127.0.0.1", 19090)) as sock:
        sock.sendall(message.encode())
        chunks = []
        while chunk := sock.recv(256):
            chunks.append(chunk)
        return b"".join(chunks).decode()

with ThreadPoolExecutor(max_workers=2) as pool:
    results = list(pool.map(call, ["alpha", "beta"]))

for line in results:
    print(line)
先编译,再分别运行两种模式:
cc -Wall -Wextra -O2 -pthread blocking_server.c -o blocking_server

./blocking_server process 19090 >process.log 2>&1 &
SERVER_PID=$!
sleep 0.2
python3 client.py
wait "$SERVER_PID"
cat process.log

./blocking_server thread 19090 >thread.log 2>&1 &
SERVER_PID=$!
sleep 0.2
python3 client.py
wait "$SERVER_PID"
cat thread.log

rm -f blocking_server process.log thread.log
预期输出如下,实际 PID/TID 会不同,因此用 <ID> 表示:
model=process pid=<ID> echo=alpha
model=process pid=<ID> echo=beta
listening mode=process port=19090
model=thread pid=<ID> tid=<ID> echo=alpha
model=thread pid=<ID> tid=<ID> echo=beta
listening mode=thread port=19090
关键观察点不是 ID 的具体数值:process 两条响应来自两个不同 PID;thread 两条响应的 PID 相同,而 TID 不同。示例中的 sleep 0.2 仅用于演示启动顺序,真实服务应使用就绪探针或重试机制。
调度、内存与同步的实际代价
多进程的优势是故障和内存写入天然隔离:一个子进程破坏自己的堆,通常不会直接改坏另一个连接处理器的内存。代价是进程对象、页表与 IPC 管理更重;共享统计、缓存或限流状态时,需要共享内存、管道等额外机制。
多线程共享地址空间,传递连接对象和共享缓存更直接,单个工作线程的创建成本通常也更低。但共享状态必须设计同步边界;锁竞争、死锁或错误的 fd 所有权管理,会把“轻量”优势抵消掉。线程栈大小也会随着线程数累计占用虚拟地址空间和实际内存。
两种模型还有一个共同上限:每个活跃连接都绑定一个可调度执行单元。连接大量处于等待网络数据的状态时,系统仍要维护成百上千甚至更多任务、栈和调度元数据,频繁唤醒也会增加上下文切换。
怎样选择阻塞并发模型
连接数较小、每个请求逻辑较重、隔离优先级高时,多进程模型简单而稳健;需要共享内存中的缓存或业务对象、连接规模中等且同步关系可控时,多线程通常更合适。两者都适合把阻塞 API 直接映射到顺序业务代码。
当连接规模继续增大,而且大部分连接时间都花在等待 I/O 上,继续增加进程或线程会越来越不经济。这时应把“连接”和“执行单元”解耦,使用 epoll 等事件驱动机制,让少量线程管理大量非阻塞 socket;这正是阻塞并发模型的自然边界。