
信号处理 / 系统课时
估算实时算法的计算预算
估算实时算法的计算预算
实时 DSP 的关键不是“平均能跑多快”,而是每批数据到达后,算法能否在下一批数据到来前完成。本篇用采样率、块大小、每样本运算量和处理器有效吞吐量建立一套可计算的预算,并留出中断、搬运和调度余量。
学习目标
- 由采样率和块大小算出每个处理周期的硬截止时间。
- 把每样本运算量换算成每块计算时间,并判断是否超预算。
- 为缓存、DMA、中断和最坏情况抖动预留安全余量。
先算出数据到达的截止时间
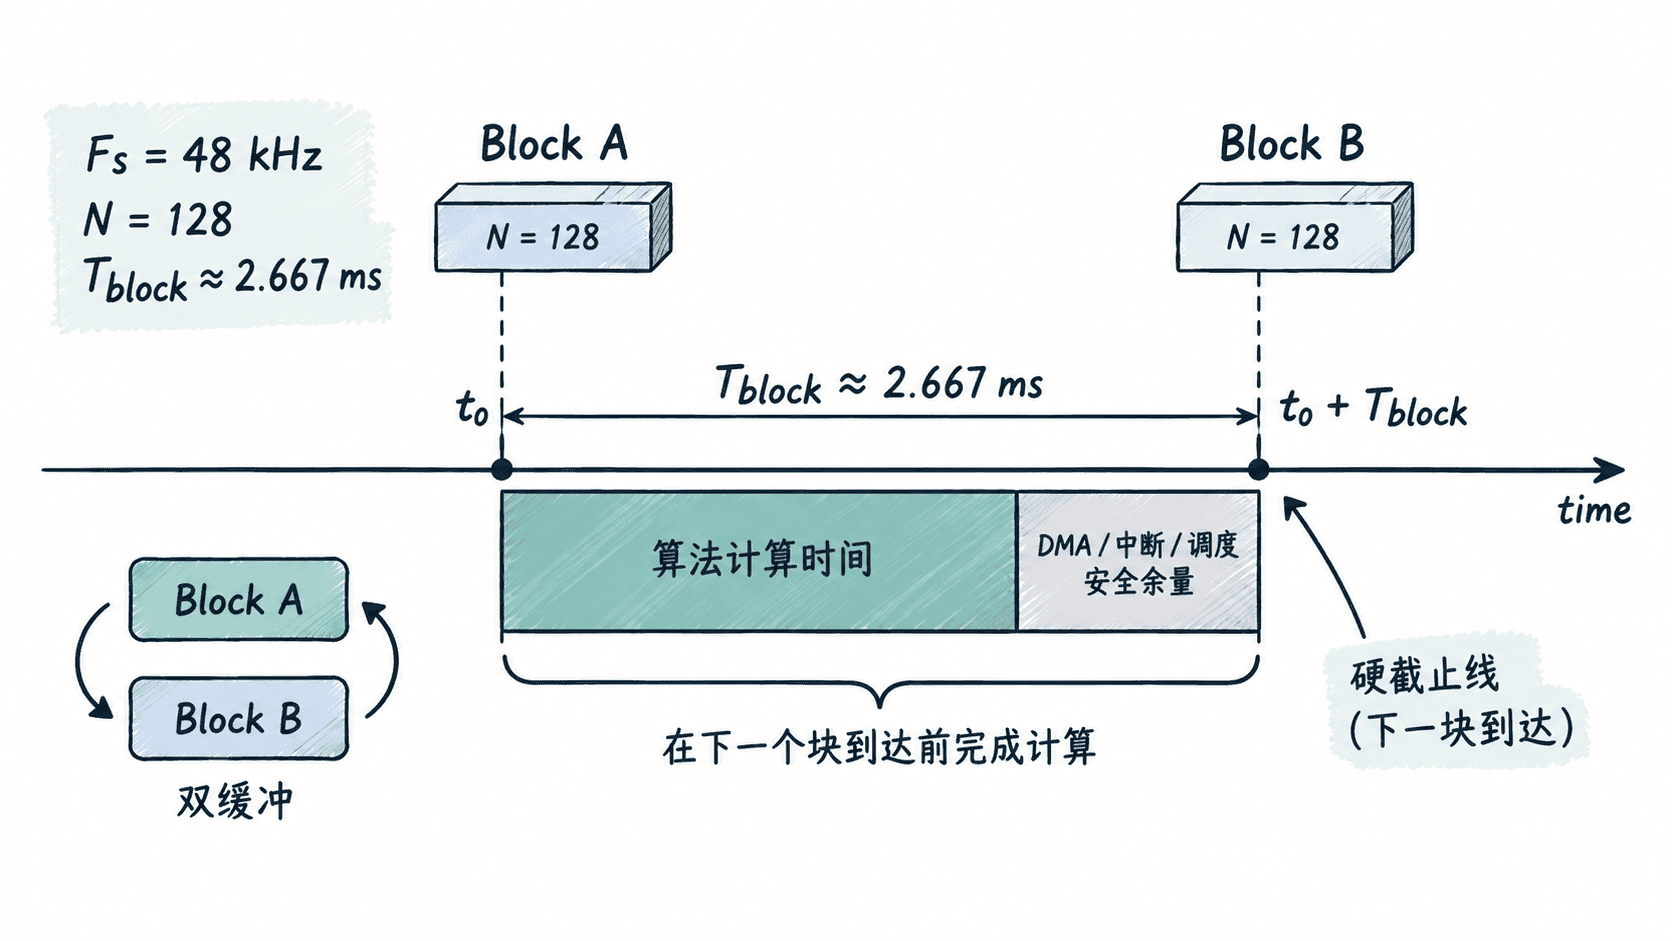
若采样率为 ,每次处理 个样本,那么新一块数据每隔 秒到达。这个时间不是建议值,而是流式处理的基本截止时间:上一块若还没有处理完,下一块就可能覆盖缓冲区、堆积队列或增加端到端延迟。
例如 48 kHz 音频以 128 点为一块,处理周期约为 2.667 ms。块越小,算法响应越快,但调度和函数调用更频繁;块越大,单次可用时间增加,同时缓存需求和算法延迟也会变大。
把算法复杂度换成时间
设每个样本平均需要 次基础运算,则每块运算量为 。再用处理器在目标实现下的有效执行速度 去除,得到估算计算时间 。
这里的 应尽量使用实测的“有效吞吐量”,而不是芯片手册里的峰值主频。一次乘加是否是一条指令、是否能 SIMD 并行、缓存是否命中,都会让“每秒多少次有效运算”与时钟频率产生明显差异。
下面用 Python 做一次可重复的预算计算。假设 48 kHz、128 点一块,算法每样本约 220 次基础运算,处理器实测有效吞吐量为 1.2 亿次/秒,并规定 DSP 计算最多占处理周期的 70%。
fs = 48_000
block_size = 128
ops_per_sample = 220
effective_ops_per_second = 120_000_000
max_dsp_ratio = 0.70

block_period_ms = block_size / fs * 1000
block_ops = block_size * ops_per_sample
compute_time_ms = block_ops / effective_ops_per_second * 1000
budget_ms = block_period_ms * max_dsp_ratio
headroom_ms = budget_ms - compute_time_ms
load_percent = compute_time_ms / block_period_ms * 100

print(f"块周期: {block_period_ms:.3f} ms")
print(f"每块运算量: {block_ops} ops")
print(f"估算计算时间: {compute_time_ms:.3f} ms")
print(f"DSP 可用预算: {budget_ms:.3f} ms")
print(f"预算余量: {headroom_ms:.3f} ms")
print(f"处理周期占用率: {load_percent:.1f}%")
预期输出
块周期: 2.667 ms
每块运算量: 28160 ops
估算计算时间: 0.235 ms
DSP 可用预算: 1.867 ms
预算余量: 1.632 ms
处理周期占用率: 8.8%
这个结果表示算法的纯计算时间远低于 1.867 ms 的内部预算,因此在该估算下有较大余量。若 headroom_ms 小于 0,则即使平均吞吐量看起来足够,当前参数也已经越过设定的实时安全线。
不要只看平均运算量
实时系统更关心最坏情况而不是均值。缓存未命中、DMA 争用、分支抖动、中断服务、操作系统调度和其他任务抢占,都可能把偶发处理时间推高。因此工程上通常不会把整个 2.667 ms 全部分配给 DSP。
还要注意算法结构带来的突发开销。FIR 的每块工作量通常比较稳定,而 FFT 卷积、谱分析、缓冲区重排或低频运行的控制逻辑,可能让某些块明显更重。若存在这种周期性重任务,应按最重块或测得的高分位执行时间评估。
用三个条件做最终判定
一个配置可以视为具备基本实时可行性,至少应同时满足:单块最坏执行时间小于块周期;DSP 计算不超过预先设定的占用比例;连续运行时没有缓冲区积压或截止时间违约。
如果预算不足,优先从降低每样本运算量、使用 SIMD 或硬件加速、减少不必要的数据拷贝、调整块大小几个方向处理。增大块大小能放宽单次截止时间,但会提高系统延迟,因此它不是无代价的补救手段。