
信号处理 / 系统课时
用 FFT 加速频谱计算
用 FFT 加速频谱计算
直接按 DFT 定义计算频谱时,每个频率点都要重新遍历全部样本,数据一长计算量就迅速上升。本篇从计算量和基 2 分解出发理解 FFT,并亲手实现一个最小 FFT,与直接 DFT 对照验证结果一致。
学习目标
- 说明直接 DFT 为何需要 O(N²) 级计算,而 FFT 可降到 O(N log₂ N)
- 理解基 2 FFT 的偶奇分解与蝶形复用思路
- 用程序验证直接 DFT 与 FFT 得到相同的复数频谱
为什么直接 DFT 会慢
长度为 N 的 DFT 要计算 N 个频率点,而每个频率点都需要把 N 个时域样本乘以对应复指数后求和,因此工作量随 N² 增长。N=1024 时,直接计算要处理约 1048576 个“样本×频率点”组合;如果连续处理许多数据帧,这个代价会很快成为瓶颈。
FFT 不是另一种频谱定义,而是更快地计算同一个 DFT。它利用旋转因子的周期性和对称性,避免重复完成本质相同的乘加运算,所以输出频点、频率含义和 DFT 完全一致。
基 2 FFT 如何复用计算
基 2 FFT 先把偶数下标样本和奇数下标样本拆成两个长度为 N/2 的子序列,分别计算子 DFT,再用旋转因子合并。对子问题继续做同样拆分,直到只剩单个样本。若 N=2^m,就只需 m 层分解。
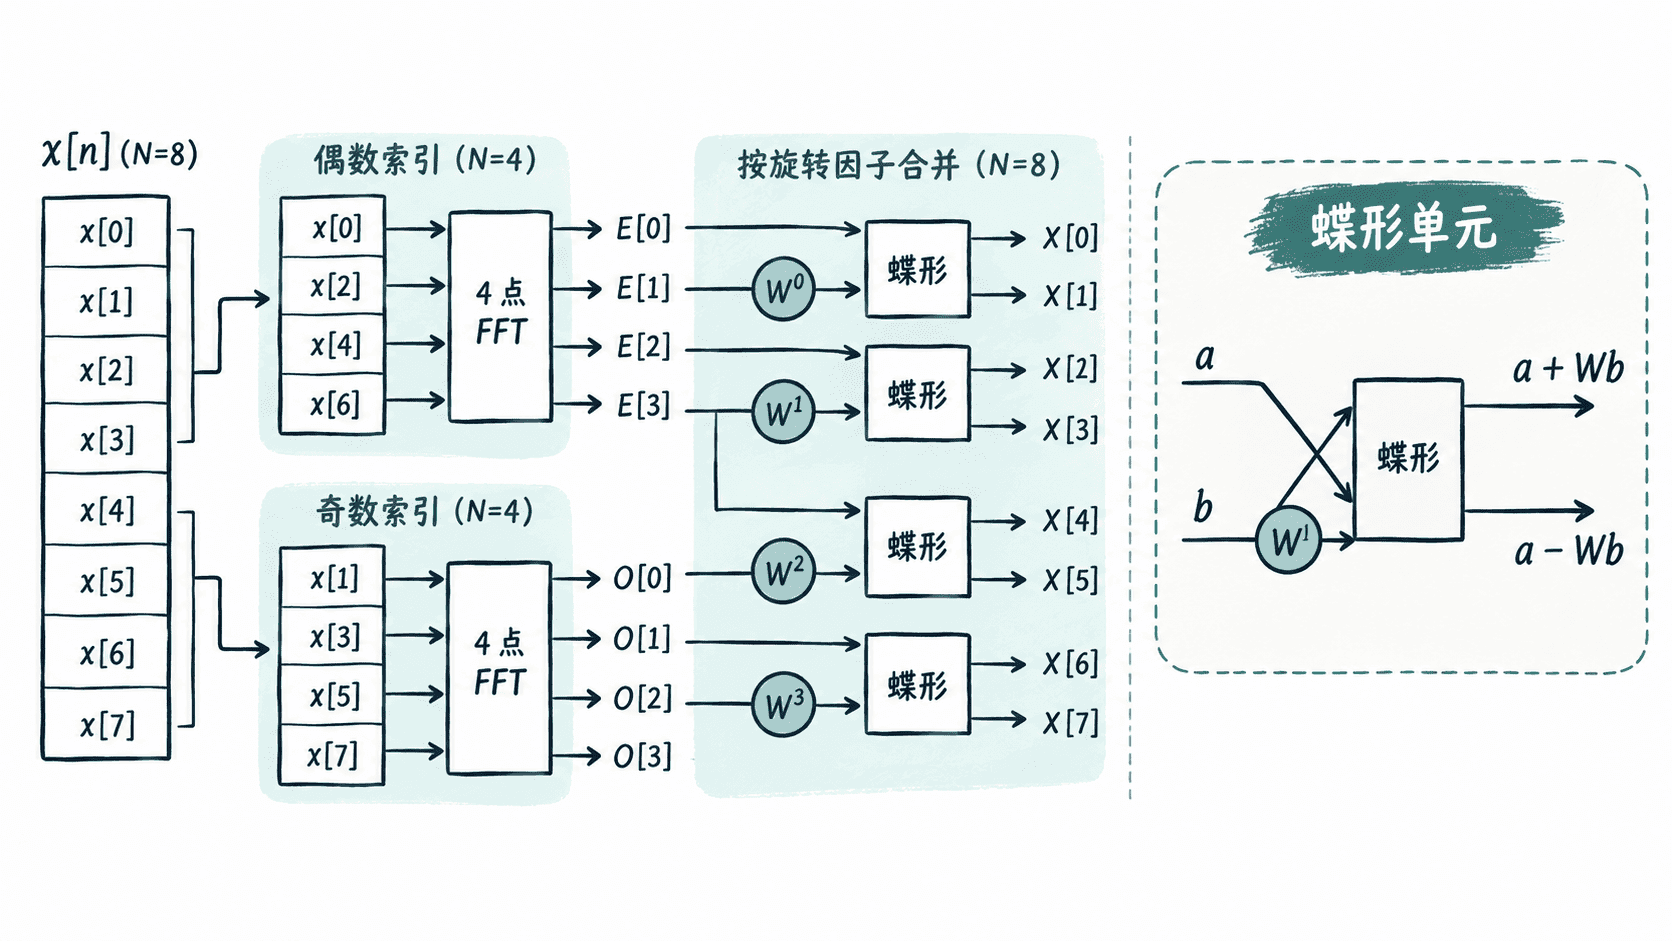
合并阶段最关键的是蝶形运算:同一个子问题结果会同时贡献给两个输出频点,一次乘法结果可以被成对复用。于是每层只需 O(N) 级工作,总层数约为 log₂ N,整体降为 O(N log₂ N)。
用程序验证两种方法
下面用纯 Python 同时实现直接 DFT 和递归基 2 FFT。输入长度为 4,既方便手算,又能完整经过两层偶奇分解。
import cmath
import math

def dft(x):
    n = len(x)
    return [
        sum(x[m] * cmath.exp(-2j * math.pi * k * m / n) for m in range(n))
        for k in range(n)
    ]

def fft_radix2(x):
    n = len(x)
    if n == 1:
        return x
    if n % 2 != 0:
        raise ValueError("radix-2 FFT requires an even length at every stage")

    # 偶、奇下标分别形成两个规模减半的 DFT。
    even = fft_radix2(x[0::2])
    odd = fft_radix2(x[1::2])
    out = [0j] * n

    # 一个旋转后的 odd[k] 同时服务于一对蝶形输出。
    for k in range(n // 2):
        w = cmath.exp(-2j * math.pi * k / n)
        t = w * odd[k]
        out[k] = even[k] + t
        out[k + n // 2] = even[k] - t
    return out

def clean(z):
    return complex(round(z.real, 6), round(z.imag, 6))

x = [1.0, 2.0, 3.0, 4.0]
direct = dft(x)
fast = fft_radix2(x)
print("DFT:", [clean(v) for v in direct])
print("FFT:", [clean(v) for v in fast])
print("same:", max(abs(a - b) for a, b in zip(direct, fast)) < 1e-12)
预期输出
DFT: [(10+0j), (-2+2j), (-2+0j), (-2-2j)]
FFT: [(10+0j), (-2+2j), (-2+0j), (-2-2j)]
same: True
浮点运算可能在末位产生极小误差,因此验证时比较容差,而不是要求复数逐位完全相等。这里两种算法得到的是同一个 DFT,只是计算路径不同。
选择 FFT 长度时要注意什么
基 2 推导最适合解释 FFT,因为 N 为 2 的幂时可以一直二分。不过工程中的 FFT 库通常还支持混合基数或其他算法,输入长度并非必须强制补成 2 的幂。补零有时能让实现更高效,也能让频谱采样网格更密,但不会凭空提高原始数据的真实频率分辨率。
当 N 很小时,函数调用和数据搬运等固定开销可能让速度差异不明显;当 N 增大或同样长度的变换被重复执行时,O(N log₂ N) 的优势才会迅速显现。判断 FFT 是否“更准确”是误区:它的核心价值是以更少运算得到同一个 DFT。