
自动控制 / 系统课时
建立滤波前的误差评估基线
建立滤波前的误差评估基线
滤波后的曲线更平滑,并不保证位置估计更准确。本篇先生成一组可复现的位置测量,画出真值、测量值和逐点误差,再计算均方根误差,得到后续滤波必须使用同一份数据来比较的基线。
学习目标
- 在同一时间轴上绘制真实位置、带噪测量和测量误差。
- 计算位置 RMSE 与平均误差,解释两者为何不能互相替代。
- 固定数据、单位与评分区间,建立可重复使用的比较规则。
固定同一时刻的真值与测量
设小车从 2.0 m 处出发,以 0.8 m/s 匀速运动。每隔 0.1 s 采样一次,从 0 s 到 10 s,共 101 点,包含首尾两个时刻。真实位置为 ,测量为 。
本例假设各次测量噪声相互独立,服从均值为 0、标准差为 0.5 m 的高斯分布。未滤波基线就是直接把 当作位置估计。仿真器提供的真实位置只用于造数据和评分,后续估计器不能把它当作观测输入。
计算前必须按时间戳配对,并统一为米。本例若把测量与相邻一拍的真值错配,0.1 s 的时间偏差就会引入 0.08 m 的位置差。数组长度相等并不能证明时间已经对齐。
用 RMSE 衡量整段误差
定义测量误差为“测量减真值”:正值表示位置读数偏大,负值表示偏小。对全部 个样本先平方、再平均、最后开平方:
RMSE 的单位仍是米,数值越小,表示这组样本的总体位置误差越小。这里分母使用样本数 ,不使用估计无偏方差时常见的 ;也不要先去掉误差均值,否则会掩盖持续偏差。
平均误差用来观察整体偏大还是偏小,不能替代 RMSE。例如两个误差为 −0.5 m 和 +0.5 m,平均误差为 0,RMSE 却是 0.5 m。正负抵消并没有让任何一次测量变准确。
运行可复现的基线脚本
示例按 Python 3.12、NumPy 2.3.5 和 Matplotlib 3.10.8 验证。先在终端安装依赖并检查版本:
# 将依赖安装与版本检查绑定到同一个 Python 解释器。
python -m pip install --quiet numpy==2.3.5 matplotlib==3.10.8
python -c "import numpy, matplotlib; print(numpy.__version__, matplotlib.__version__)"
预期输出(安装成功后,版本检查命令输出如下;安装器提示可能因环境不同而变化):
2.3.5 3.10.8Generator.normal 的 scale 接收标准差,因此应传入 0.5;方差 0.25 不能直接填到这里。genui{"citation":{"ref":"turn2view0"}}
将下面代码保存为 baseline.py,在有图形界面的环境用 python baseline.py 运行,也可整段放入支持绘图的 Notebook。程序采用英文坐标标签,避免额外配置中文字体。
import numpy as np
import matplotlib.pyplot as plt

# 真值只用于生成仿真和离线评分,不作为估计器输入。
dt, n, sigma = 0.1, 101, 0.5
t = np.arange(n) * dt
p_true = 2.0 + 0.8 * t
rng = np.random.default_rng(2026)
z = p_true + rng.normal(loc=0.0, scale=sigma, size=n)

# 避免一维数组与列向量相减时意外广播为矩阵。
assert t.shape == p_true.shape == z.shape == (n,)
assert np.all(np.isfinite(z))
error = z - p_true
bias = np.mean(error)
rmse = np.sqrt(np.mean(error ** 2))

print(f"samples = {n}, dt = {dt:.1f} s")
print(f"mean_error = {bias:.4f} m")
print(f"measurement_RMSE = {rmse:.4f} m")

# 分开画位置与误差,避免运动趋势掩盖噪声;英文标签免配中文字体。
fig, axes = plt.subplots(2, 1, sharex=True, figsize=(9.6, 5.4))
axes[0].plot(t, p_true, color="#168C8C", linewidth=2, label="Truth")
axes[0].plot(t, z, ".", color="#DE8A3C", markersize=4, label="Measurement")
axes[0].set_ylabel("Position (m)")
axes[0].legend()

axes[1].plot(t, error, color="#DE8A3C", linewidth=1, label="z - truth")
axes[1].axhline(0.0, color="#34495E", linestyle="--", linewidth=1)
axes[1].set_ylabel("Error (m)")
axes[1].set_xlabel("Time (s)")
axes[1].legend()
for ax in axes:
    ax.set_xlim(0.0, 10.0)
    ax.grid(alpha=0.25)
fig.tight_layout()
plt.show()
预期输出:
samples = 101, dt = 0.1 s
mean_error = 0.0126 m
measurement_RMSE = 0.5165 m同时显示上下两幅图:上图为真实位置和测量散点,下图为测量误差与零线。sharex=True 让两图共享时间坐标,便于逐点对应。genui{"citation":{"ref":"turn2view1"}}
这次平均误差仅为 0.0126 m,但 RMSE 为 0.5165 m。有限样本的 RMSE 不必恰好等于设定的噪声标准差 0.5 m;本例计算的是这一组实际抽样得到的误差。
从两幅图核对误差
先看上图是否从 2 m 附近运动到 10 m 附近,再看下图是否围绕零线波动。位置整体跨度为 8 m,直接叠图容易低估噪声;独立的误差坐标能显示读数究竟偏离了多少。
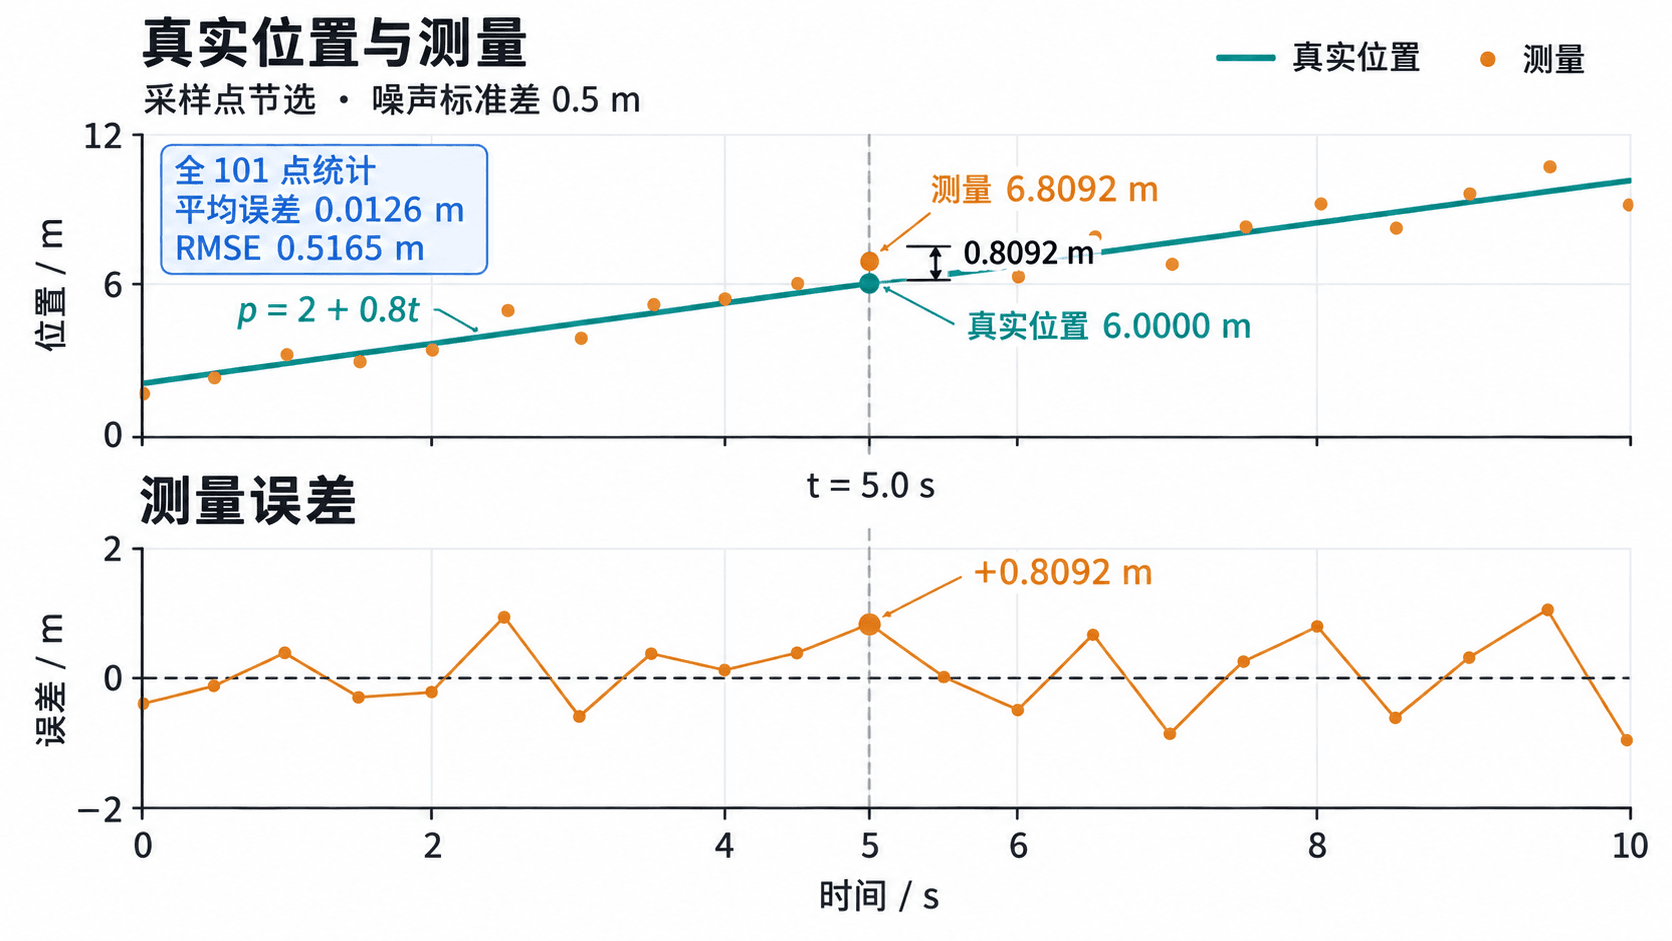
取程序中第 51 个样本,即索引 50:时间为 5.0 s,真值为 6.0000 m,测量约为 6.8092 m,因此误差约为 +0.8092 m。上图两者的竖直差,应与下图该时刻的误差一致;图中 RMSE 是整段统计值。
把 sigma 改为 0.0 后重跑,预期结果是平均误差和 RMSE 均为 0.0000 m,测量点落在真值线上,误差曲线贴着零线。若不满足,优先检查相减对象与时间配对;完成后恢复 sigma=0.5。
把基线用于后续公平比较
本次基线记录为:采样间隔 0.1 s、样本数 101、评分范围 0~10 s、随机种子 2026、位置 RMSE 0.5165 m。后续在同一份 t、p_true、z 上增加滤波器,按相同公式计算“估计位置减真实位置”的误差。
例如某滤波器在这组数据上得到 0.3000 m 的位置 RMSE,相比基线约下降 41.9%。这是比较方法的算例,并非本程序已经产生的滤波结果;仅有曲线更平滑,还不足以给出这个结论。
- 使用同一组测量与同一评分区间;若另报初始化后的指标,例如 2~10 s,原始测量与滤波结果都要在该区间重新评分,并保留全段结果。
- 缺失样本使用共同的有效样本集合,报告剩余点数,不能分别删除各自误差较大的点。
- 位置 RMSE 用米,速度 RMSE 用米每秒,分别报告;本课只建立位置测量基线。
固定种子还需配合固定的 NumPy 环境与抽样调用顺序,不能把同一种子理解成跨版本、跨环境的绝对复现保证。后续比较直接复用已生成的测量数组最明确。genui{"citation":{"ref":"turn2view2"}}
这里的测量误差需要真值。真实设备没有可靠参考位置时,不能把“测量减滤波预测”冒充真实误差;后者通常称为创新。先有时间对齐、精度已知的参考数据,才有可解释的位置 RMSE。