
自动控制 / 系统课时
用 RMSE 和置信区间检验结果
用 RMSE 和置信区间检验结果
本篇把“曲线看起来更平滑”变成可检验的结果:用完整仿真分别计算位置和速度的 RMSE,再从后验协方差画出逐时刻区间,判断估计误差是否与滤波器报告的不确定性相称。
学习目标
- 分别计算位置、速度的 RMSE,并比较位置测量与位置估计的误差。
- 用后验协方差生成约 95% 的逐时刻区间,绘制位置和速度对照图。
- 结合覆盖率与区间宽度,识别过度自信和过于保守的估计。
计算 RMSE 前先对齐数据
状态顺序固定为位置、速度。真值 truth 和更新后的估计 estimate 都取形状 (N, 2),第 0 列单位为 m,第 1 列单位为 m/s;covariance 的形状为 (N, 2, 2),保存同一次更新后的协方差。
对每个分量单独计算均方根误差。以位置为例, 表示使用第 次测量更新后的估计:
速度用相同公式替换位置分量。误差为 0.3 m 和 −0.4 m 时,位置 RMSE 约为 0.354 m;先平方再平均可避免正负抵消。代码中的 axis=0 保留两个分量,不能把 m 与 m/s 混成一个数字。
位置基线用原始测量与位置真值比较;速度估计直接与速度真值比较,不能拿位置读数充当速度基线。本例评价 0~20 s 的全部 201 个时刻,包括初始化阶段;比较其他方案时也必须使用这组时刻。
从后验协方差得到区间
在线性高斯模型、噪声参数和初始先验设置正确时,滤波后验是高斯分布。结合标准正态分布分位数,可用均值加减 1.96 倍标准差构造约 95% 的区间。genui{"citation":{"refs":["turn3view0","turn2view1"]}}
速度区间同理。例如位置估计为 9.8 m、位置方差为 0.04 m²,标准差为 0.2 m,区间为 [9.408, 10.192] m。这里使用方差的平方根,不直接用方差,也不额外除以样本数的平方根。
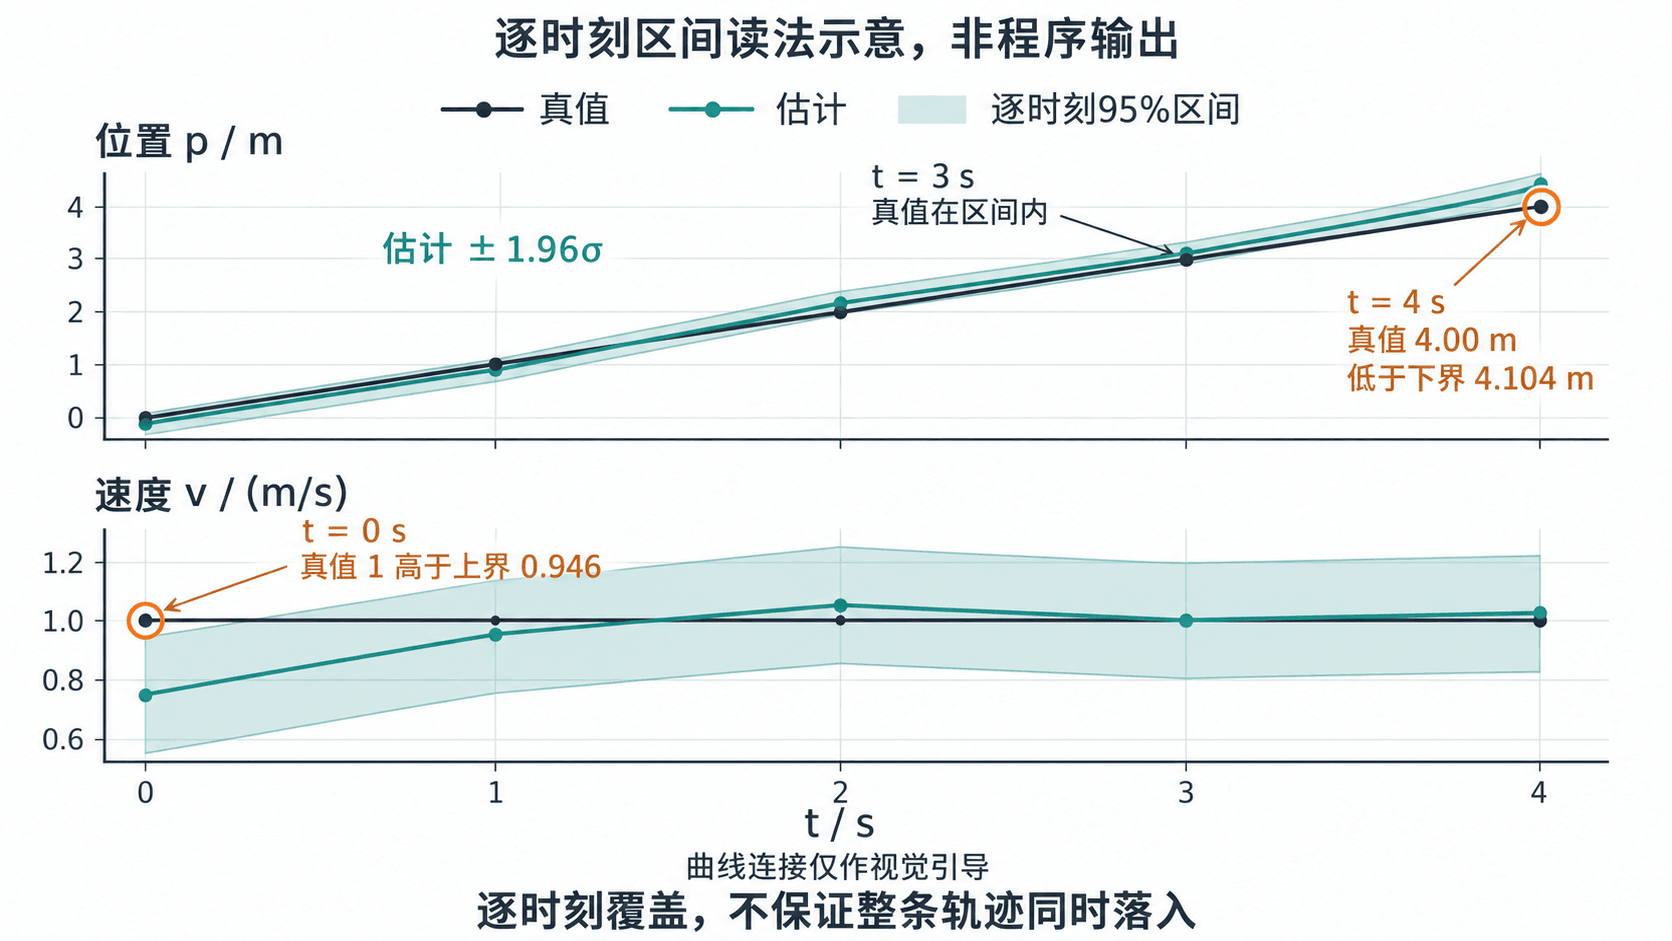
本课的“置信区间”具体指每个时刻、每个状态分量的边际后验区间。它不保证整条轨迹同时落入带内,也不保证位置与速度同时落入各自区间的概率恰为 95%。位置区间描述真实位置的不确定性,不要求带噪测量点全部落入。
下图用少量采样点说明区间读法;后面的程序会根据完整仿真生成自己的位置、速度轨迹图。
运行完整仿真与评估
在已安装 NumPy、Matplotlib 的 Python 环境中完整运行以下代码。示例已在 Python 3.12、NumPy 2.3.5、Matplotlib 3.10.8 核对;绘图标签使用英文,避免依赖中文字体。
每 0.1 s 采样一次。每个间隔内的随机加速度保持不变,各间隔独立,标准差为 0.5 m/s²;位置测量噪声标准差为 1 m。过程噪声按 构造,,测量方差为 。
初始先验均值为位置 0 m、速度 1 m/s,两个分量的标准差分别为 1 m、0.5 m/s。真值从这个先验抽取,过程噪声与测量噪声独立生成;滤波循环只读取测量,不读取真值。
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
dt, n = 0.1, 201
t = np.arange(n) * dt
F = np.array([[1.0, dt], [0.0, 1.0]])
h = np.array([1.0, 0.0])
g = np.array([0.5 * dt**2, dt])
sigma_a, sigma_z = 0.5, 1.0
Q = sigma_a**2 * np.outer(g, g)
R = sigma_z**2
x = np.array([0.0, 1.0])
P = np.diag([1.0, 0.25])
I = np.eye(2)

# 仿真真值只供评分;初始状态也从指定先验抽取。
truth = np.empty((n, 2))
truth[0] = x + np.sqrt(np.diag(P)) * rng.normal(size=2)
for k in range(1, n):
    truth[k] = F @ truth[k - 1] + g * rng.normal(0.0, sigma_a)
z = truth[:, 0] + rng.normal(0.0, sigma_z, size=n)

estimate = np.empty((n, 2))
covariance = np.empty((n, 2, 2))
for k in range(n):
    # 第 0 拍直接更新;其后先预测,再吸收同一时刻的测量。
    if k > 0:
        x = F @ x
        P = F @ P @ F.T + Q
    S = h @ P @ h + R
    K = (P @ h) / S
    x = x + K * (z[k] - h @ x)
    # Joseph 形式更新后验协方差,并去除浮点运算的不对称。
    A = I - np.outer(K, h)
    P = A @ P @ A.T + R * np.outer(K, K)
    P = (P + P.T) / 2
    estimate[k], covariance[k] = x, P

# 同一索引下按列评分:第 0 列位置,第 1 列速度。
error = estimate - truth
rmse = np.sqrt(np.mean(error**2, axis=0))
raw_rmse = np.sqrt(np.mean((z - truth[:, 0])**2))
variance = np.diagonal(covariance, axis1=1, axis2=2)
if not np.all(np.isfinite(covariance)):
    raise ValueError("Covariance contains non-finite values")
if np.min(np.linalg.eigvalsh(covariance)) < -1e-10:
    raise ValueError("Covariance is not positive semidefinite")
# 仅容忍已通过检查的浮点级负数,不能用截断掩盖错误的 P。
sigma = np.sqrt(np.maximum(variance, 0.0))
half_width = 1.96 * sigma
lower, upper = estimate - half_width, estimate + half_width
coverage = np.mean(np.abs(error) <= half_width, axis=0)
mean_width = np.mean(2 * half_width, axis=0)

print(f"position measurement RMSE = {raw_rmse:.3f} m")
print(f"position filter RMSE = {rmse[0]:.3f} m")
print(f"velocity filter RMSE = {rmse[1]:.3f} m/s")
print(f"position coverage = {coverage[0]:.1%}")
print(f"velocity coverage = {coverage[1]:.1%}")
print(f"position mean width = {mean_width[0]:.3f} m")
print(f"velocity mean width = {mean_width[1]:.3f} m/s")

# 两个状态分量共用时间轴,但各自保留单位和区间。
fig, axes = plt.subplots(2, 1, sharex=True, figsize=(10, 6))
for j, ax in enumerate(axes):
    ax.fill_between(t, lower[:, j], upper[:, j],
                    color="#2A9D8F", alpha=0.20, label="95% pointwise interval")
    ax.plot(t, truth[:, j], color="#243746", label="truth")
    ax.plot(t, estimate[:, j], color="#2A9D8F", label="estimate")
    ax.set_ylabel(["position (m)", "velocity (m/s)"][j])
    ax.grid(alpha=0.2)
axes[0].scatter(t, z, s=8, color="#E79B50", alpha=0.5, label="measurement")
for ax in axes:
    ax.legend(loc="best")
axes[1].set_xlabel("time (s)")
fig.tight_layout()
plt.show()
预期输出:
position measurement RMSE = 1.011 m
position filter RMSE = 0.313 m
velocity filter RMSE = 0.256 m/s
position coverage = 93.0%
velocity coverage = 94.0%
position mean width = 1.269 m
velocity mean width = 0.968 m/s同时显示上下两幅共享时间轴的图:深蓝灰是真值,青绿线是估计,浅青绿带是区间,橙点只出现在位置图中。plt.show() 需要支持图形窗口或内嵌绘图的环境。更换随机种子后,数值与曲线会改变。
np.diagonal 指定两个矩阵轴后得到形状为 (N, 2) 的方差数组;fill_between 填充上下界之间的区域,连线不代表额外计算了采样间的区间。genui{"citation":{"refs":["turn1view0","turn3view1"]}}
同时检查误差、覆盖率与宽度
本次位置 RMSE 从 1.011 m 降至 0.313 m,下降约 69%;速度 RMSE 为 0.256 m/s。该结论只对应这次轨迹与评价窗口,不能推出所有噪声样本都改善相同比例。
覆盖率统计真值落入对应区间的时刻比例。代码的布尔比较沿时间轴取平均,得到位置 93.0%、速度 94.0%;平均区间宽度分别为 1.269 m、0.968 m/s。宽度指上界减下界,等于半宽的两倍。
RMSE 小不能单独证明协方差可信。仍以估计 9.8 m、真值 10.0 m 为例:标准差 0.2 m 时真值在区间内;若把标准差缩成 0.05 m,区间变为 [9.702, 9.898] m,真值落在外面,但估计误差完全没变。
越界时按什么顺序排查
单条轨迹的相邻误差相关,201 个时刻不能直接视为 201 次独立覆盖试验。因此 93.0% 或 94.0% 本身不足以判定错误,也不必调整参数直到某次结果恰为 95%。
| 观察到的现象 | 先检查什么 |
|---|---|
| 曲线持续错开、RMSE 明显增大 | 检查时间戳、采样间隔、状态分量顺序及观测偏置 |
| 多次试验覆盖偏低,区间偏窄 | 检查是否低估过程噪声、测量噪声或初始不确定性,以及模型是否失配 |
| 覆盖很高但区间很宽 | 检查不确定性是否高估,同时比较 RMSE,不能只奖励高覆盖率 |
要加强检验,可保持参数不变,用种子 0~99 重新生成 100 条独立轨迹;每次重置初值与协方差,在固定的 10 s 时刻跨轨迹统计覆盖,再比较各次 RMSE。用于调参的轨迹与最终验收轨迹应分开。
程序对本例尺度下小于 −1e−10 的协方差特征值直接报错,只容忍浮点级误差,不能用绝对值掩盖负方差。实际设备若没有可信参考真值,就不能直接计算这里的状态 RMSE 和覆盖率;带噪测量不能替代真值。