
自动控制 / 系统课时
用新息序列识别模型失配
用新息序列识别模型失配
轨迹看起来平滑,仍可能长期追不上真实运动。本篇把更新前的新息按时间记录,用均值和滞后相关检查遗漏加速度、时间错位等问题,并在同一组位置读数上验证修正是否有效。
学习目标
- 正确记录更新前的新息及其方差,计算标准化新息。
- 用均值、方差和前五阶自相关区分偏差、尺度异常与时间结构。
- 对比遗漏和补上已知加速度输入的结果,说明诊断的适用边界。
在更新前记录预测误差
以每 0.1 s 测量一次位置的滤波器为例,状态为 ,观测矩阵为 。 和 是尚未使用本次读数的预测状态与预测协方差,位置测量为 ,测量噪声方差为 。
是新息, 是模型预计的新息方差。例如预测位置为 10.0 m、读数为 11.2 m、预测位置方差为 0.64 m²、 m²,则新息为 1.2 m,新息方差为 1.00 m²。
每拍先预测,再记录时间戳、新息与 ,最后更新状态。不能拿 代替新息:后验状态已经用过本次读数,较小的后验残差不能证明预测模型匹配。genui{"citation":{"ref":"turn4view0"}}
分开检查偏差、尺度与相关性
单个位置观测的标准化新息为 ,没有单位。上面的算例得到 。当线性模型、初始分布和噪声协方差匹配,且过程与测量噪声均为零均值白噪声、彼此及与初始状态不相关时,理论上 均值为 0、方差为 1,不同时刻不相关。genui{"citation":{"ref":"turn5view0"}}
| 检查量 | 参考特征 | 需要警惕的现象 |
|---|---|---|
| 均值 | 接近 0 | 长时间同号;不同运动段的偏差被整体平均抵消 |
| 样本方差 | 接近 1 | 偏差去除后,波动仍与预计不确定性不相称 |
| 非零滞后自相关 | 接近 0 | 连续几个滞后较大,说明误差中仍有时间结构 |
先单独报告均值 ,再用去均值后的序列计算自相关。否则持续偏差也会被误当成额外的时间相关。对保留的 个样本,采用:
本例看 ,对应 0.1~0.5 s 的间隔;零阶相关恒为 1,不用于白性判断。独立白噪声假设下,大样本的逐滞后近似 95% 参考带为 , 时约为 ±0.069。它不是整组检验的 95% 保证,单个越界不能直接判错,参数应在验证前固定。genui{"citation":{"ref":"turn5view1"}}
复现遗漏加速度的诊断
下面的完整脚本使用 Python 3.12、NumPy 2.3.5,模拟 1000 次采样。已知加速度输入为 m/s²;另有标准差 0.08 m/s² 的随机加速度扰动,位置测量噪声标准差为 0.5 m。
每段随机加速度保持恒定,段与段独立,因此 、, m²。循环先传播运动,再生成读数;代码的第 次循环对应 ,输入作用于此前的采样区间。
两个滤波器使用相同读数、初值和噪声参数,只改变是否加入已知输入。完整日志保留在 logs 中,每行依次是时间、新息、新息方差、标准化新息。统计排除前 200 拍初始化暂态;这一长度仅用于本例。
import numpy as np

rng = np.random.default_rng(2026)
dt, count, warmup = 0.1, 1000, 200
F = np.array([[1.0, dt], [0.0, 1.0]])
B = np.array([0.5 * dt**2, dt])
H = np.array([1.0, 0.0])
sigma_a, sigma_z = 0.08, 0.5
# 每段加速度扰动恒定,段与段独立;不是连续白噪声谱密度模型。
Q = sigma_a**2 * np.outer(B, B)
R = sigma_z**2
u = 0.15 + 0.35 * np.sin(2 * np.pi * np.arange(count) / 200)

# 测量只生成一次,让两个滤波器处理完全相同的数据。
truth = np.array([0.0, 1.0])
z = np.empty(count)
for k in range(count):
    truth = F @ truth + B * (u[k] + rng.normal(0.0, sigma_a))
    z[k] = H @ truth + rng.normal(0.0, sigma_z)

def run(use_input):
    x = np.array([0.0, 1.0])
    P = np.diag([1.0, 1.0])
    log = np.empty((count, 4))
    for k in range(count):
        xp = F @ x + B * (u[k] if use_input else 0.0)
        Pp = F @ P @ F.T + Q
        innovation = float(z[k] - H @ xp)
        S = float(H @ Pp @ H + R)
        # 先保存时间、新息、新息方差、标准化新息,再用当前测量更新。
        log[k] = [(k + 1) * dt, innovation, S, innovation / np.sqrt(S)]
        K = Pp @ H / S
        x = xp + K * innovation
        # Joseph 形式避免简单相减放大协方差的舍入误差。
        A = np.eye(2) - np.outer(K, H)
        P = A @ Pp @ A.T + R * np.outer(K, K)
    return log

def summarize(log):
    e = log[warmup:, 3]
    # 均值单独检查;自相关使用去均值后的序列。
    d = e - e.mean()
    acf = [float(d[lag:] @ d[:-lag] / (d @ d)) for lag in range(1, 6)]
    print(f'N={len(e)}, mean={e.mean():.3f}, var={e.var(ddof=1):.3f}')
    print('acf1..5=' + ', '.join(f'{a:.3f}' for a in acf))
    print(f'pointwise_band=+/-{1.96 / np.sqrt(len(e)):.3f}')

if __name__ == '__main__':
    logs = {'missing_input': run(False), 'with_input': run(True)}
    for label, log in logs.items():
        print(label)
        summarize(log)
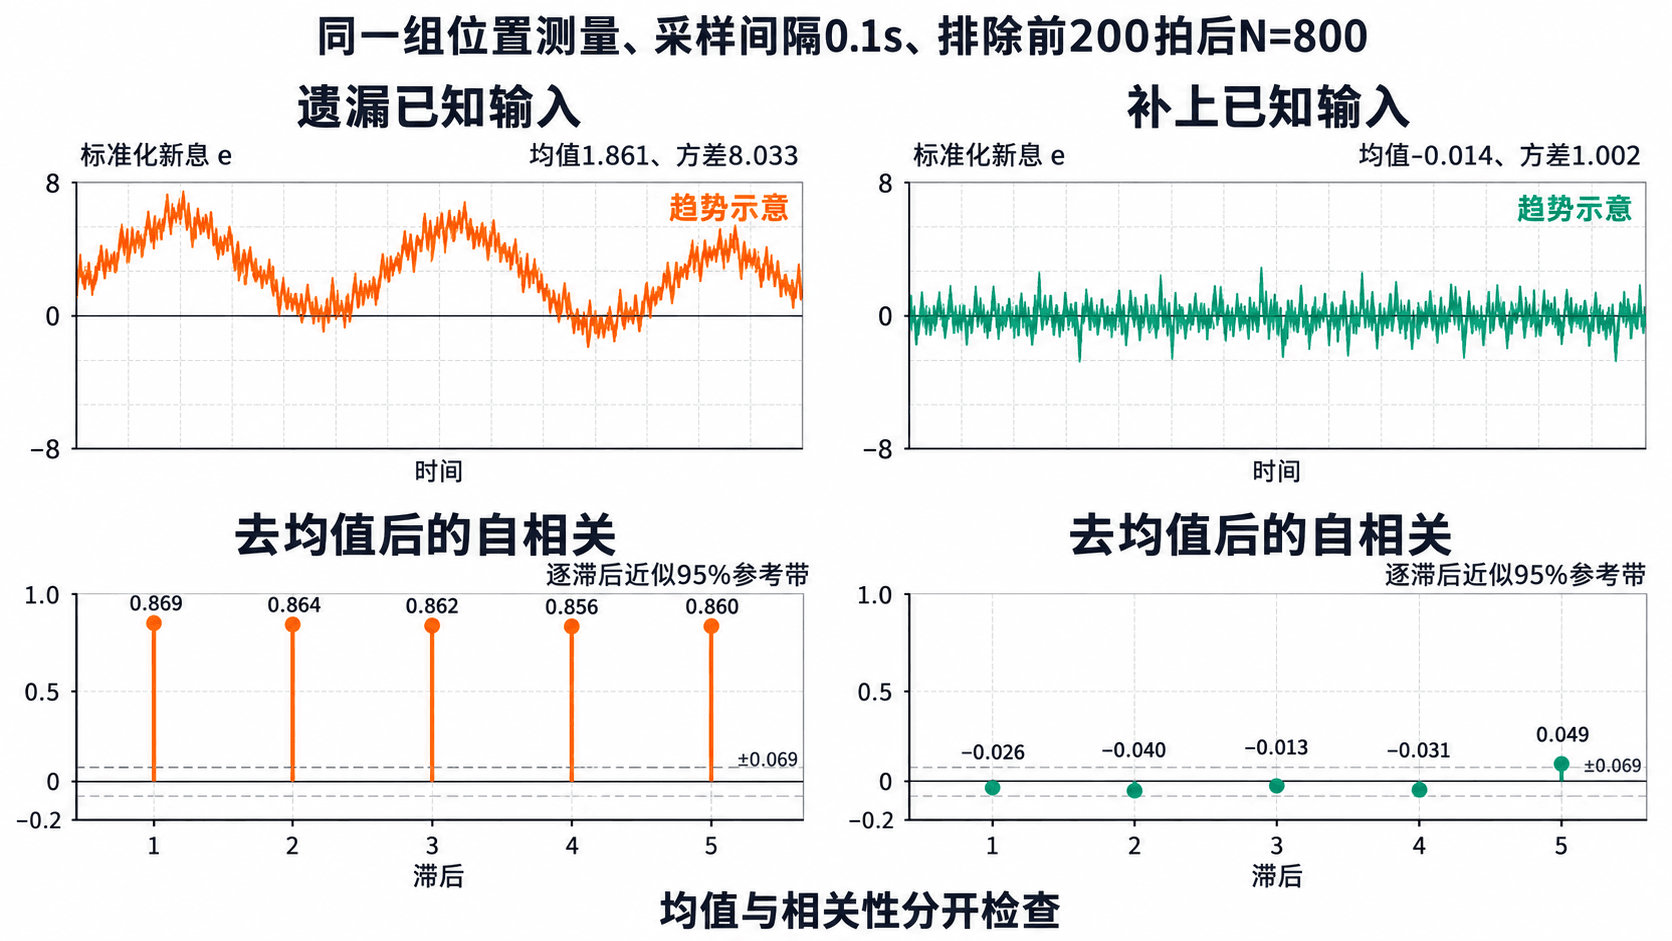
预期输出:
missing_input
N=800, mean=1.861, var=8.033
acf1..5=0.869, 0.864, 0.862, 0.856, 0.860
pointwise_band=+/-0.069
with_input
N=800, mean=-0.014, var=1.002
acf1..5=-0.026, -0.040, -0.013, -0.031, 0.049
pointwise_band=+/-0.069
missing_input 的均值为 1.861,说明预测反复偏低;去均值后的五个相关系数仍约为 0.86,表明误差还有持续的时间结构。with_input 的均值为 -0.014、方差为 1.002,前五阶相关均落在参考带内,支持这次修正。
按现象缩小排查范围
先核对数据顺序和单位:本例相邻时间戳应差 0.1 s,位置使用 m,输入使用 m/s²。真实记录发生丢包时,应按实际间隔重算转移矩阵及对应过程噪声,不能把缺失的几拍当成一次正常采样。
| 观察到的现象 | 优先检查与处理 |
|---|---|
| 新息长期同号,或随加速段偏移 | 对齐时间戳,核对输入是否漏加、方向和单位是否正确;核对观测模型的比例与偏置 |
| 去均值后多个滞后仍明显相关 | 检查遗漏动态、测量延迟、传感器内部平滑造成的相关噪声,以及过程与测量噪声的相对权重 |
| 均值近 0、相关较弱,但方差明显偏离 1 | 核对噪声尺度;用静止标定记录估计测量方差,避免仅凭新息断言一定是 R 错了 |
| 个别巨大尖峰 | 对照原始读数检查离群值、重复消息和丢包后的时间错配 |
本例修复只使用事先已知的 ,没有把真实状态或随机扰动交给滤波器。实际拿不到可靠输入时,应重新选择运动模型,例如增广加速度状态。单纯增大 会改变增益和 ,即使标准化新息变小,也仍须复查偏差和相关性。
用独立记录复查修正
在同一记录上比较两个模型,可以隔离输入项的作用;随后应固定参数,用未参与调参的记录复查均值、方差和多个滞后。初始化阶段的排除长度应事先确定,不能反复剪掉异常区段直到结果好看。独立验证有助于避免对当前记录过拟合。genui{"citation":{"ref":"turn4search1"}}
实际日志还应保留门控拒绝之前的新息,并单独标记异常测量;先删除大新息再统计,会低估异常程度。前五阶检查只覆盖本例的 0.5 s,怀疑更慢周期时,应扩大滞后范围并使用更长记录。
检查通过也不保证绝对位置正确。由 可知,固定偏置 可以被位置估计整体吸收:真实位置 10 m、零偏 2 m 时,滤波器可能稳定估成 12 m,而新息仍接近零。要发现这种误差,需要已知位置标定或独立参考。