
自动控制 / 系统课时
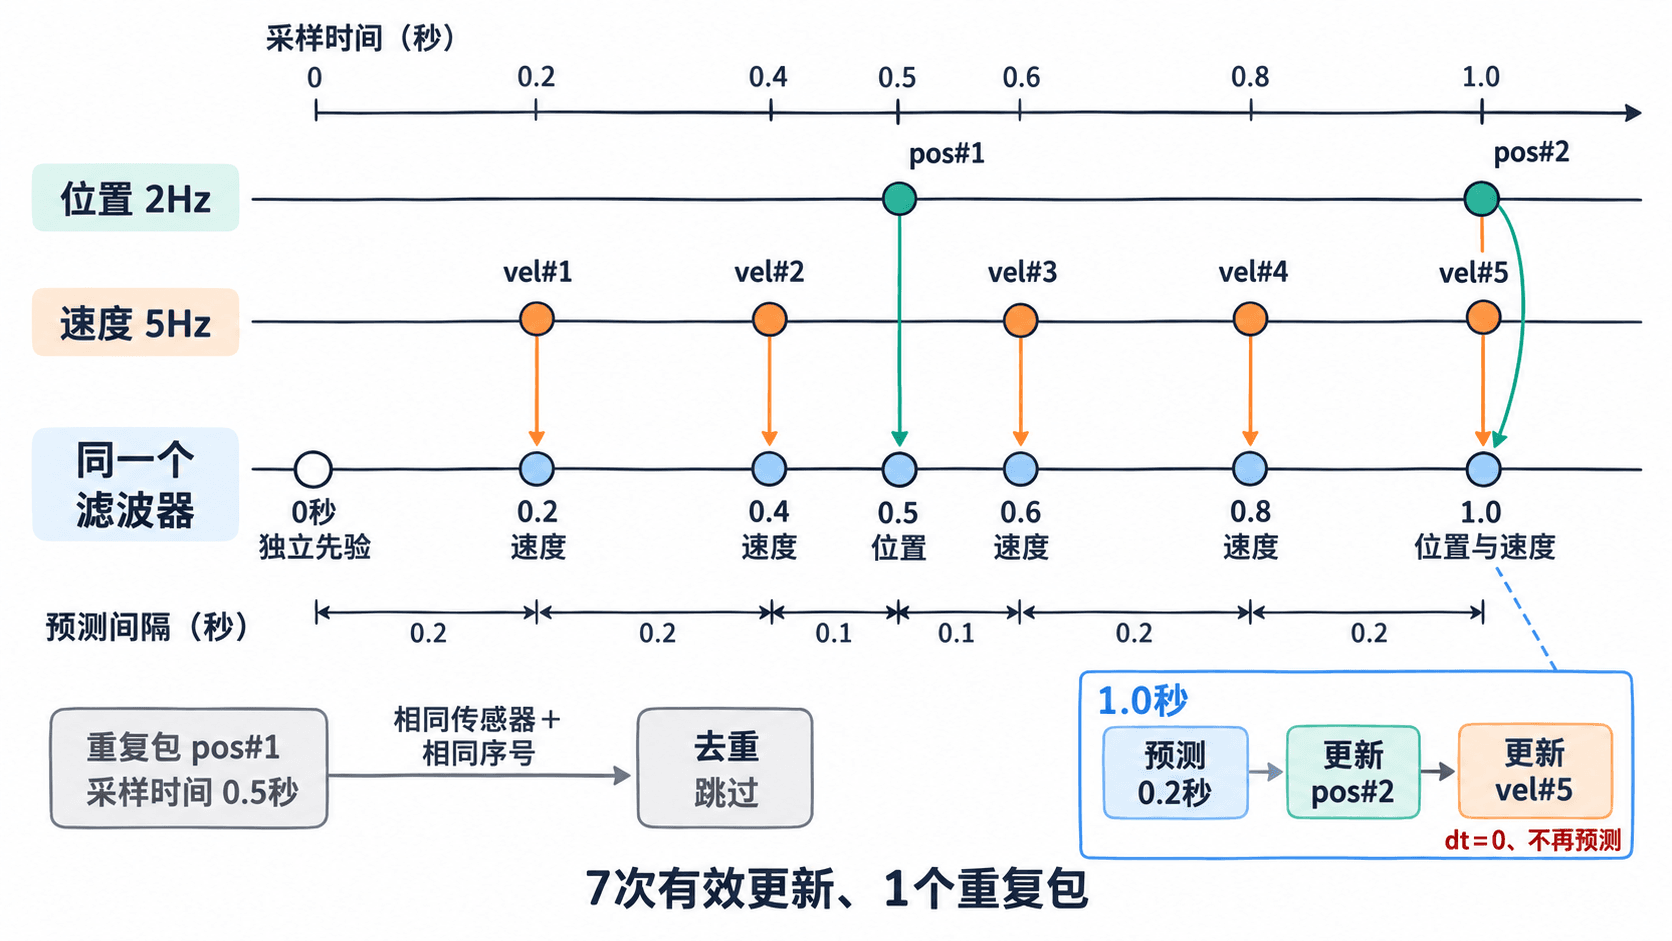
异步传感器如何分时更新状态
异步传感器如何分时更新状态
位置传感器每秒提供两次读数,速度传感器每秒提供五次读数,不必等它们凑齐才能估计运动。本篇把每条新观测当作事件,按采样时间推进同一个滤波器,并用可运行示例验证不同间隔、同刻更新和重复包处理。
学习目标
- 合并 2 Hz 位置与 5 Hz 速度观测,区分采样时间和接收时间。
- 根据实际事件间隔重算预测矩阵,并选择对应的观测模型。
- 用更新计数、时间间隔与协方差检查旧数据是否被重复使用。
用采样时间合并两路事件
状态取 ,位置单位为 m,速度单位为 m/s, 表示状态估计误差协方差。本例假设传感器已统一时钟、位置原点与正方向;测量噪声零均值,跨传感器、跨时刻独立,并与过程扰动独立。
| 传感器 | 采样时刻 / s | 观测矩阵 | 测量噪声方差 |
|---|---|---|---|
| 位置,2 Hz | 0.5、1.0 | m² | |
| 速度,5 Hz | 0.2、0.4、0.6、0.8、1.0 | (m/s)² |
每条事件携带采样时间、传感器标识、样本序号和测量值。时间戳描述测量发生的时刻;例如 0.4 s 的读数在 0.43 s 收到,仍应对应 0.4 s 的状态。每路序号在本次记录内唯一,去重键采用 (sensor, seq)。
位置尚未产生新样本时,只处理新速度样本,不把缓存的位置值再更新一次。 选择的是被观测量;由于位置与速度存在互协方差,一次速度观测也可能同时修正位置。
每个新事件先预测再更新
滤波器保存当前状态时刻,每次取 。例如处理完 0.4 s 的速度后,0.5 s 的位置只需预测 0.1 s,不能照搬位置传感器的 0.5 s 采样周期。
采用匀速均值模型与连续白加速度扰动,不含额外已知控制输入。取谱密度 ,它不是单次加速度误差的方差。对应离散矩阵为:
间隔改变时, 和 都要重算。例如间隔由 0.1 s 增至 0.2 s, 的位置方差项变为原来的 8 倍。这是连续白噪声模型的离散结果,不能与每段恒定随机加速度的离散模型混用。
- 先检查样本是否处理过;重复包直接跳过,不修改状态和时间。
- 对新样本预测到其采样时刻,计算 与 。
- 选择该传感器的 ,计算新息 并更新,然后保存该事件的时间。
同一时刻可以有两条不同的新观测。1.0 s 的位置更新后,速度更新的 ,此时 ,直接用刚得到的后验继续更新。不能因时间相同而丢掉其中一条,也不能再推进一个采样周期。
运行一次完整事件回放
下面是 Python 3.12、NumPy 2.3 环境可直接运行的完整示例。初始时刻为 0 s,估计位置为 0 m、速度为 1 m/s,初始标准差分别为 1 m 和 1 m/s。这个先验未使用列表中的观测;时间和编号均为固定仿真值。
事件以整数毫秒保存,计算时转换成秒。输入顺序故意打乱,并重复放入一个位置样本。代码中的 h 是观测矩阵的一维数组表示,标量新息方差 S 可直接用于除法,协方差采用 Joseph 形式更新。
import numpy as np

# 事件格式:(采样毫秒数, 传感器, 样本序号, 测量值);故意打乱输入。
events = [
    (1000, "pos", 2, 1.10),
    (400, "vel", 2, 0.90),
    (500, "pos", 1, 0.65),
    (200, "vel", 1, 1.10),
    (1000, "vel", 5, 0.95),
    (800, "vel", 4, 1.05),
    (600, "vel", 3, 1.00),
    (500, "pos", 1, 0.65),
]
models = {
    "pos": (np.array([1.0, 0.0]), 0.5**2),
    "vel": (np.array([0.0, 1.0]), 0.2**2),
}
# t=0 的独立先验未使用 events 中任何样本。
x = np.array([0.0, 1.0])
P = np.diag([1.0, 1.0])
q = 0.1
state_ms = 0
seen = set()
updates = duplicates = 0

# 完整记录的离线回放;同一时刻固定按 pos、vel 排序。
for t_ms, sensor, seq, z in sorted(events, key=lambda e: (e[0], e[1])):
    key = (sensor, seq)
    if key in seen:
        duplicates += 1
        continue
    dt = (t_ms - state_ms) / 1000.0
    if dt < 0:
        raise ValueError("late measurement requires separate handling")

    # 用距上次已处理事件的真实间隔传播,dt=0 时不再预测。
    if dt > 0:
        F = np.array([[1.0, dt], [0.0, 1.0]])
        Q = q * np.array([[dt**3 / 3, dt**2 / 2],
                          [dt**2 / 2, dt]])
        x = F @ x
        P = F @ P @ F.T + Q
    h, r = models[sensor]
    ph = P @ h
    S = float(h @ ph + r)
    K = ph / S
    x = x + K * (z - float(h @ x))

    # Joseph 形式更新协方差;h、K、x 都是一维 NumPy 数组。
    A = np.eye(2) - np.outer(K, h)
    P = A @ P @ A.T + r * np.outer(K, K)
    P = (P + P.T) / 2
    state_ms = t_ms
    seen.add(key)
    updates += 1
    print(f"t={t_ms / 1000:.1f} {sensor}#{seq} dt={dt:.1f} "
          f"p={x[0]:.3f} v={x[1]:.3f}")

print(f"updates={updates}, duplicates={duplicates}")
print(f"std_p={np.sqrt(P[0, 0]):.3f}, std_v={np.sqrt(P[1, 1]):.3f}")
预期输出:
t=0.2 vel#1 dt=0.2 p=0.219 v=1.096
t=0.4 vel#2 dt=0.2 p=0.404 v=0.980
t=0.5 pos#1 dt=0.1 p=0.620 v=0.981
t=0.6 vel#3 dt=0.1 p=0.720 v=0.991
t=0.8 vel#4 dt=0.2 p=0.925 v=1.021
t=1.0 pos#2 dt=0.2 p=1.116 v=1.020
t=1.0 vel#5 dt=0.0 p=1.111 v=0.985
updates=7, duplicates=1
std_p=0.335, std_v=0.141
检查时间、次数与旧值复用
- 8 条输入只有 7 条不同样本,因此输出应为
updates=7, duplicates=1。位置序号 1 和速度序号 1 属于不同样本。 - 0.5 s 那一行必须是
dt=0.1;1.0 s 的第二行必须是dt=0.0,但仍执行一次速度更新。 - 末行给出估计标准差,单位分别为 m 和 m/s;它们来自协方差对角元的平方根,不是估计值与真值的实际误差。
重复使用旧值会制造虚假的高置信度。以静止标量位置为例,先验方差为 1 m²、测量方差为 0.25 m²,一次更新的后验方差为 m²;若把同一观测误当成五次独立观测,便会虚假降至 m²。
可再向列表追加一次 (500, "pos", 1, 0.65):预期仅 duplicates 变为 2,全部状态输出和最终标准差保持不变。整个回放包含 条输入时,排序开销为 ;本例固定二维状态,每次更新的矩阵计算规模不随样本数增长,去重集合占用 空间。
处理实时迟到和相关观测
完整列表排序适合离线回放,实时系统必须先处理尚未到齐的事件。若已确认时钟同步且端到端延迟不超过 30 ms,可设置 50 ms 重排窗口,按时间消费不晚于当前公共时钟减 50 ms 的缓存事件;这会引入相应输出延迟。
若状态已到 1.0 s,才收到采样于 0.7 s 的旧包,应记录并丢弃,或恢复其采样时刻之前的历史状态、插入该包,再按序重放后续事件。不能直接用负间隔预测,也不能用 max(dt, 0) 把旧测量冒充当前测量。乱序观测需要专门处理。
在线性且测量噪声独立的前提下,同刻两路观测依次更新与联合更新等价;交换顺序只会带来浮点舍入差异。若速度由同一位置序列差分得到,两路及跨时刻误差可能相关,不能直接套用本例的独立噪声假设。
没有新观测时可以只做预测。若界面需要 100 Hz 刷新,可对当前后验的副本外推到显示时刻,保留原测量事件的时间游标;显示结果不作为新观测回灌。这样估计可以持续显示,每条传感器样本仍只提供一次信息。